Hanayo: Harnessing Wave-like Pipeline Parallelism for Enhanced Large Model
波形流水线并行策略,提升大模型训练效率
Hanayo: Harnessing Wave-like Pipeline Parallelism for Enhanced Large Model Training Efficiency
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Hanayo: Harnessing Wave-like Pipeline Parallelism for Enhanced Large Model Training Efficiency |
| 作者 | Ziming Liu, Shenggan Cheng, Haotian Zhou, Yang You |
| 机构 | National University of Singapore (NUS) |
| 论文 | arXiv:2308.15762 |
| 会议 | SC’23 (The International Conference for High Performance Computing, Networking, Storage and Analysis) |
| 发布 | 2023年8月30日 |
| 主题 | cs.DC (分布式、并行与集群计算) |
二、核心思想
问题定义
大规模语言模型训练面临四大挑战:
- 内存墙 (Memory Wall): 模型参数规模远超单加速器存储容量
- 扩展墙 (Scaling Wall): 训练需要数千加速器,复杂并行模式和大量通信导致瓶颈
- 计算墙 (Computational Wall): 大模型和海量数据需要巨大算力
- 开发墙 (Development Wall): 复杂的并行策略和手动通信控制使开发极其困难
现有流水线并行方法的局限:
- GPipe: 简单高效,但激活内存消耗高,气泡率高
- DAPPLE (1F1B): 降低内存消耗,但气泡率仍然较高
- Chimera: 双向流水线实现低气泡率,但需要模型副本(2倍内存开销)
解决方案概述
Hanayo 提出波形流水线并行策略:
- 通过让单条流水线在计算过程中改变方向,形成波浪形流水线
- 无需模型副本即可获得低气泡率
- 通过增加波数(waves)持续降低气泡率
- 统一框架支持所有主流流水线并行算法
核心性能
| 指标 | 数值 |
|---|---|
| 吞吐量提升 | 最高 30.4% vs Chimera (SOTA) |
| 内存消耗 | 与主流方法持平或更低,无需模型副本 |
| 气泡率 | 随波数增加急剧下降 |
| 测试规模 | 4个计算集群,最多32 GPU,GPT/BERT架构 |
三、技术架构
流水线并行方法对比
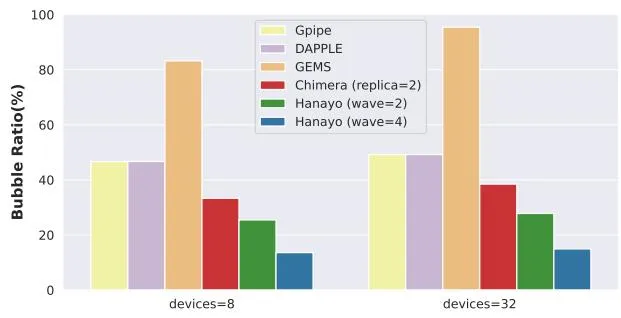
Figure 1: 同步流水线方案的理论气泡率。Hanayo 随波数增加气泡率急剧下降。
| 方案 | 气泡率 | 权重内存 | 激活内存 |
|---|---|---|---|
| GPipe | |||
| DAPPLE | |||
| Chimera (2副本) | 含 | ||
| Hanayo | 见公式(1) |
核心公式
Hanayo 气泡率公式:
\text{Bubble Ratio} = \frac{\frac{1}{W}T_B + (1 + 2W + \frac{2}{P} + \frac{P-2}{3})T_C}{\frac{P}{P-1}T_F + (\frac{1}{2W} + \frac{P}{P-1})T_B + (\frac{P-2}{2} + 4W)T_C} \tag{1}
其中:
- = 波数(waves)
- = 流水线 worker 数
- = 前向传播时间(除以 P)
- = 反向传播时间(除以 P)
- = 单次 P2P 通信时间
简化分析: 假设 且忽略 ,气泡率简化为 ,随波数 增加而急剧下降。
波形流水线转换
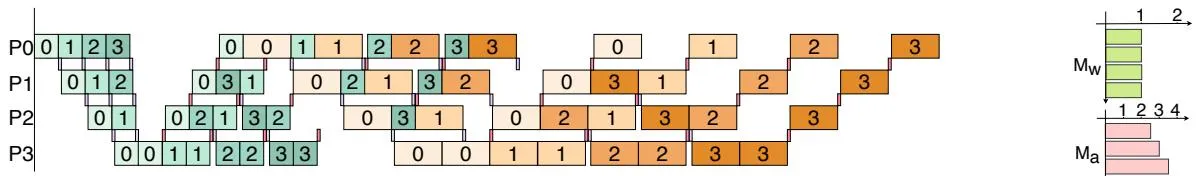
Figure 3(d): 单波 Hanayo 流水线。通过将 Chimera 双向流水线中的计算块交换到对称位置,消除模型副本需求。
关键洞察:
- Chimera 的高效源于双向流水线互相填补气泡
- 但双向流水线需要存储两份模型参数
- Hanayo 让单条流水线改变方向,形成波浪形
- 将 Chimera 的模型副本转化为标准数据并行
增加波数降低气泡率
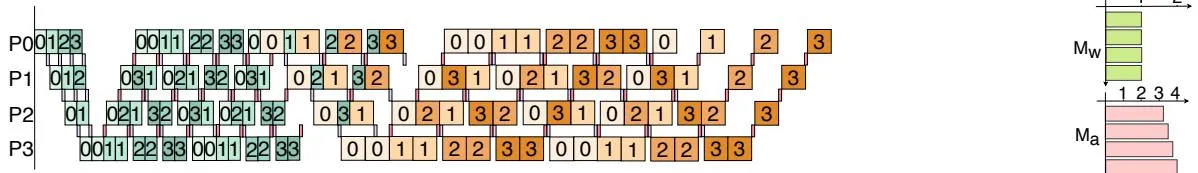
Figure 3(e): 双波 Hanayo。阶段数从 8 增加到 16,所有气泡大小减半。
波数扩展:
- 1 波: 阶段数 = 2P
- 2 波: 阶段数 = 4P,气泡大小减半
- 4 波: 阶段数 = 8P,气泡大小再减半
- 只要单阶段有足够层可分割,即可继续增加波数
气泡类型分析
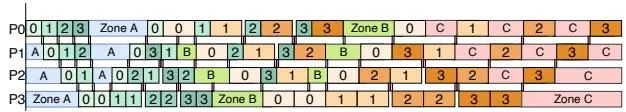
Figure 7: Hanayo 波形流水线中的四种气泡类型。
| 气泡类型 | 原因 | 大小 |
|---|---|---|
| Zone A | 等待前向激活 + 传输开销 | |
| Zone B | 前向/反向传播时间差异 | |
| Zone C | 反向传播 + 通信 | 或 |
| 交叉通信 | NCCL 后端批处理防死锁 | - |
运行时系统
Action List 设计:
- 将指令分解为更细粒度的操作
- 添加目标设备 rank 和本地模块 rank 信息
- 调度器在主节点生成 action list
- 支持所有主流流水线并行算法
预取优化:
- Worker 在计算前预取下一批数据
- 使用异步通信函数
batch_isend_irecv - 最大化计算与通信重叠
- 避免交叉通信死锁
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 波形流水线 | 单条流水线改变方向,无需模型副本 | 从 Chimera 转换推导,效率至少持平 |
| 波数扩展 | 增加波数持续降低气泡率 | 气泡率 ,4波时仅 13% (8 GPU) |
| 统一框架 | 通用性能模型表达所有主流流水线算法 | Action list 解耦调度与运行时 |
| 内存高效 | 权重内存 (无副本),激活内存均衡 | 方差仅 1.44(vs Chimera 2.86) |
| 自适应波数 | 根据通信环境选择最优波数 | NVLink 环境波数越多越好,弱互联环境需适中 |
五、实验结果
测试环境
| 集群 | GPU | 内存 | 互联 | 特点 |
|---|---|---|---|---|
| TACC Lonestar6 | A100 | 40GB | 跨节点 | 超算集群 |
| 腾讯 CVM | V100 | 32GB | NVLink | 云服务器 |
| 本地集群 PC | A100 | 80GB | 部分 NVLink | 实验室 |
| 本地集群 FC | A100 | 80GB | 全连接 NVLink | 实验室 |
内存消耗
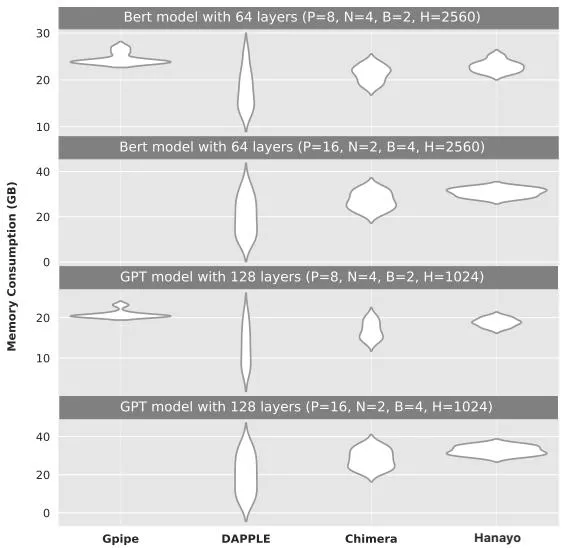
Figure 8: 32 GPU 训练 BERT/GPT 模型时的峰值内存分布。
| 方法 | 最高峰值内存 | 方差 | OOM |
|---|---|---|---|
| GPipe | 高 | 1.33 | 2个设置 |
| DAPPLE | 高 | 16.85 | 无 |
| Chimera | 低 | 2.86 | 无 |
| Hanayo | 低 | 1.44 | 无 |
跨集群吞吐量
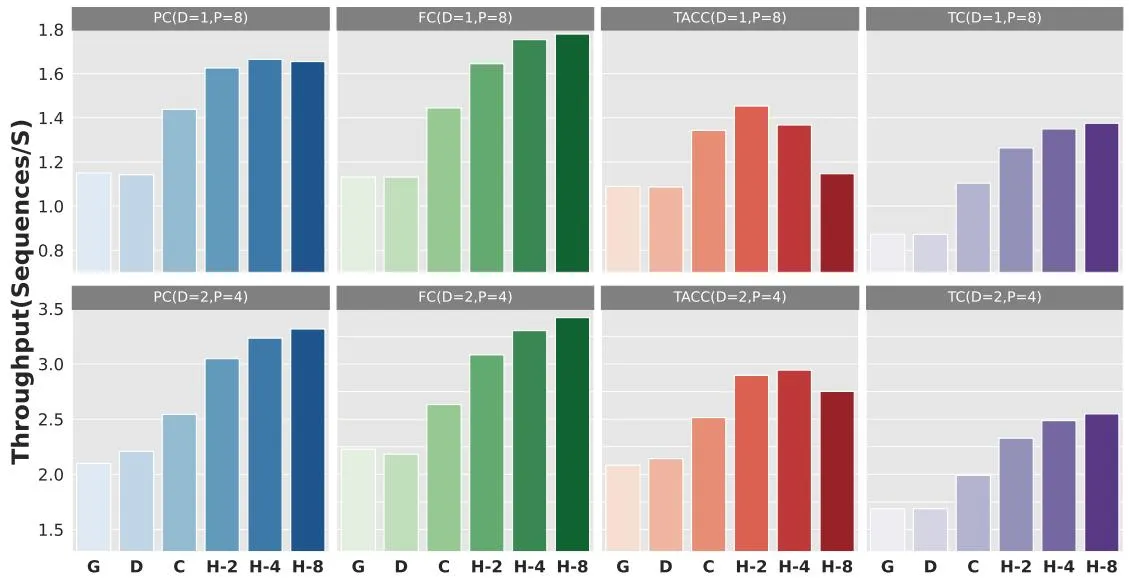
Figure 9: 4个不同集群上训练 BERT 模型的吞吐量(32 GPU)。
BERT 模型, 8 GPU (PP only):
| 集群 | GPipe | DAPPLE | Chimera | Hanayo | 提升 vs Chimera |
|---|---|---|---|---|---|
| PC | 1.15 | 1.15 | 1.45 | 1.67 (W=4) | +15.2% |
| FC | 1.15 | 1.15 | 1.45 | 1.79 (W=4) | +23.4% |
| TACC | 1.09 | 1.09 | 1.35 | 1.46 (W=2) | +8.1% |
| TC | 0.87 | 0.87 | 1.10 | 1.38 (W=8) | +25.5% |
BERT 模型, 8 GPU (PP=4, DP=2):
| 集群 | GPipe | DAPPLE | Chimera | Hanayo | 提升 vs Chimera |
|---|---|---|---|---|---|
| PC | 2.10 | 2.20 | 2.55 | 3.35 (W=8) | +31.4% |
| FC | 2.25 | 2.20 | 2.65 | 3.40 (W=8) | +28.3% |
| TACC | 2.08 | 2.15 | 2.50 | 2.95 (W=4) | +18.0% |
| TC | 1.70 | 1.70 | 2.00 | 2.55 (W=8) | +27.5% |
关键发现: Hanayo 在所有 8 个设置中均超越 Chimera,提升 8.2%-30.4%。
弱扩展
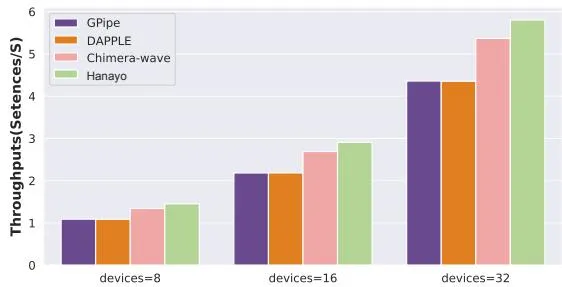
Figure 11: BERT 模型弱扩展。设备从 8 扩展到 32,batch size 同比例增加。
| 设备 | GPipe | DAPPLE | Chimera | Hanayo | 提升 vs Chimera |
|---|---|---|---|---|---|
| 8 | 1.05 | 1.05 | 1.35 | 1.45 | +7.4% |
| 16 | 2.20 | 2.20 | 2.70 | 2.90 | +7.4% |
| 32 | 4.40 | 4.40 | 5.30 | 5.70 | +7.5% |
并行效率: 100.1% 和 99.8%,表明 Hanayo 可扩展到更大集群。
强扩展
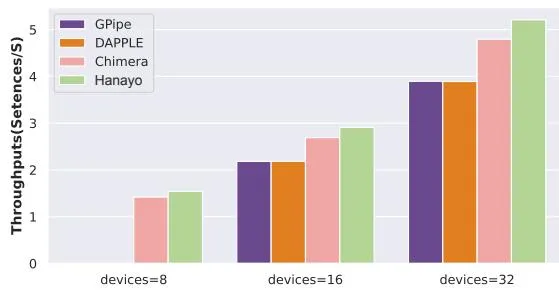
Figure 12: BERT 模型强扩展。固定 batch size=4,设备从 8 增加到 32。
| 设备 | GPipe | DAPPLE | Chimera | Hanayo |
|---|---|---|---|---|
| 8 | OOM | OOM | 1.40 | 1.50 |
| 16 | 2.20 | 2.20 | 2.70 | 2.90 |
| 32 | 3.90 | 3.90 | 4.80 | 5.20 |
加速比: Hanayo 从 8 GPU 到 32 GPU 加速 337.5%。
六、符号说明
| 符号 | 含义 |
|---|---|
| 流水线阶段数 | |
| 单迭代的微批次数 | |
| 复制流水线数 | |
| 流水线 worker 数 | |
| 单前向/反向迭代的波数 = | |
| 单阶段权重内存 | |
| 单阶段激活内存 | |
| 完整前向传播时间 / P | |
| 完整反向传播时间 / P | |
| 单次 P2P 通信时间 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| GPipe | 经典流水线并行,Hanayo 的基础对比对象 |
| DAPPLE (1F1B) | 广泛使用的 1F1B 调度,Hanayo 超越 |
| Chimera | SOTA 双向流水线,Hanayo 的主要对比对象 |
| PipeDream | 异步流水线,Hanayo 可扩展至异步方案 |
| Megatron-LM | 混合并行框架,Hanayo 可与其结合 |
| DeepSpeed | 运行时系统参考,Hanayo 解耦设计改进 |
八、总结
核心贡献
- 波形流水线: 提出 wave-like pipeline scheme,通过增加波数持续降低气泡率
- 统一框架: 通过理论分析获得流水线并行的统一性能模型
- 解耦运行时: Action list 设计使运行时与调度算法解耦,支持所有主流算法
- 30.4% 吞吐量提升: 在 4 个集群、GPT/BERT 架构上验证
技术影响
- 消除模型副本: 将 Chimera 的模型副本转化为标准数据并行
- 自适应优化: 根据通信环境自动选择最优波数
- 通用性: 可扩展至异步流水线和更大规模集群
- 实用性: 高性能运行时系统,支持预取和异步通信
局限性
- 仅关注同步流水线并行(异步可能影响收敛)
- 最优波数依赖于通信环境,需搜索
- 交叉通信在 NCCL 后端需要批处理,可能引入额外气泡
九、参考资源
- 论文: arXiv:2308.15762
- 会议: SC’23
- DOI: 10.1145/3581784.3607073
- ACM: I.2.11 (Distributed Artificial Intelligence), C.1.4 (Parallel Architectures)