OmniQuant: Omnidirectionally Calibrated Quantization for Large Language Models
全方向校准的LLM量化技术,通过LWC和LET实现PTQ效率与QAT性能的统一
OmniQuant: Omnidirectionally Calibrated Quantization for Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | OmniQuant: Omnidirectionally Calibrated Quantization for Large Language Models |
| 作者 | Wenqi Shao*, Mengzhao Chen*, Zhaoyang Zhang, Peng Xu, Lirui Zhao, Zhiqian Li, Kaipeng Zhang, Peng Gao, Yu Qiao, Ping Luo |
| 机构 | 上海AI实验室 (OpenGVLab)、香港大学、香港中文大学 |
| 论文 | arXiv:2308.13137 |
| 代码 | GitHub: OpenGVLab/OmniQuant |
| 硬件 | 单卡 A100-40G |
| 领域 | LLM量化、模型压缩 |
二、核心思想
问题定义
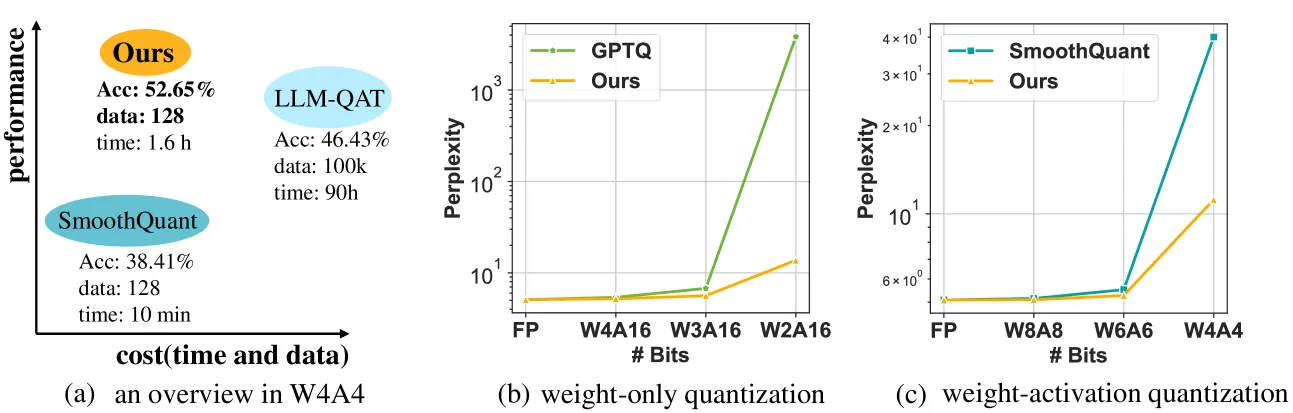
Figure 1: (a) LLaMA-7B W4A4量化性能对比,(b)(c) LLaMA-13B不同位宽下的困惑度
LLM部署面临两大挑战:
| 挑战 | 现有方案 | 局限 |
|---|---|---|
| 内存开销 | PTQ(GPTQ, AWQ) | 手工设计量化参数,极低位性能差 |
| 计算效率 | QAT(LLM-QAT) | 需要100k样本和数百GPU小时 |
核心问题:能否在保持PTQ的时间和数据效率的同时,达到QAT的性能?
解决方案概述
OmniQuant通过高效优化各种量化参数,在多种量化设置下实现优异性能,同时保持PTQ的计算效率。
两大核心组件:
| 组件 | 功能 | 机制 |
|---|---|---|
| LWC (Learnable Weight Clipping) | 调制权重极值 | 优化裁剪阈值 |
| LET (Learnable Equivalent Transformation) | 处理激活异常值 | 通道级缩放和偏移 |
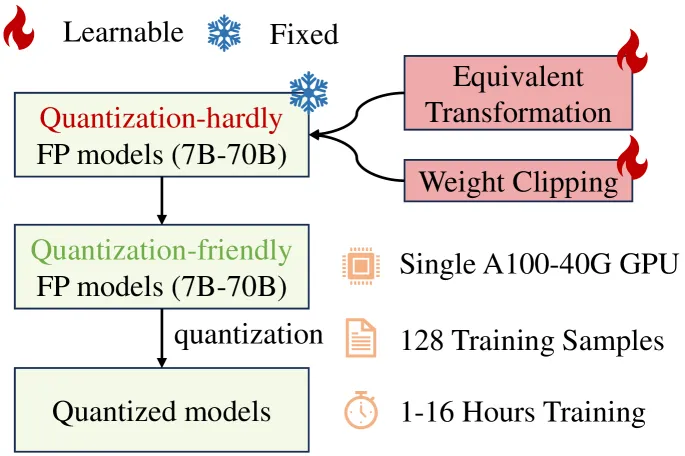
Figure 2: OmniQuant在LLaMA系列上的资源特性
资源需求:
- 训练时间:1-16小时(单卡A100-40G)
- 训练样本:仅128个
- 支持设置:W4A16、W3A16、W2A16、W6A6、W4A4
三、技术架构
整体框架
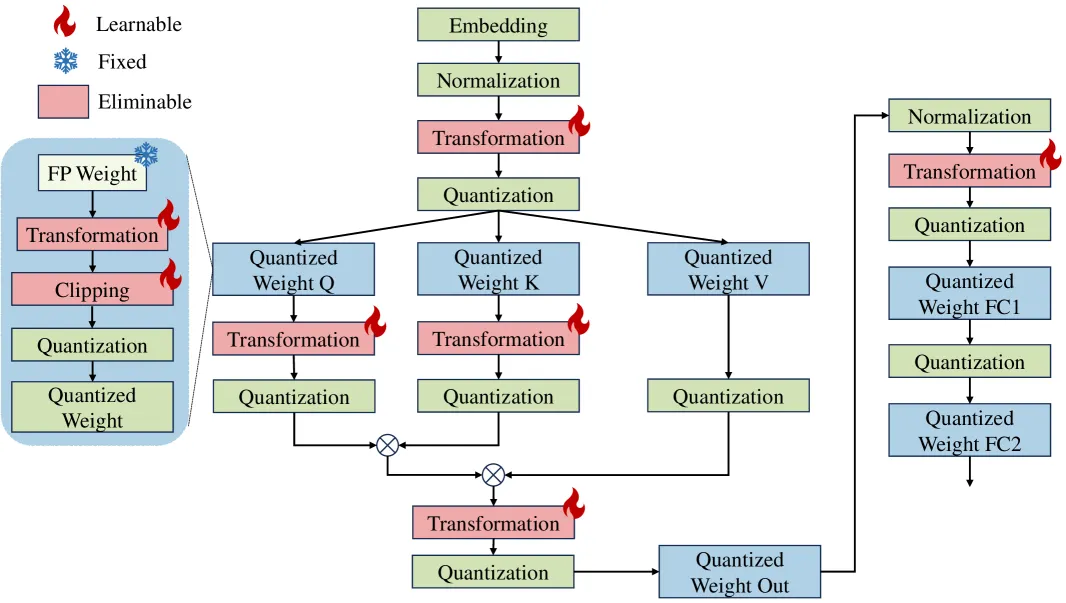
Figure 3: OmniQuant在Transformer块中的详细应用位置
OmniQuant在Transformer块中的应用位置:
| 位置 | 组件 | 作用 |
|---|---|---|
| 线性层权重 | LWC | 优化裁剪阈值,调制权重极值 |
| LayerNorm之后 | LET | 通道级缩放+偏移 |
| Q/K/V投影前 | LET | 通道级变换 |
| V投影后、Out投影前 | LET | 通道级变换 |
| Q/K注意力中 | LET | 注意力缩放 |
| FFN前 | LET | 通道级变换 |
关键特性:所有可学习参数在量化后可被消除/融合,推理时零额外开销。
核心公式
公式1:块级量化误差最小化(总体目标)
其中:
- :全精度权重的Transformer块函数
- :权重量化函数,参数化为 (LWC参数)和 (LET参数)
- :激活量化函数,参数化为
- 逐层优化(块级),保持解空间可控
公式2:LWC权重量化
标准min-max量化: 其中
LWC引入可学习裁剪阈值 和 : 其中 ,,裁剪范围为
公式3:LWC可微分舍入
为使舍入操作可微分,使用软舍入机制:
其中 是温度参数,
公式4:LWC损失函数
优化 (下界)、(上界)和软舍入参数
公式5:LET线性层变换
对于线性层 ,LET应用通道级缩放 和偏移 :
其中 和 是逐通道可学习向量。变换是数学等价的——改变输入分布使其更适合量化。
公式6:LET注意力操作变换
对于注意力机制,LET在计算注意力前对Q和K应用缩放:
这等价于将注意力logits缩放
公式7:LET联合损失
其中 和 是应用等价变换后的权重和激活
激活量化公式(逐token)
其中 逐token计算
算法流程
Algorithm 1: OmniQuant整体算法
输入: 预训练模型, 校准数据 (128样本)
输出: 量化模型

1. 初始化可学习参数 (LWC的α,β,h; LET的S,T)
2. 逐块优化:
   for 每个Transformer块:
       for epoch = 1 to 20:
           使用SGD/AdamW优化可学习参数
           最小化块级量化误差
3. 变换模型:
   应用学到的S,T变换权重
   使用学到的α,β执行量化
四、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| LWC | 可学习权重裁剪,梯度优化阈值 | 极低位权重量化可用 |
| LET | 可学习等价变换,缩放+偏移 | 解决激活异常值问题 |
| 块级优化 | 逐层顺序优化 | 高效训练,128样本即可 |
| 参数融合 | 所有可学习参数可融合 | 推理零额外开销 |
| 统一框架 | 同时支持weight-only和weight-activation | 覆盖所有量化设置 |
与现有方法的关键区别:
| 方法 | 操作 | 目标 | 优化方式 |
|---|---|---|---|
| SmoothQuant | 仅缩放 | Weight-Activation | 预定义迁移强度 |
| AWQ | 仅缩放 | Weight-only | 网格搜索 |
| OS+ | 缩放+偏移 | Weight-Activation | 网格搜索 |
| OmniQuant | 缩放+偏移 | 两者皆可 | 端到端梯度下降 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 模型 | LLaMA-1 (7B-65B), LLaMA-2 (7B-70B), OPT (125M-66B), Falcon-180B |
| 量化设置 | W4A16, W3A16, W2A16, W6A6, W4A4 |
| 评估 | WikiText2困惑度, 6个零样本任务 |
| 基线 | RTN, GPTQ, AWQ, SmoothQuant, OS+, RPTQ, LLM-QAT |
| 训练 | 单卡A100-40G, 128样本, 20 epochs |
权重量化结果(Weight-only)
WikiText2困惑度(越低越好):
W4A16配置:
| 方法 | 7B | 13B | 30B | 65B | 2-7B | 2-13B | 2-70B |
|---|---|---|---|---|---|---|---|
| FP16 | 5.68 | 5.09 | 4.10 | 3.53 | 5.47 | 4.88 | 3.31 |
| RTN | 6.43 | 5.55 | 4.57 | 3.87 | 6.11 | 5.20 | 3.67 |
| GPTQ | 6.13 | 5.40 | 4.48 | 3.83 | 5.83 | 5.13 | 3.58 |
| AWQ | 6.08 | 5.34 | 4.39 | 3.76 | 6.15 | 5.12 | - |
| OmniQuant | 5.86 | 5.21 | 4.25 | 3.71 | 5.74 | 5.02 | 3.47 |
W3A16配置:
| 方法 | 7B | 13B | 30B | 65B | 2-7B | 2-13B | 2-70B |
|---|---|---|---|---|---|---|---|
| RTN | 25.73 | 11.39 | 14.95 | 10.68 | 539.48 | 10.68 | 7.52 |
| GPTQ | 8.06 | 6.76 | 5.84 | 5.06 | 8.37 | 6.44 | 4.82 |
| AWQ | 11.88 | 7.45 | 10.07 | 5.21 | 24.00 | 10.45 | - |
| OmniQuant | 6.49 | 5.68 | 4.74 | 4.04 | 6.58 | 5.58 | 3.92 |
W2A16配置(极端低位):
| 方法 | 7B | 13B | 30B | 65B | 2-7B | 2-13B | 2-70B |
|---|---|---|---|---|---|---|---|
| RTN | 1.1e5 | 6.8e4 | 2.4e4 | 2.2e4 | 3.8e4 | 5.6e4 | 2.0e4 |
| GPTQ | 2.1e3 | 5.5e3 | 499.75 | 55.91 | 7.7e3 | 2.1e3 | 77.95 |
| OmniQuant | 15.47 | 13.21 | 8.71 | 7.58 | 37.37 | 17.21 | 7.81 |
关键发现:
- W2A16下GPTQ困惑度>5000,OmniQuant仅~15
- W4A16下OmniQuant接近FP16性能(5.86 vs 5.68)
权重-激活量化结果
LLaMA-7B零样本任务准确率:
| 配置 | 方法 | PIQA | ARC-e | ARC-c | BoolQ | HellaSwag | Winogrande | 平均 |
|---|---|---|---|---|---|---|---|---|
| FP16 | - | 77.47 | 52.48 | 41.46 | 73.08 | 73.00 | 66.93 | 64.07 |
| W6A6 | SmoothQuant | 77.04 | 50.00 | 39.08 | 72.44 | 72.31 | 67.17 | 63.01 |
| W6A6 | OS+ | 77.20 | 50.63 | 39.59 | 70.58 | 72.43 | 66.61 | 62.84 |
| W6A6 | OmniQuant | 77.20 | 51.56 | 40.70 | 73.08 | 72.80 | 67.09 | 63.74 |
| W4A4 | SmoothQuant | 52.96 | 25.92 | 21.76 | 37.82 | 27.60 | 49.72 | 35.96 |
| W4A4 | OS+ | 57.67 | 25.58 | 24.23 | 38.46 | 29.36 | 49.88 | 37.53 |
| W4A4 | RPTQ | 63.89 | 32.96 | 25.68 | 55.81 | 43.50 | 52.25 | 45.68 |
| W4A4 | LLM-QAT | 65.52 | 36.95 | 26.71 | 60.37 | 49.52 | 52.80 | 48.65 |
| W4A4 | OmniQuant | 71.81 | 48.02 | 35.92 | 73.27 | 66.81 | 59.51 | 59.22 |
关键结果:
- W4A4下OmniQuant超越LLM-QAT +10.57%
- W6A6下OmniQuant接近FP16(63.74% vs 64.07%)
指令微调模型量化
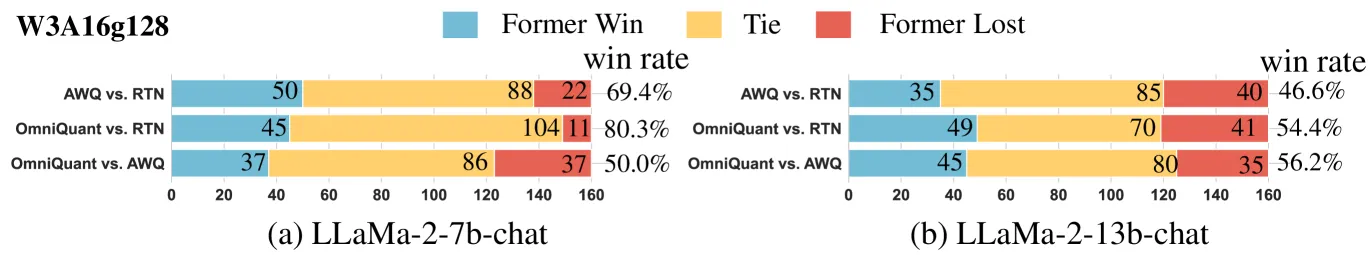
Figure 4: W3A16g128量化在Vicuna-Bench上的胜率对比
LLaMA-2-chat模型W3A16g128量化:
- RTN vs OmniQuant:7b-chat胜率80.3%,13b-chat胜率69.4%
- AWQ vs OmniQuant:一致或更优
实际设备部署加速
MLC-LLM部署结果(A100-80G):
| 配置 | 7B权重 | 7B运行内存 | 7B tok/s | 13B权重 | 13B tok/s | 30B权重 | 30B tok/s | 65B权重 | 65B tok/s |
|---|---|---|---|---|---|---|---|---|---|
| FP16 | 12.6G | 14.4G | 69.2 | 24.3G | 52.5 | 60.6G | 23.9 | OOM | - |
| W4A16g128 | 3.8G | 5.7G | 134.2 | 7.0G | 91.3 | 16.7G | 43.6 | 33.0G | 24.3 |
| W3A16g128 | 3.2G | 5.1G | 83.4 | 5.8G | 57.6 | 13.7G | 29.0 | 27.0G | 15.2 |
| W2A16g128 | 2.2G | 4.1G | 83.9 | 4.0G | 92.6 | 9.2G | 36.7 | 18.0G | 24.8 |
关键发现:
- W4A16g128:1.94倍加速(7B),内存减少3.3倍
- LLaMA-65B FP16在单卡OOM,量化后轻松运行
- W2A16g128在13B上甚至比W3A16更快(92.6 vs 57.6 tok/s)
训练效率
| 模式 | 7B | 13B | 30B | 65B |
|---|---|---|---|---|
| Weight-only | 1.1h | 2.2h | 4.5h | 8.9h |
| Weight-activation | 1.6h | 3.3h | 7.3h | 14.4h |
对比:
- GPTQ:~5倍更快
- LLM-QAT:数百GPU小时 vs OmniQuant的1-16小时
- 仅需128个校准样本,16个即可收敛
消融实验
组件效果(LLaMA-7B W4A4):
| 方法 | 平均困惑度 | 平均准确率 |
|---|---|---|
| SmoothQuant | 28.78 | 38.41 |
| LET | 16.97 | 48.83 |
| LET + 网格搜索WC | 15.82 | 49.59 |
| SmoothQuant + LWC | 15.80 | 50.15 |
| LET + LWC | 12.87 | 52.65 |
组件必要性(LLaMA-13B困惑度):
| 配置 | W4A4 | W3A16 |
|---|---|---|
| LWC+LET | 10.87 | 5.65 |
| -LWC | 20.75 | 7.65 |
| -LET | 5.4e3 | 5.68 |
| -LWC-LET | 1.8e3 | 10.68 |
关键洞察:
- LET对weight-activation量化(尤其W4A4)至关重要——解决激活异常值
- LWC对极低位权重量化至关重要——调制权重极值
- 两者互补,组合效果最佳
激活分布可视化
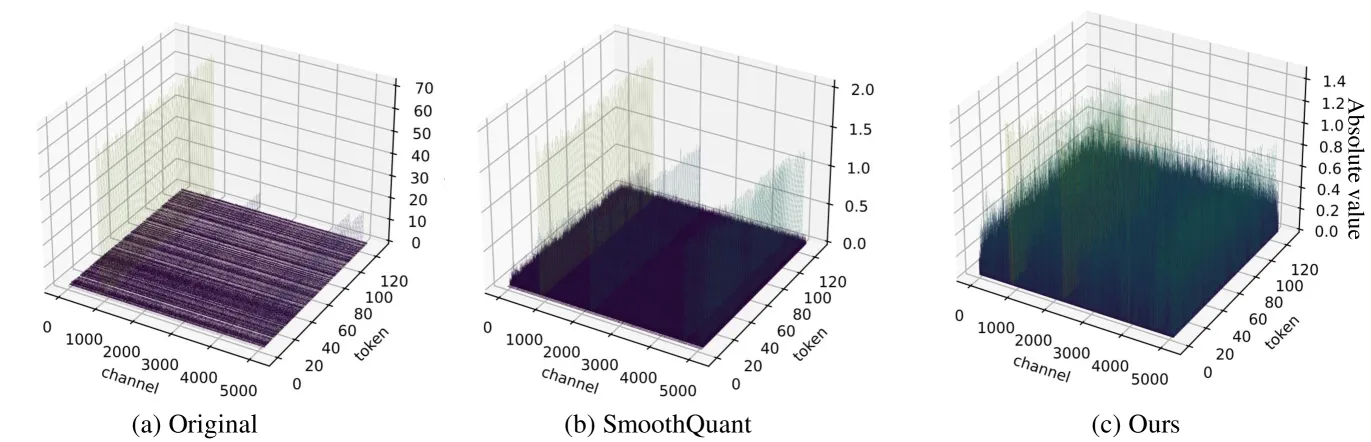
Figure 6: OPT-13B线性层激活可视化:(a)原始 (b)SmoothQuant后 (c)LET后
LET比SmoothQuant更有效地处理激活异常值。
裁剪尺度可视化
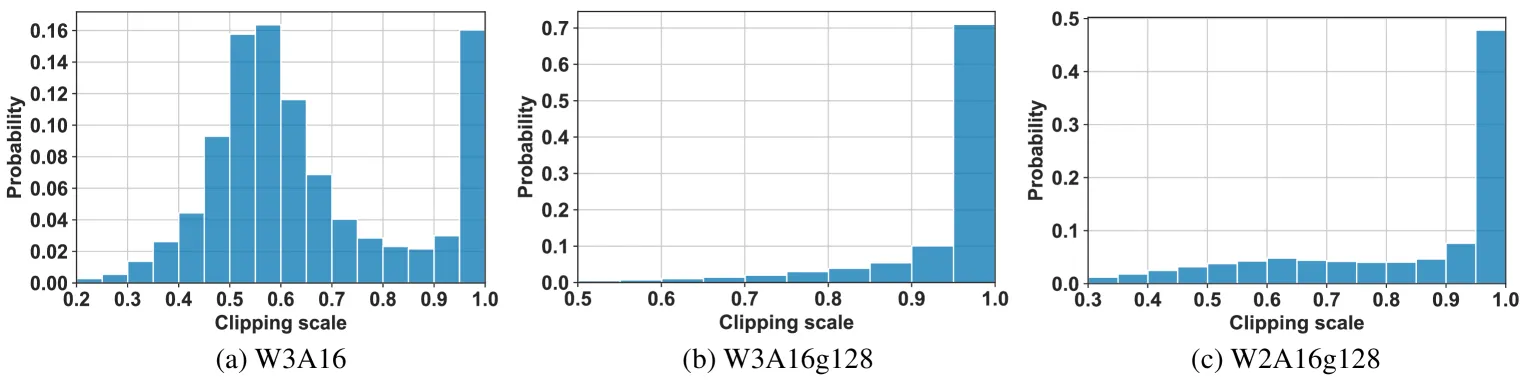
Figure 5: LLaMA-7B不同量化设置下学到的裁剪尺度可视化
位宽缩放定律
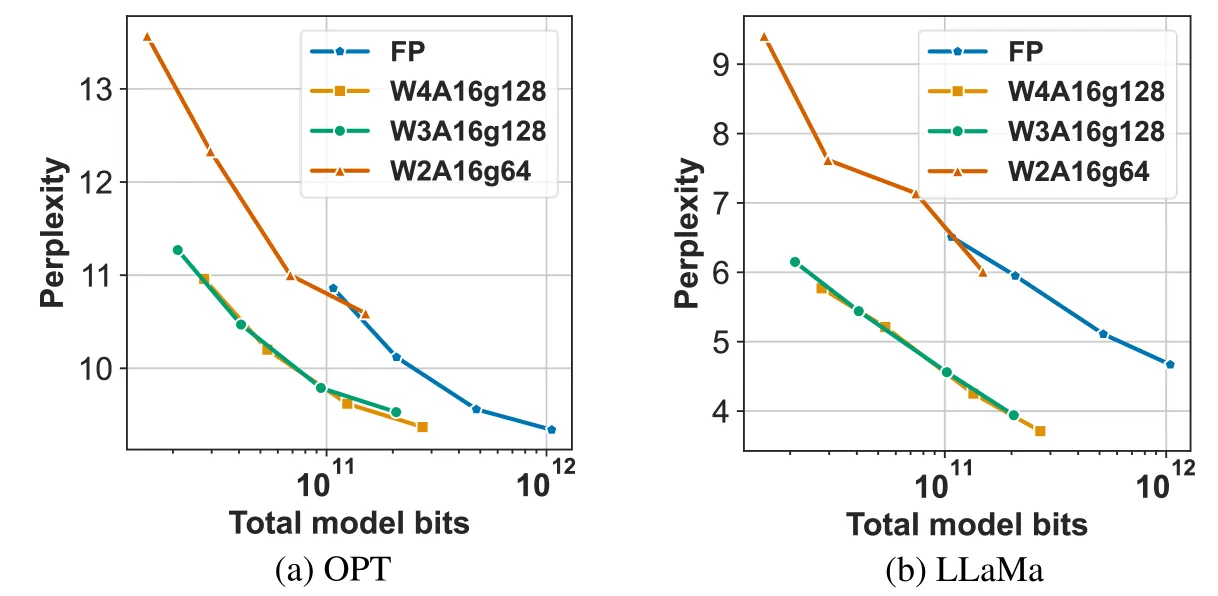
Figure 8: 困惑度的位宽缩放定律
六、相关工作对比
| 方法 | 类型 | 优化方式 | 位宽支持 | 训练开销 |
|---|---|---|---|---|
| GPTQ | PTQ | 块级重建 | W4A16+ | 低 |
| AWQ | PTQ | 网格搜索 | W4A16+ | 低 |
| SmoothQuant | PTQ | 预定义 | W6A6/W4A4 | 无 |
| LLM-QAT | QAT | 端到端 | W4A4 | 极高 |
| OmniQuant | PTQ+ | 梯度优化 | 全部 | 低 |
OmniQuant的独特优势:
- 首个在PTQ效率下实现QAT性能的方法
- 同时支持weight-only和weight-activation量化
- 覆盖从W2A16到W4A4的所有设置
- 128样本、1-16小时、单卡A100
七、总结
核心贡献
- LWC:可学习权重裁剪,通过梯度下降优化裁剪阈值
- LET:可学习等价变换,通道级缩放+偏移迁移量化难度
- 统一框架:同时支持weight-only和weight-activation量化
- 高效训练:128样本、1-16小时、单卡A100-40G
- 零推理开销:所有可学习参数可融合到量化权重中
性能指标
| 指标 | 数值 |
|---|---|
| W4A16困惑度 | 接近FP16(5.86 vs 5.68) |
| W4A4准确率 | 超越LLM-QAT +10.57% |
| W2A16困惑度 | 15.47(GPTQ: 2100+) |
| 推理加速 | 最高1.94倍 |
| 内存减少 | 最高3.3倍 |
| 训练时间 | 1-16小时 |
| 训练样本 | 128个 |
技术影响
- 首次证明PTQ可以达到QAT性能
- 极低位量化(W2A16)成为可能
- 为LLM在边缘设备部署提供实用方案
- 代码开源,易于复现和扩展
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 性能概述对比 | figure1-performance-overview.png |
| Figure 2 | 资源特性概览 | figure2-characteristics.png |
| Figure 3 | 架构详情 | figure3-architecture-detail.png |
| Figure 4 | Vicuna-Bench对比 | figure4-vicuna-bench-comparison.png |
| Figure 5 | 裁剪尺度可视化 | figure5-clipping-scale-visualization.png |
| Figure 6 | 激活分布可视化 | figure6-activation-visualization.png |
| Figure 8 | 缩放定律 | figure8-scaling-laws.png |