Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendations
在 YouTube 排序模型中验证 Semantic ID 替代随机视频 ID,通过 RQ-VAE 量化内容嵌入为离散语义 token,提升冷启动和长尾物品的泛化能力
Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendations
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendations |
| 作者 | Anima Singh, Trung Vu, Nikhil Mehta, Raghunandan Keshavan, Maheswaran Sathiamoorthy, Yilin Zheng, Lichan Hong, Lukasz Heldt, Li Wei, Devansh Tandon, Ed H. Chi, Xinyang Yi |
| 机构 | Google DeepMind, Google |
| 论文 | arXiv:2306.08121 |
| 发布 | 2023-06-13 (v1), 2024-05-30 (v2) |
| 许可 | 未明确 |
二、核心思想
问题定义
YouTube 排序模型使用随机哈希的视频 ID 作为物品表示:
- 优势:强大的记忆能力,能快速学习物品质量
- 劣势:
- 无法跨相似物品泛化
- 冷启动物品(新视频)缺乏交互历史
- 长尾物品(低曝光)学习不充分
- 嵌入表规模巨大(O(10) 百万桶,O(100) 百万视频)
核心矛盾:直接使用内容嵌入替换随机 ID 会导致记忆能力下降,质量降低。
解决方案概述
提出 Semantic ID (SID) 作为随机 ID 的替代方案:
- RQ-VAE 量化:将冻结的内容嵌入压缩为紧凑的离散语义 token
- 层次化表示:每个 token 捕获不同粒度的语义概念
- 有意义的碰撞:语义相似的物品共享 ID 前缀,实现知识共享
- SentencePiece 分词:将 SID 序列分词为可学习的子词嵌入
三、技术架构
整体框架图
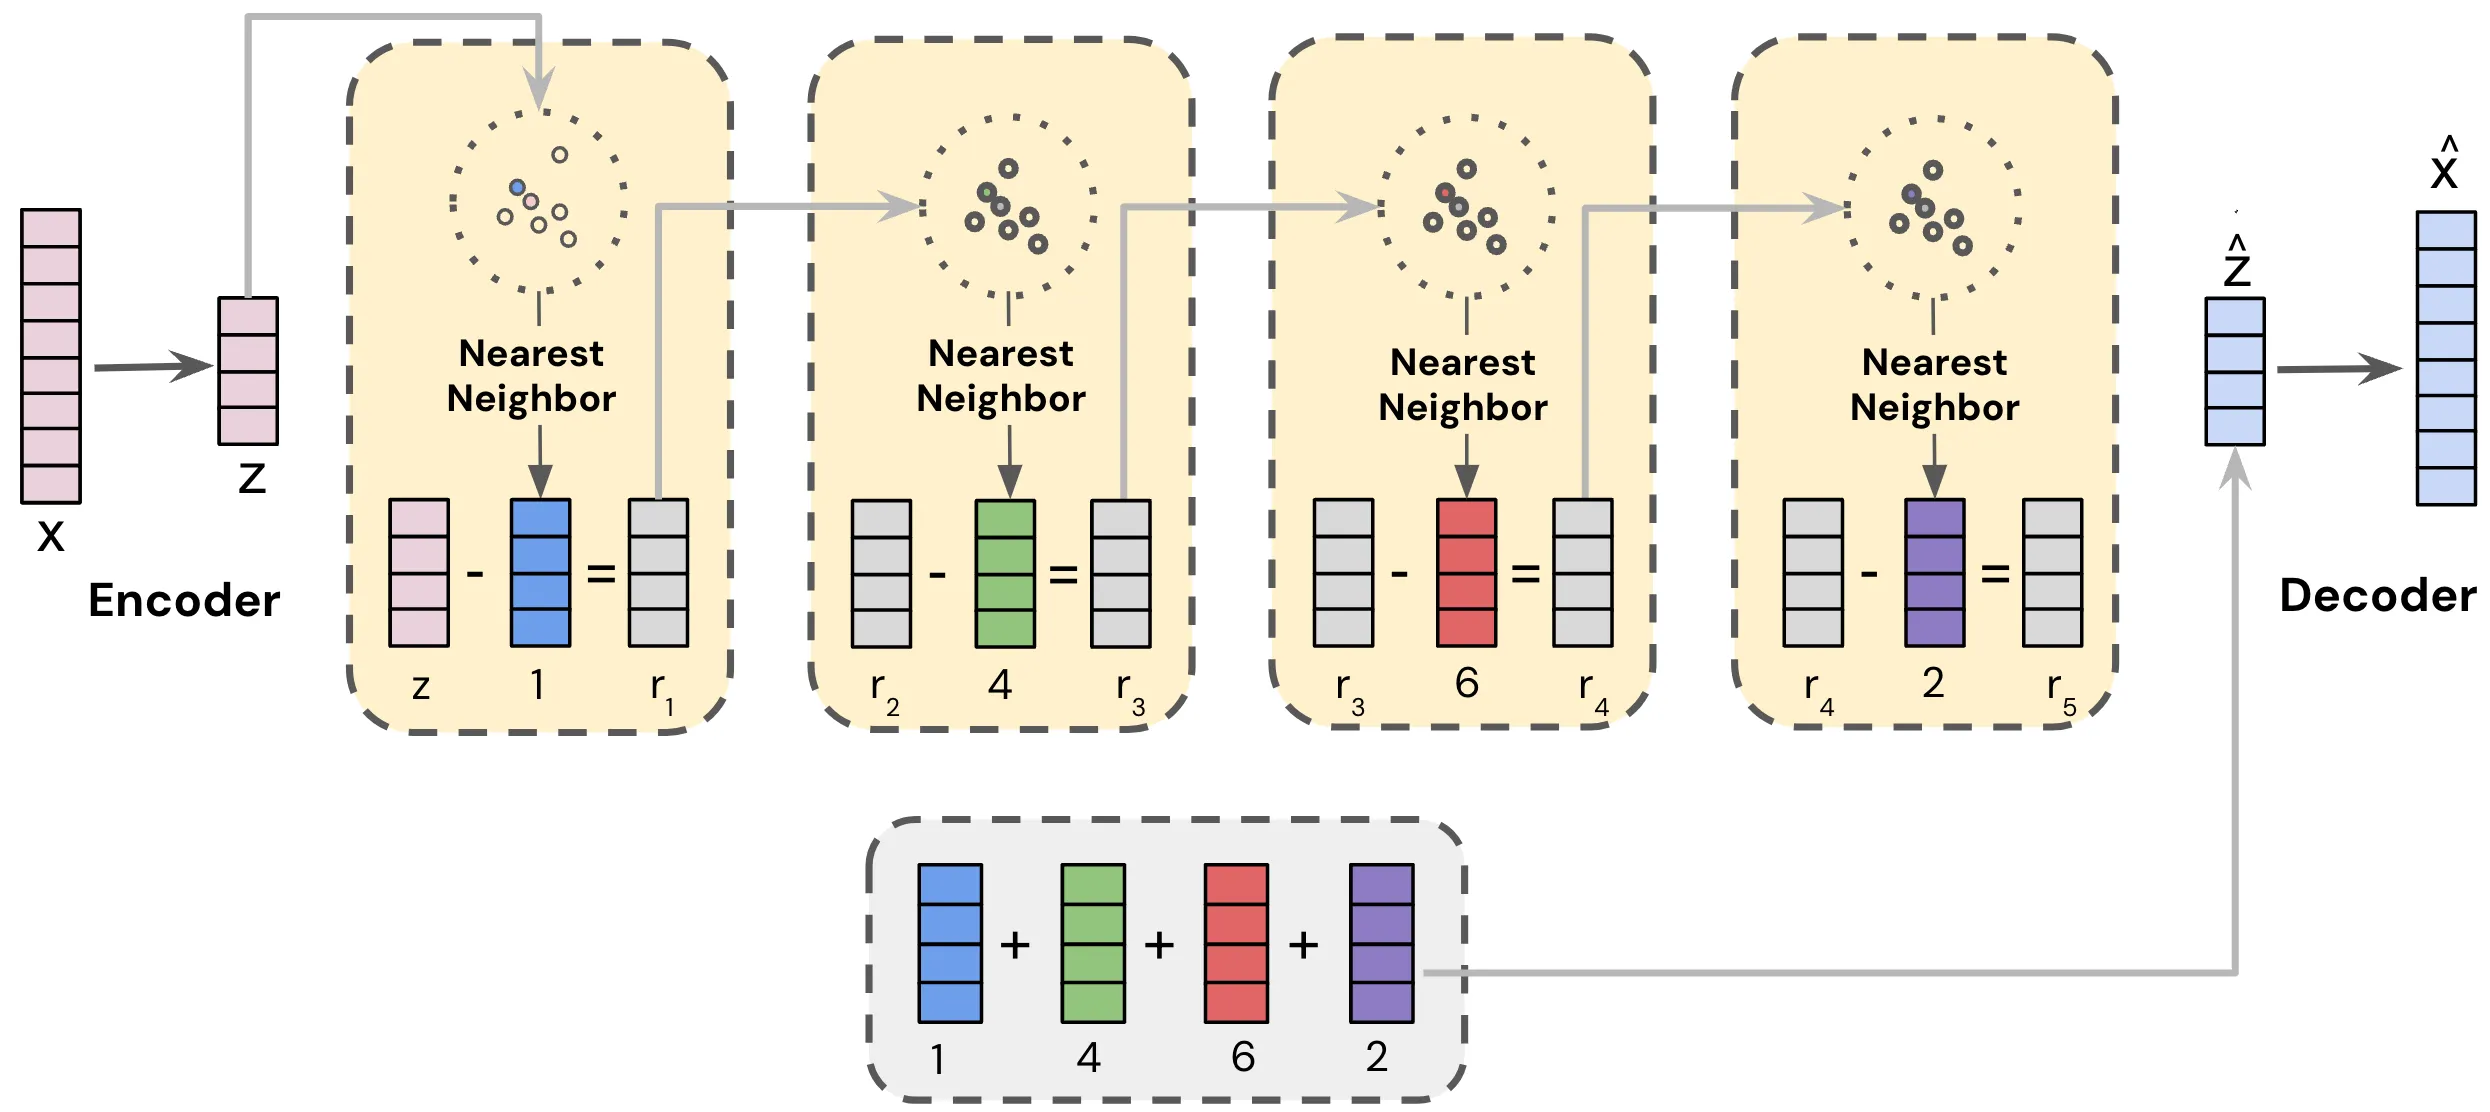
Two-Stage Approach
├── Stage 1: RQ-VAE Training (Offline, Frozen)
│   ├── Input: 2048-dim content embedding (Video-BERT)
│   ├── Encoder: 1-layer, dim=256
│   ├── 8-level Residual Quantization (K=2048 each)
│   ├── Output: 8-token Semantic ID (c₁, c₂, ..., c₈)
│   └── Freeze after training
├── Stage 2: Ranking Model Training
│   ├── Input: SID sequences for user history, current video, candidate
│   ├── SID → SentencePiece Tokenization → Subword Embeddings
│   ├── Sum/Concat subword embeddings
│   └── Multitask ranking model (CTR, watch time, etc.)
└── Serving
    ├── New videos → Frozen RQ-VAE → Generate SID
    ├── SID stored like other features
    └── Real-time ranking inference
Semantic ID 适配方法
问题:SID 序列 (c₁, c₂, …, c₈) 不能直接作为特征输入
解决方案:通过分词将 SID 序列转换为可学习的嵌入
| 方法 | 子词长度 | 嵌入表大小 | 特点 |
|---|---|---|---|
| Unigram | 1 | K×L | 最细粒度,捕获每个 token |
| Bigram | 2 | K²×L/2 | 捕获相邻 token 关系 |
| 3-Bigram | 3 | K³×(L-2)/3 | 更强语义捕获 |
| SentencePiece | 可变 | 可控 | LLM 分词方式,自动学习最优分割 |
SentencePiece 分词
核心创新:使用 LLM 中常用的 SentencePiece 模型对 SID 序列进行分词
- 自动学习最优的子词分割
- 比手工设计的 N-gram 更优
- 类似于 BERT/GPT 的 tokenizer
Semantic ID 层次结构
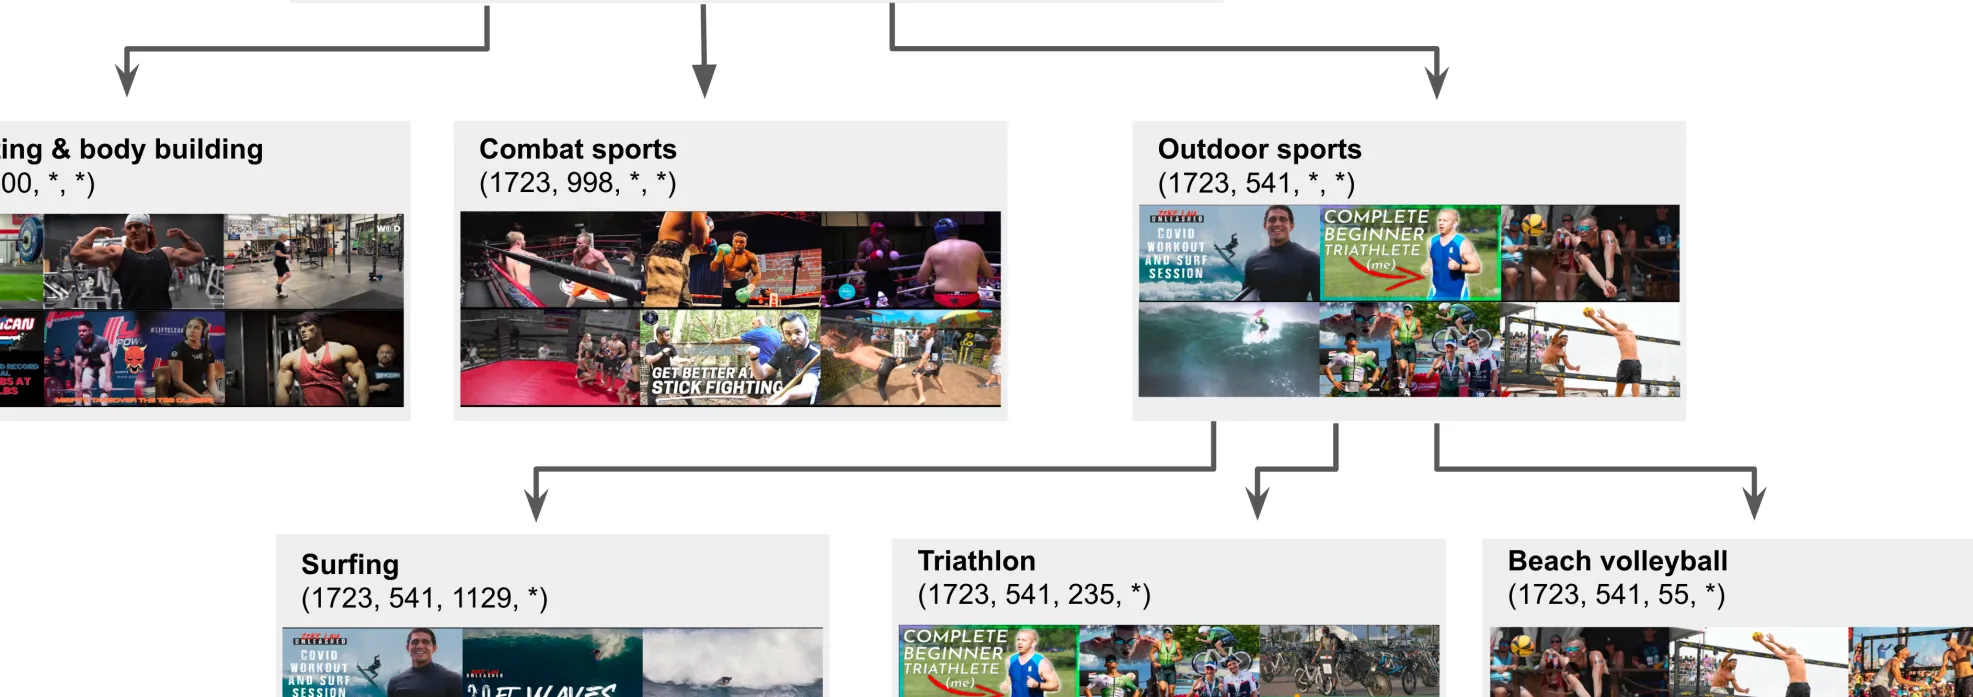
Semantic ID Trie Structure
├── Level 1 (c₁): 粗粒度概念
│   e.g., 体育、美食、音乐...
├── Level 2 (c₂): 中粒度概念
│   e.g., 体育 → 篮球、足球、网球...
├── Level 3 (c₃): 细粒度概念
│   e.g., 篮球 → NBA、街球、训练...
└── Level 4+ (c₄...): 具体物品
最终定位到单个视频相似度分析:
| 共享前缀长度 | 平均余弦相似度 | 典型子树大小 |
|---|---|---|
| 1 | 0.41 | 150,000-450,000 |
| 2 | 0.68 | 20-150 |
| 3 | 0.91 | 1-5 |
| 4 | 0.97 | 1 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| RQ-VAE 量化 | 8 级残差量化,K=2048 码本 | 图 1,附录 A.1 |
| SentencePiece 分词 | LLM 分词方式替代手工 N-gram | 图 2-3,表 1 |
| 冻结 RQ-VAE | 训练后冻结,稳定性验证 | 附录 A.2 |
| 有意义碰撞 | 语义相似物品共享前缀,提升泛化 | 表 1,图 6-7 |
| 工业级验证 | YouTube 排序模型实测 | 图 2-4 |
五、实验结果
不使用用户历史的设置
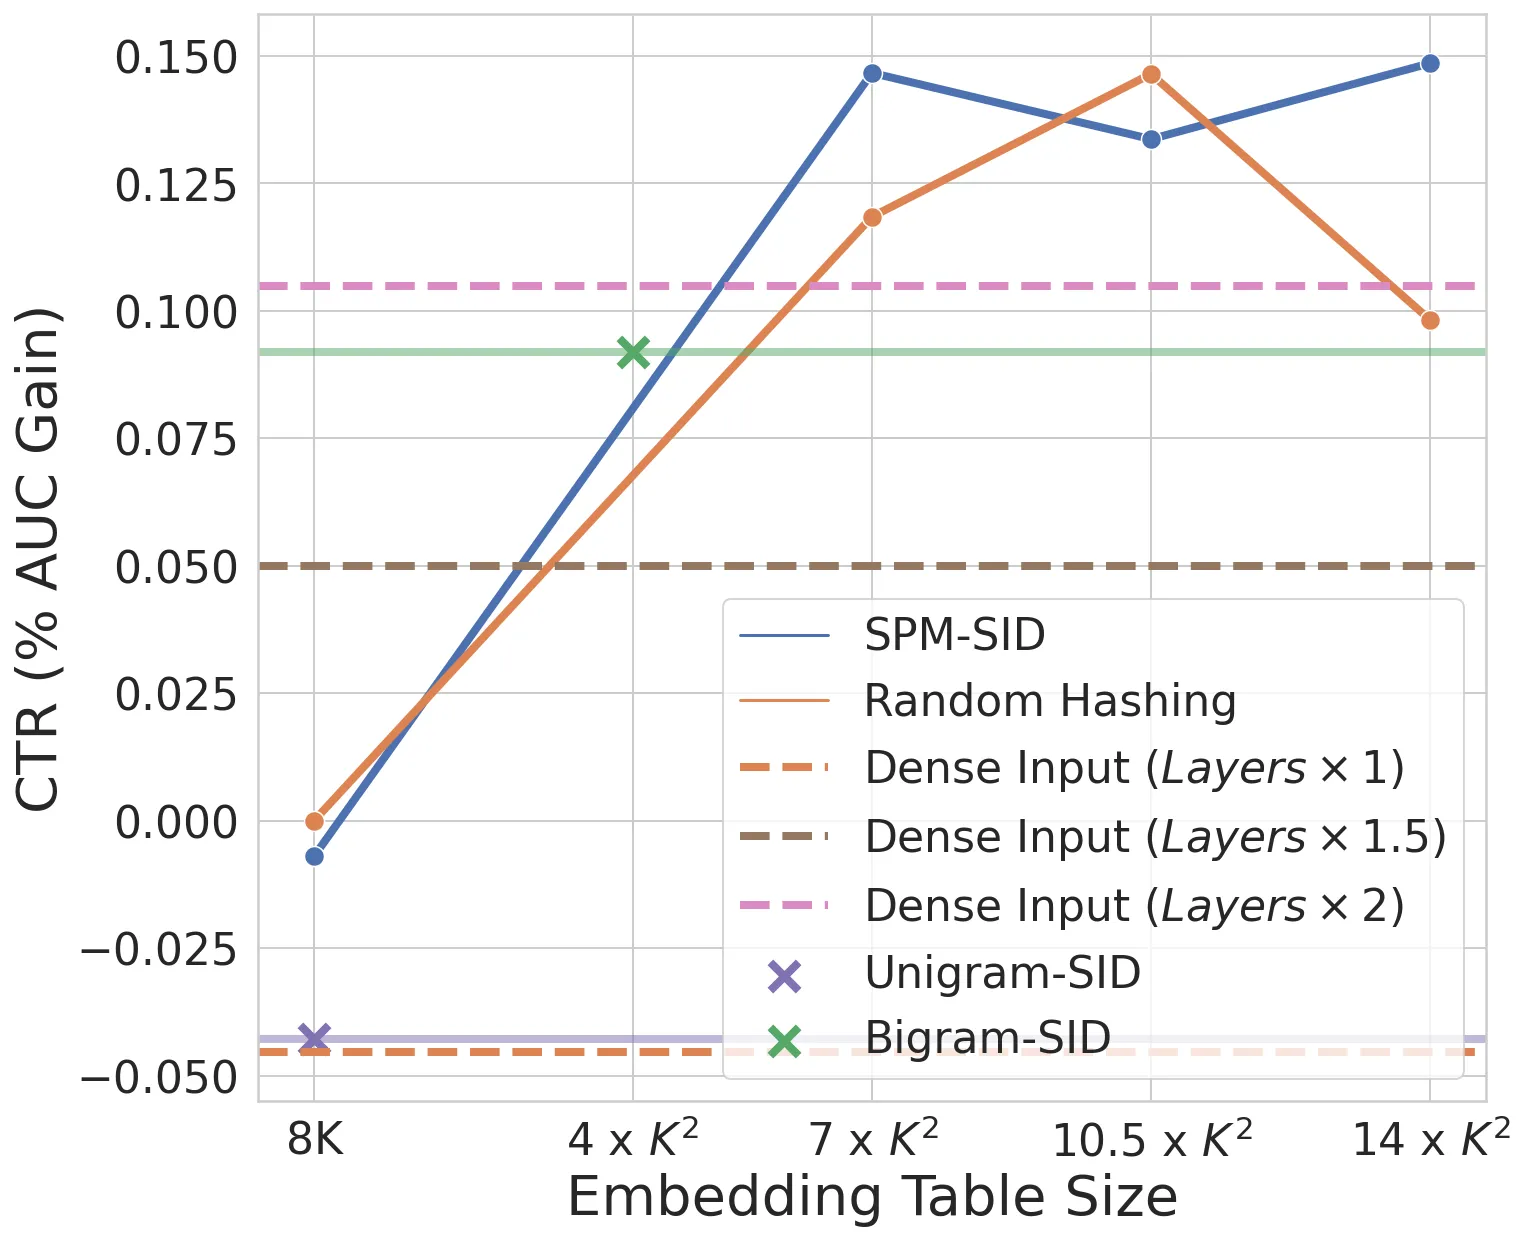
发现:
- Dense Input(直接使用内容嵌入)显著劣于 Random Hashing
- Semantic ID 方法在整体和冷启动上均优于 Random Hashing
- 3Bigram-sum 表现最佳
使用用户历史的设置
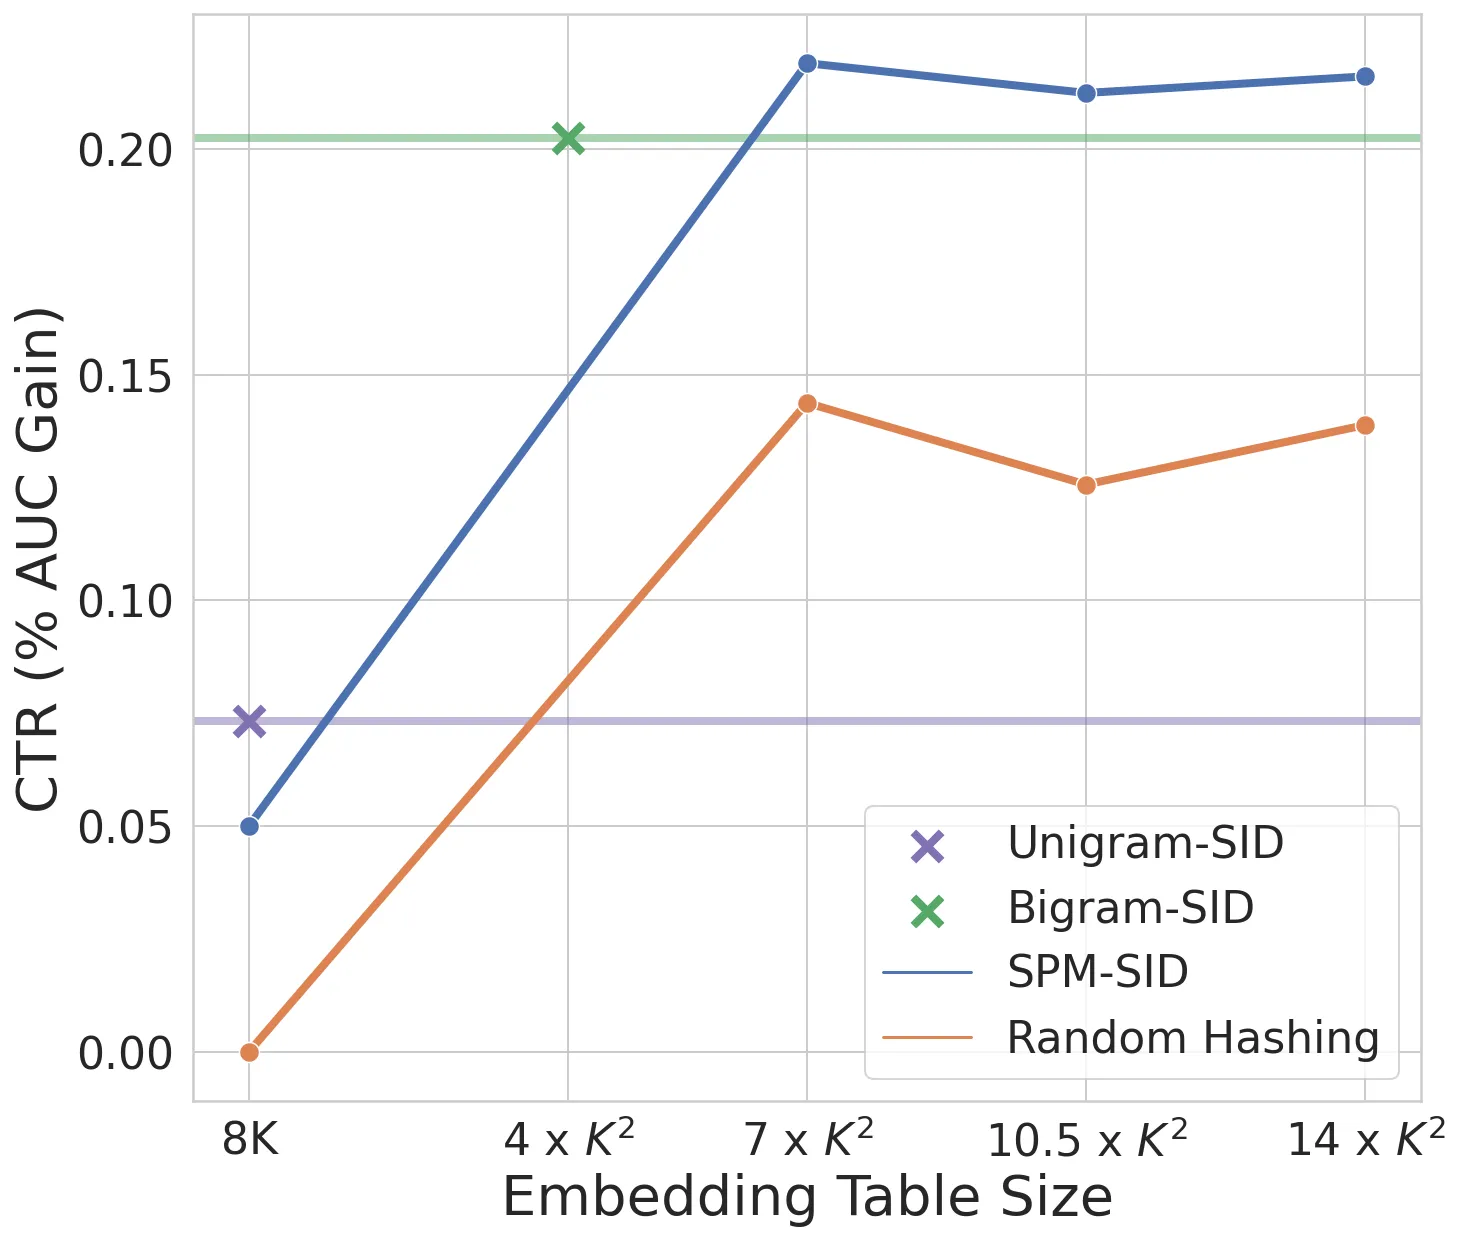
发现:
- Semantic ID 在整体 CTR 上与 Random Hashing 持平或略优
- 冷启动物品显著提升:1D AUC 提升明显
- SentencePiece 分词优于手工 N-gram
每视频子词嵌入数
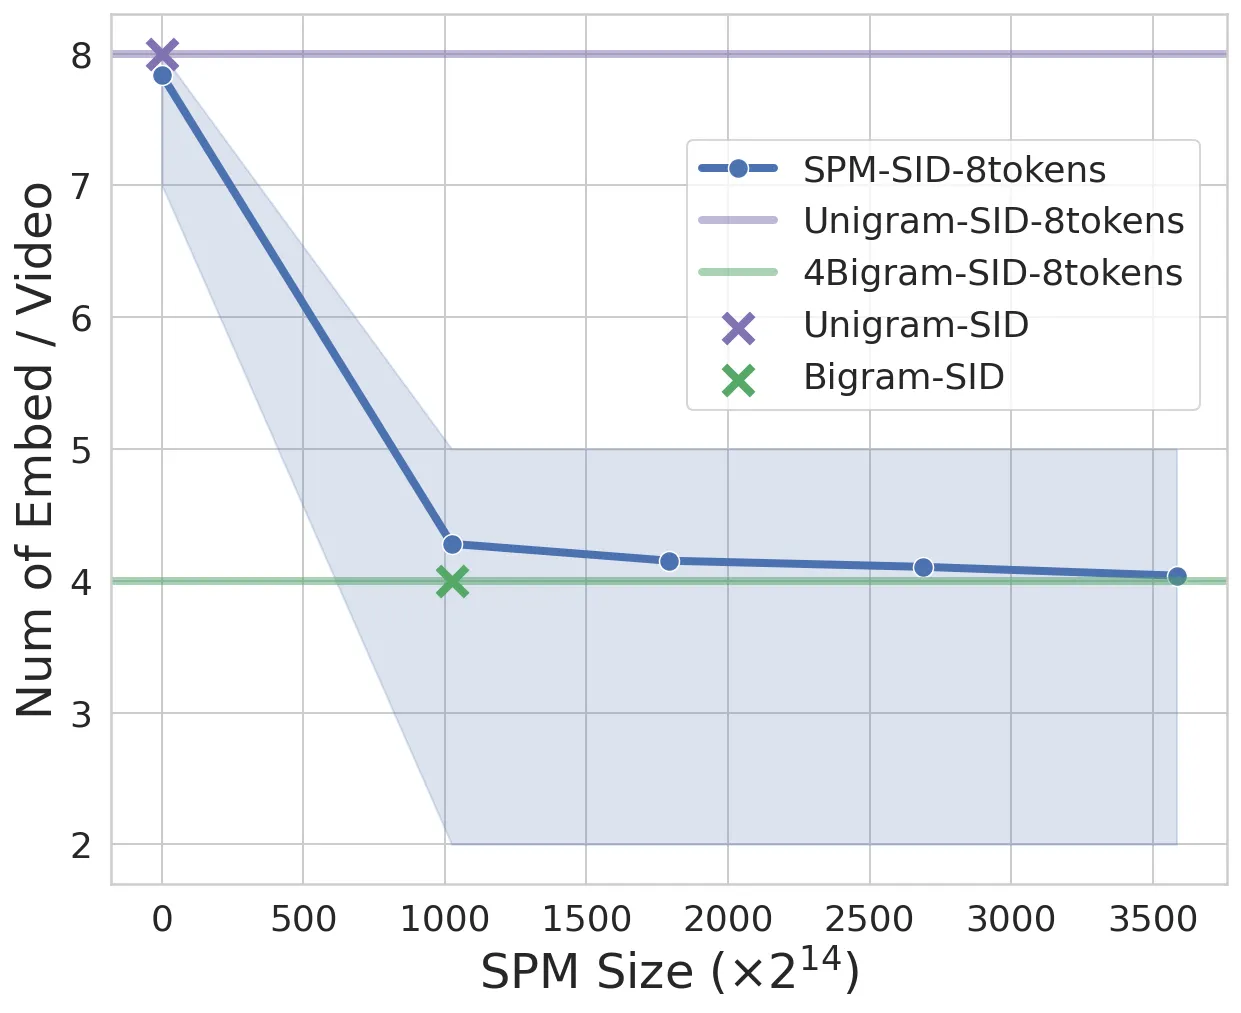
发现:
- 3Bigram 平均每视频 ~15 个子词嵌入
- SentencePiece 更紧凑,每视频更少嵌入
- 嵌入表大小可控,适合工业部署
Semantic ID 稳定性
- 训练两个 RQ-VAE(间隔 6 个月)
- 两者生成的 SID 在排序模型中性能相当
- 证明语义 token 空间随时间稳定
六、模型配置
RQ-VAE 配置
| 参数 | 值 |
|---|---|
| 编码器 | 1 层, dim=256 |
| 量化级别 | L=8 |
| 码本大小 | K=2048 (每级) |
| 总 ID 空间 | 2048⁸ ≈ 2.7×10²⁶ |
| β | 0.25 |
| 训练步数 | ~10M steps |
| 内容嵌入 | 2048-dim (Video-BERT) |
排序模型配置
| 参数 | 值 |
|---|---|
| 模型类型 | 多任务排序模型 |
| 视频语料 | O(100) 百万 |
| 哈希桶 | O(10) 百万 |
| 三个关键特征 | 用户观看历史、当前视频、候选视频 |
| 评估指标 | CTR AUC, CTR-1D AUC (冷启动) |
七、相关工作
| 工作 | 方法 | 与 SID 的差异 |
|---|---|---|
| TIGER | RQ-VAE + 生成式检索 | 用于检索阶段,本文用于排序 |
| VQ-Rec | 产品量化 | 无层次语义 |
| PinSage | 图神经网络聚合 | 增加训练成本 |
| PinnerFormer | 序列嵌入 | 仅离线推理 |
| Hashing Trick | 随机哈希 | 随机碰撞,无语义 |
八、总结
核心贡献
- Semantic ID 替代随机 ID:在 YouTube 排序模型中验证 SID 可替代视频 ID
- RQ-VAE 量化:8 级残差量化,将 2048-dim 嵌入压缩为 8 个离散 token
- SentencePiece 分词:LLM 分词方式优于手工 N-gram
- 冷启动提升:新物品和长尾物品泛化能力显著提升
- 整体质量不损失:在提升泛化的同时保持整体排序质量
- 工业级验证:YouTube 真实生产环境测试
技术影响
- 推荐系统范式转变:从随机 ID 到语义 ID
- 冷启动解决方案:新物品无需交互历史即可获得好的表示
- 长尾优化:低曝光物品通过语义共享获得更好学习
- 可迁移性:SID 可迁移至其他推荐任务
- 工业部署友好:嵌入表大小可控,推理无额外开销
局限性
- 两阶段训练:需要先训练 RQ-VAE,再训练排序模型
- 内容依赖:SID 质量依赖内容嵌入的质量
- 记忆能力:相比随机 ID,SID 的记忆能力略有下降
- 嵌入表增长:N-gram 方法嵌入表随 N 指数增长
- 评估范围:仅在 YouTube 排序模型上验证
九、参考资源
- 论文: arXiv:2306.08121
- 前置工作:
- 相关工作:
- VQ-Rec - 向量量化迁移推荐
- PinSage - 图神经网络推荐
- PinnerFormer - 序列推荐
- 工业应用:
- YouTube 排序模型生产环境验证