Blockwise Parallel Transformer for Large Context Models
通过块级并行计算实现长序列Transformer训练,支持32倍更长上下文
Blockwise Parallel Transformer for Large Context Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Blockwise Parallel Transformer for Large Context Models |
| 作者 | Hao Liu, Pieter Abbeel |
| 机构 | UC Berkeley |
| 论文 | arXiv:2305.19370 |
| 代码 | GitHub |
| 发布 | 2023-05-30 (v1), 2023-08-28 (v3) |
| 许可 | Not specified |
二、核心思想
问题定义
Transformer模型在处理长序列时面临严重的内存瓶颈。虽然FlashAttention等方法通过块级计算将self-attention的内存复杂度从降低到,但前馈网络(FFN)的内存开销被忽视了。FFN包含大量参数并产生高维中间向量,成为长序列训练的关键瓶颈。
解决方案概述
Blockwise Parallel Transformer (BPT) 提出了一种新方法:
- 块级FFN计算:将FFN计算与块级self-attention融合,无需等待完整attention计算完成
- 双层循环结构:外层循环遍历query块,内层循环遍历key-value块
- 内存效率:每个BPT层的激活内存仅为2bsh,比FlashAttention的8bsh节省4倍
关键洞见:当self-attention以块级方式计算时,可以同时计算FFN,无需为整个序列分配大量内存。
三、技术架构
整体框架图
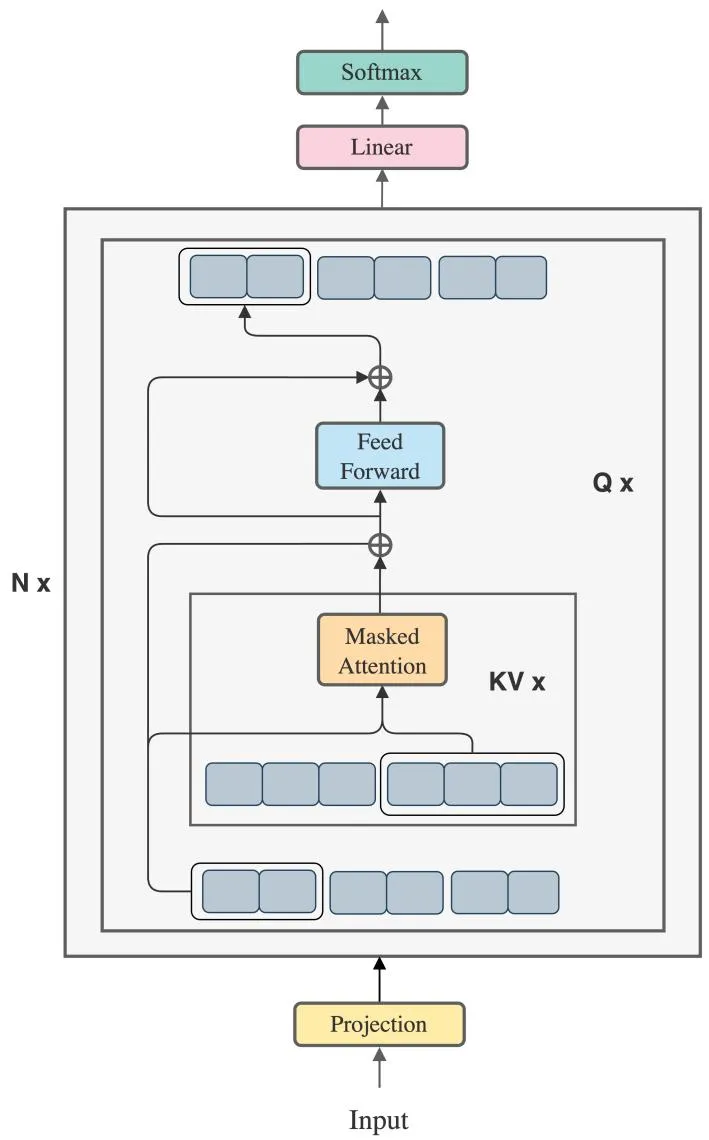
Figure 2: BPT使用与原始Transformer相同的模型架构,但组织计算方式不同。对于底部第一个输入块,投影为query;然后迭代上方的输入序列,投影为key和value。这些query、key和value用于计算self-attention(黄色框),输出传递给FFN(青色框),然后是残差连接。
核心公式
标准Attention:
标准FFN:
块级Attention(方程3): 对于特定query块,对应的attention输出通过缩放块级attention计算:
缩放操作:
块级FFN + 残差连接:
内存分析
| 架构 | Attention内存 | FFN内存 | 总激活内存 |
|---|---|---|---|
| Vanilla Transformer | 8bsh | ||
| FlashAttention | 2bsh | 8bsh | 8bsh |
| BPT | 2bsh | 2bsh | 2bsh |
关键公式推导:
BPT的FFN内存计算:
- 第一个线性层输入:2bch
- 激活输入:8bch
- 第二个线性层输入:8bch
- Dropout掩码:bch
- 总计:19bch + 2bsh ≈ 2bsh(因为)
内存节省:BPT提供倍内存节省。
算法实现
Algorithm 1 - BPT伪代码:
输入: 输入序列x, query块数B_q, key-value块数B_kv

1. 将输入序列x投影为query, key, value
2. 将query序列分割为B_q个query输入块
3. 将key和value序列分割为B_kv个key-value输入块
4. for outer = 1 to B_q do
5.     选择第outer个query块
6.     for inner = 1 to B_kv do
7.         选择第inner个key和value块
8.         使用query, key, value计算attention,记录归一化统计
9.     end for
10.    通过缩放各块获得第outer个输入块的attention输出
11.    在attention输出上计算FFN并添加残差连接
12. end for
Jax实现
def blockwise_ffn(remat_ffn, inputs, chunk_size, deterministic):
    inputs = rearrange(inputs, 'b (c n) d -> b c n d', c=chunk_size)
    def scan_ffn(remat_ffn, carry, hidden_states):
        outputs = remat_ffn(hidden_states, deterministic=deterministic)
        return carry, outputs
    scan_axis = inputs.ndim - 2
    _, res = nn.scan(
        scan_ffn,
        variable_broadcast="params",
        split_rngs={"params": False, "dropout": True},
        in_axes=scan_axis,
        out_axes=scan_axis,
    )(remat_ffn, None, inputs)
    res = rearrange(res, 'b c n d -> b (c n) d')
    return res
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 块级FFN计算 | 将FFN计算与块级attention融合 | 内存节省4倍 |
| 双层循环结构 | 外层query块,内层key-value块 | 保持计算正确性 |
| 无近似计算 | 计算精确attention,非近似 | 与标准Transformer输出一致 |
| 兼容梯度检查点 | 可与gradient checkpointing结合 | 进一步优化内存 |
五、代码实现分析
项目结构
llm_large_context/
├── README.md
├── requirements.txt
└── bpt/
    ├── __init__.py
    ├── attention.py      # 块级attention实现
    ├── ffn.py            # 块级FFN实现
    └── transformer.py    # BPT Transformer层
关键实现细节
- 框架:Jax/Flax
- 分布式训练:支持FSDP
- 精度:bfloat16 matmul + float32累加(TPU默认)
- 块大小搜索:从[16, 64, 128, 512, 1024, 2048, 4096]中网格搜索最优块大小
六、实验结果
实验设置
- 硬件:1-8× A100 GPU, 64× TPUv4
- 模型规模:1B - 70B参数
- 数据集:OpenWebText
- 优化器:Adam, weight decay 0.1, cosine lr decay, max lr 2.0×10⁻⁴
上下文长度对比
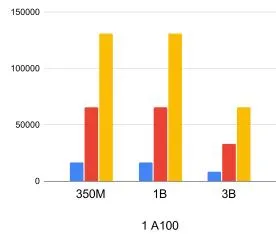
Figure 1(A): 单GPU上不同方法的最大上下文长度。
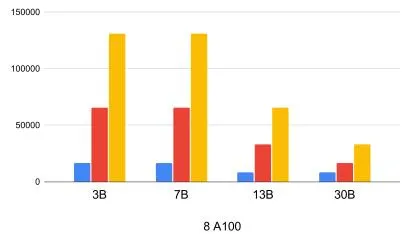
Figure 1(B): 8×A100上不同方法的最大上下文长度。
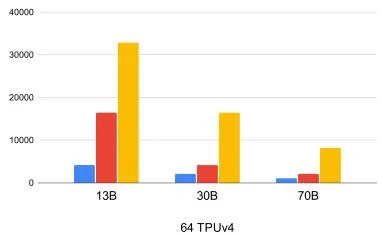
Figure 1: 不同方法在GPT模型训练时的最大上下文长度。模型规模从1B到70B。BPT支持比vanilla Transformer长32倍的序列,比FlashAttention长2-4倍。
关键结果
| 方法 | 相对vanilla Transformer | 相对FlashAttention |
|---|---|---|
| BPT | 32×更长 | 2-4×更长 |
吞吐量对比
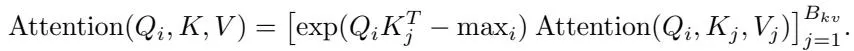
Figure 5: 吞吐量对比(tokens/device/second)。
训练损失
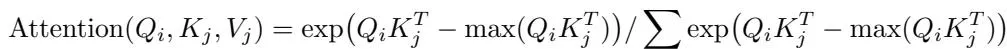
Figure 4: 训练损失曲线对比。
强化学习应用
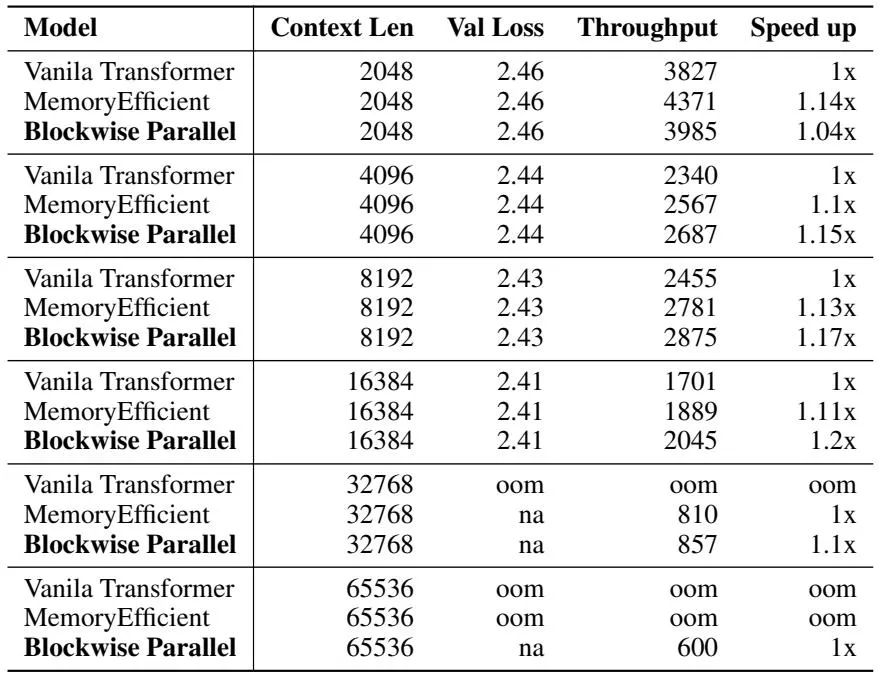
Figure 6: 在RL任务上的性能对比。通过conditioning on多个trajectories,BPT显著提升性能。
消融实验
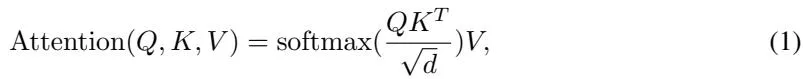
Figure 7: 块大小对性能的影响。
内存分析
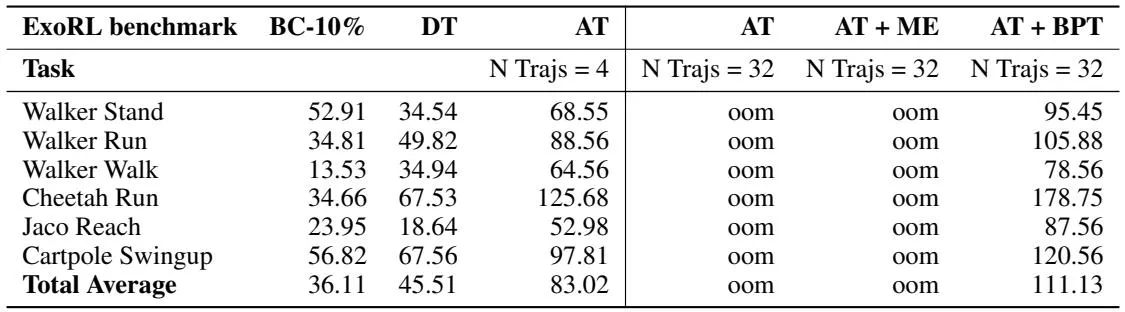
Figure 8: 各组件内存分解。
超参数配置(RL实验)
| 超参数 | 值 |
|---|---|
| 层数 | 3 |
| 注意力头数 | 1 |
| 嵌入维度 | 128 |
| 激活函数 | ReLU |
| 批大小 | 64 |
| Dropout | 0.1 |
| 学习率 | 10⁻⁴ |
| 学习率衰减 | 线性warmup 10⁵步 |
| 梯度裁剪 | 0.25 |
| Weight decay | 10⁻⁴ |
| 训练trajectories数 | 4 → 32 |
| 测试trajectories数 | 4 → 16 |
七、相关工作
| 方法 | 特点 | BPT优势 |
|---|---|---|
| FlashAttention | 块级attention,FFN未优化 | FFN也块级化,内存节省4倍 |
| Memory Efficient Attention | 类似FlashAttention | 同上 |
| Reformer | LSH attention | 计算精确,非近似 |
| Linformer | 低秩近似 | 无近似误差 |
| Performer | 核方法近似 | 无近似误差 |
| Longformer | 稀疏attention | 支持任意attention模式 |
八、总结
核心贡献
- 块级FFN计算:首次将FFN计算与块级attention融合,实现内存高效训练
- 4倍内存节省:激活内存从8bsh降至2bsh
- 32倍更长上下文:比vanilla Transformer支持长32倍的序列
- 精确计算:无近似误差,输出与标准Transformer一致
技术影响
BPT展示了块级并行计算不仅适用于attention,也适用于FFN。这一发现对长序列Transformer训练具有重要意义:
- 训练效率:可在相同硬件上训练更长序列
- 模型扩展:支持更大模型在长序列上的训练
- 应用扩展:适用于需要长上下文的任务(代码、文档、对话)
局限性
- 计算顺序:块级计算可能降低并行度
- 块大小选择:需要网格搜索最优块大小
- 实现复杂度:需要仔细实现以保持计算正确性
未来方向
- 与其他内存优化技术(如梯度检查点、混合精度)结合
- 扩展到更大规模模型(100B+)
- 探索自适应块大小策略
九、参考资源
- 论文: arXiv:2305.19370
- 代码: GitHub - llm_large_context
- FlashAttention: GitHub - FlashAttention
- Jax: Jax Documentation
- Flax: Flax Documentation