Recommender Systems with Generative Retrieval
TIGER 框架将推荐重新定义为生成式检索任务,使用 RQ-VAE 生成 Semantic ID,Transformer 自回归解码预测下一个物品,在多个数据集上超越 SOTA
Recommender Systems with Generative Retrieval
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Recommender Systems with Generative Retrieval |
| 作者 | Shashank Rajput, Nikhil Mehta, Anima Singh, Raghunandan H. Keshavan, Trung Vu, Lukasz Heldt, Lichan Hong, Yi Tay, Vinh Q. Tran, Ed H. Chi, Jonah Samost, Maciej Kula, Maheswaran Sathiamoorthy |
| 机构 | Google DeepMind, Google, University of Wisconsin-Madison |
| 论文 | arXiv:2305.05065 |
| 发布 | 2023-05-08 (v1), 2023-11-03 (v3) |
| 会议 | NeurIPS 2023 |
| 许可 | 未明确 |
二、核心思想
问题定义
传统推荐系统的检索阶段采用”嵌入+近似最近邻搜索”范式:
- 将查询和候选物品嵌入到统一向量空间
- 使用 ANN 算法(如 MIPS)检索 top-K 候选
核心瓶颈:
- 需要维护大规模索引结构
- 随机原子 ID 无法捕获物品语义
- 冷启动物品缺乏交互历史,无法被检索
解决方案概述
TIGER (Transformer Index for GEnerative Recommenders) 提出全新范式:
- Semantic ID:使用 RQ-VAE 对物品内容嵌入进行残差量化,生成语义有意义的离散 ID
- 生成式检索:Transformer seq2seq 模型自回归解码预测下一个物品的 Semantic ID
- Transformer 即索引:模型参数本身充当语义索引,无需额外索引结构
三、技术架构
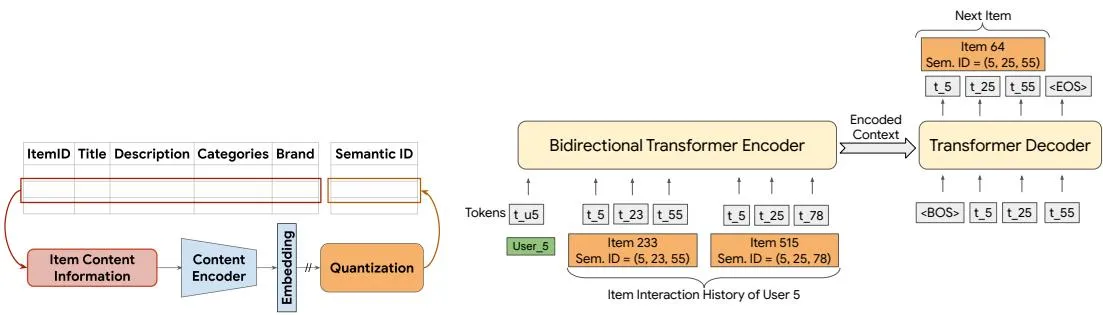
整体框架图
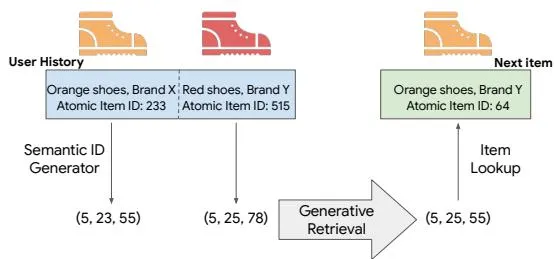
TIGER Framework
├── Stage 1: Semantic ID Generation (Offline)
│   ├── Input: Item content features (title, price, brand, category)
│   ├── Sentence-T5 → 768-dim content embedding
│   ├── RQ-VAE Quantization
│   │   ├── Encoder: 3 layers (512→256→128) + ReLU
│   │   ├── 3-level Residual Quantization (codebook size=256 each)
│   │   └── Output: 3-tuple Semantic ID (c₁, c₂, c₃)
│   └── Collision Resolution: Append 4th token for uniqueness
├── Stage 2: Generative Retrieval (Training)
│   ├── Input: User ID token + Semantic ID sequence
│   │   e.g., [user_hash, c₁⁽¹⁾, c₂⁽¹⁾, c₃⁽¹⁾, c₄⁽¹⁾, ..., c₁⁽ⁿ⁾, c₂⁽ⁿ⁾, c₃⁽ⁿ⁾, c₄⁽ⁿ⁾]
│   ├── Transformer Encoder-Decoder (4 layers, 6 heads, d=64)
│   └── Output: Predict Semantic ID of next item (c₁⁽ⁿ⁺¹⁾, c₂⁽ⁿ⁺¹⁾, c₃⁽ⁿ⁺¹⁾, c₄⁽ⁿ⁺¹⁾)
└── Stage 3: Inference
    ├── Autoregressive decoding of Semantic ID tokens
    ├── Beam search for top-K candidates
    └── Lookup table to map Semantic ID → item
核心公式
RQ-VAE 残差量化过程:
其中 是第 级残差, 是码本中最接近的向量, 是对应的码字索引。
量化重建:
RQ-VAE 损失函数:
其中 是 stop-gradient 操作,。
Semantic ID 层次结构
Semantic ID (c₁, c₂, c₃, c₄)
├── c₁ (粗粒度): 对应物品大类
│   e.g., c₁=3 → Hair 相关产品
│   e.g., c₁=1 → Makeup/Skin 产品
├── c₂ (中粒度): 细分类别
│   e.g., (1, *, *) → Makeup 细分
└── c₃ (细粒度): 具体子类别
    e.g., (1, 5, *) → Makeup Face 子类别
└── c₄ (唯一性): 解决碰撞
    e.g., (7, 1, 4, 0) 和 (7, 1, 4, 1) 表示两个不同物品
RQ-VAE 量化过程
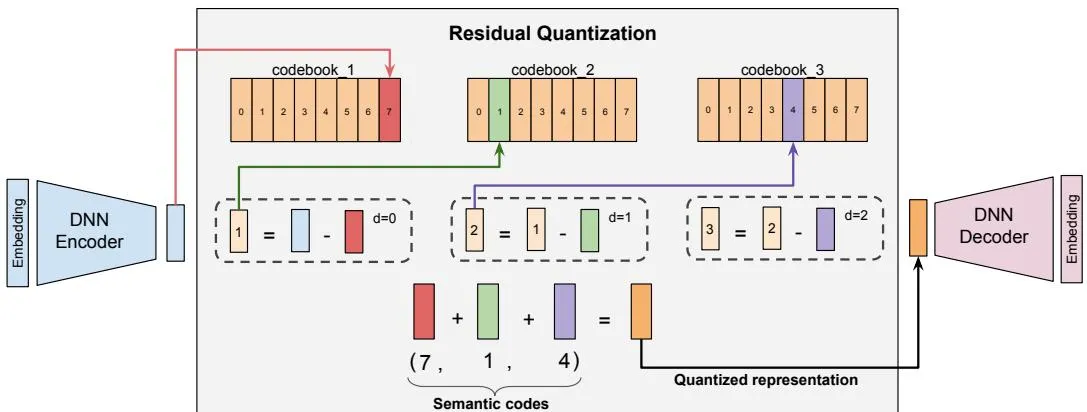
关键特性:
- 层次化表示:从粗到细逐步细化
- 相似物品共享前缀码字
- 码本大小:每级 K=256,共 m=3 级
- 总 ID 空间:256³ = 16,777,216
- 碰撞处理后:长度为 4 的唯一 ID
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Semantic ID | 使用 RQ-VAE 生成语义有意义的离散 ID | 图 4,表 2 |
| 生成式检索 | Transformer 自回归解码预测物品 ID | 图 1,表 1 |
| Transformer 即索引 | 模型参数充当语义索引,无需额外索引 | 图 1 |
| 冷启动能力 | 未见物品可通过语义 ID 被检索 | 图 5 |
| 可调多样性 | 温度采样控制推荐多样性 | 表 3-4 |
五、实验结果
主要性能对比
| 方法 | Sports@5 | Sports@10 | Beauty@5 | Beauty@10 | Toys@5 | Toys@10 |
|---|---|---|---|---|---|---|
| P5 | 0.0061 | 0.0095 | 0.0163 | 0.0254 | 0.0070 | 0.0121 |
| Caser | 0.0116 | 0.0194 | 0.0205 | 0.0347 | 0.0166 | 0.0270 |
| HGN | 0.0189 | 0.0313 | 0.0325 | 0.0512 | 0.0321 | 0.0497 |
| GRU4Rec | 0.0129 | 0.0204 | 0.0164 | 0.0283 | 0.0097 | 0.0176 |
| BERT4Rec | 0.0115 | 0.0191 | 0.0203 | 0.0347 | 0.0116 | 0.0203 |
| SASRec | 0.0233 | 0.0350 | 0.0387 | 0.0605 | 0.0463 | 0.0675 |
| S³-Rec | 0.0251 | 0.0385 | 0.0387 | 0.0647 | 0.0443 | 0.0700 |
| TIGER | 0.0264 | 0.0400 | 0.0454 | 0.0648 | 0.0521 | 0.0712 |
| 提升 | +5.2% | +3.9% | +17.3% | +0.2% | +12.5% | +1.7% |
关键发现:
- TIGER 在所有数据集上超越所有 baseline
- Beauty 数据集提升最大:NDCG@5 +29.0%,Recall@5 +17.3%
- Toys and Games:NDCG@5 +21.2%,NDCG@10 +15.0%
消融实验:ID 生成方式
| 方法 | Sports@5 | Sports@10 | Beauty@5 | Beauty@10 |
|---|---|---|---|---|
| Random ID | 0.007 | 0.0116 | 0.0296 | 0.0434 |
| LSH SID | 0.0215 | 0.0321 | 0.0379 | 0.0533 |
| RQ-VAE SID | 0.0264 | 0.0400 | 0.0454 | 0.0648 |
发现:
- RQ-VAE Semantic ID 显著优于 Random ID(+277% Recall@5 on Sports)
- RQ-VAE 优于 LSH(+23% Recall@5 on Sports)
- 语义有意义的 ID 是性能关键
冷启动推荐
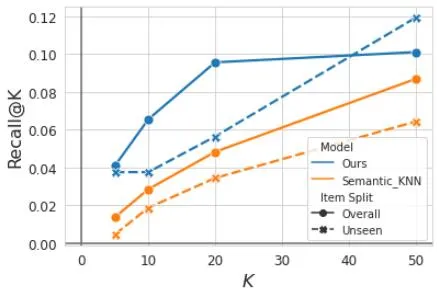
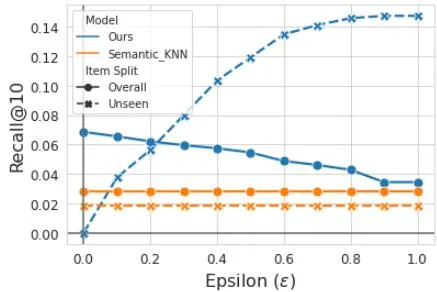
实验设置:移除 5% 测试物品作为”未见物品”
发现:
- TIGER 在所有 Recall@K 上优于 Semantic KNN
- ε=0.1 时已显著优于 baseline
- 未见物品可通过共享的 Semantic ID 前缀被检索
推荐多样性
| 温度 T | Entropy@10 | Entropy@20 | Entropy@50 |
|---|---|---|---|
| 1.0 | 0.76 | 1.14 | 1.70 |
| 1.5 | 1.14 | 1.52 | 2.06 |
| 2.0 | 1.38 | 1.76 | 2.28 |
发现:温度采样可有效控制推荐多样性
六、模型配置
RQ-VAE 配置
| 参数 | 值 |
|---|---|
| 预训练编码器 | Sentence-T5 (768-dim) |
| DNN 编码器 | 3 层 (512→256→128) + ReLU |
| 潜在维度 | 32 |
| 量化级别 | 3 级 |
| 码本大小 | 256 (每级) |
| β | 0.25 |
| 训练轮数 | 20k epochs |
| 优化器 | Adagrad (lr=0.4) |
| 批大小 | 1024 |
| 码本使用率 | ≥80% |
Transformer 配置
| 参数 | 值 |
|---|---|
| 编码器层数 | 4 |
| 解码器层数 | 4 |
| 注意力头数 | 6 |
| 头维度 | 64 |
| MLP 维度 | 1024 |
| 输入维度 | 128 |
| Dropout | 0.1 |
| 词表大小 | 1024 (256×4) + 2000 (user) |
| 总参数量 | ~13M |
| 训练步数 | 200k (Beauty/Sports), 100k (Toys) |
| 批大小 | 256 |
| 学习率 | 0.01 (前 10k 步) + inverse sqrt decay |
七、相关工作
| 工作 | 方法 | 与 TIGER 的差异 |
|---|---|---|
| SASRec | 自注意力序列推荐 | 学习高维嵌入 + MIPS,非生成式 |
| BERT4Rec | 双向掩码语言模型 | 双向上下文,非自回归 |
| P5 | 微调 LLM | 使用随机 ID + SentencePiece tokenizer |
| VQ-VAE | 向量量化 | 用于迁移推荐,非生成式检索 |
| DSI | 可微分搜索索引 | 文档检索,非推荐系统 |
| GENRE | 自回归实体检索 | 实体检索,非推荐系统 |
八、总结
核心贡献
- 新范式:提出 TIGER,将推荐重新定义为生成式检索任务
- Semantic ID:使用 RQ-VAE 生成层次化语义 ID,替代随机原子 ID
- 性能提升:在 3 个 Amazon 数据集上超越所有 SOTA baseline
- 冷启动能力:未见物品可通过语义 ID 被检索(无需交互历史)
- 可调多样性:温度采样控制推荐多样性
- 无索引架构:Transformer 参数即索引,无需维护额外索引结构
技术影响
- 检索范式转变:从”嵌入+ANN”到”生成式解码”
- 语义表示:Semantic ID 可迁移至排序模型
- 冷启动解决方案:为新物品推荐提供新思路
- 推荐基础模型:为构建推荐系统的基础模型铺路
局限性
- 无效 ID:自回归解码可能生成不在词表中的 ID(0.1%-1.6%)
- 规模验证:实验在 10K-20K 物品数据集上,大规模验证不足
- 词表爆炸:物品规模增大时,Semantic ID 词表可能过大
- 训练复杂度:需要两阶段训练(RQ-VAE + Transformer)
- 个性化有限:用户 ID 通过 Hashing Trick 映射到 2000 个 token
九、参考资源
- 论文: arXiv:2305.05065
- 相关工作:
- 后续工作:
- Better Generalization with Semantic IDs - Semantic ID 在排序模型中的应用