DeepGEMM: Accelerated Ultra Low-Precision Inference on CPU Architectures using
基于查找表的超低精度CNN推理加速方法,2-bit实现比QNNPACK INT8快1.74倍
DeepGEMM: Accelerated Ultra Low-Precision Inference on CPU Architectures using Lookup Tables
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | DeepGEMM: Accelerated Ultra Low-Precision Inference on CPU Architectures using Lookup Tables |
| 作者 | Darshan C. Ganji, Saad Ashfaq, Ehsan Saboori, Sudhakar Sah, Saptarshi Mitra, MohammadHossein AskariHemmat, Alexander Hoffman, Ahmed Hassanien, Mathieu Léonardon |
| 机构 | Deeplite Inc. (Canada), IMT Atlantique (France) |
| 论文 | arXiv:2304.09049 |
| 发布 | 2023年4月18日 |
| 领域 | cs.LG (Machine Learning) |
二、核心思想
问题定义
超低比特量化(如2-bit)在延迟、内存占用和能耗方面具有显著优势,但在主流CPU上部署这些模型极其困难,因为商品化SIMD硬件通常不支持低于8-bit的精度。
具体挑战:
- x86平台的SSE/AVX指令集和Arm平台的Neon指令集最低支持8-bit精度
- 超低比特模型无法直接利用现有的SIMD加速
- 现有的超低比特实现(如bit-serial、ULPPACK)主要针对Arm平台
解决方案概述
本文提出DeepGEMM,一种基于查找表(LUT)的方法,在SIMD硬件上执行超低精度卷积神经网络:
核心思想:
- 预计算所有可能的权重和激活乘积
- 存储在查找表中
- 推理时通过高效访问LUT避免昂贵的乘累加(MAC)操作
核心成果:
- 2-bit实现比QNNPACK INT8快1.74倍(x86平台)
- 端到端加速最高1.68倍
- 兼容均匀和非均匀量化
- 支持有符号和无符号数据
三、技术架构
整体框架图
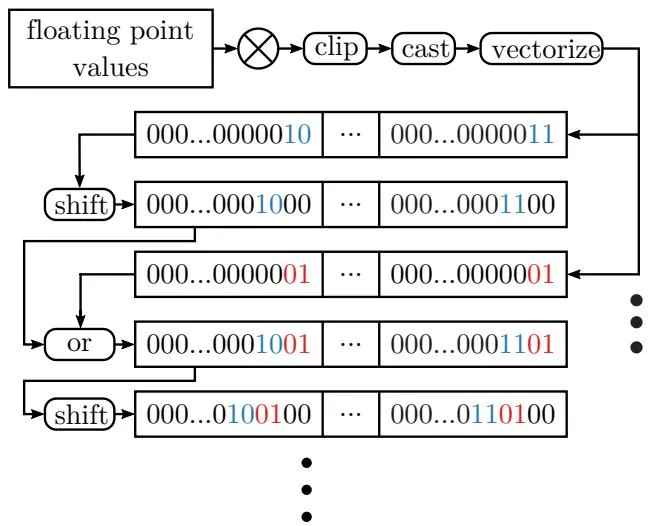
Figure 1(a): 向量化打包 - 浮点权重和激活值被量化为超低比特并转换为整数,然后使用位移和OR操作打包为更高精度数据类型。
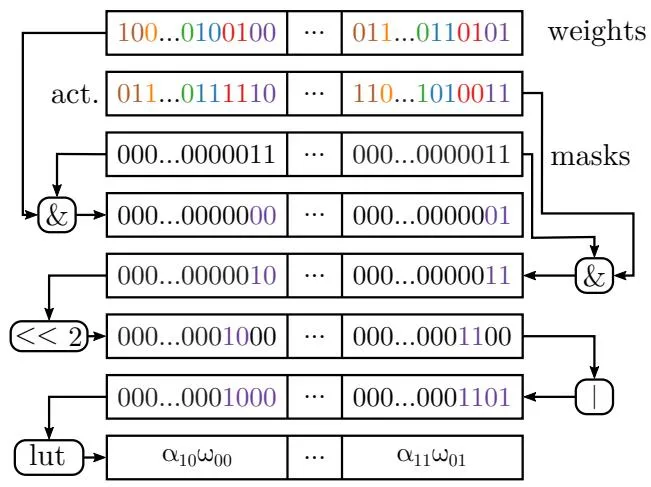
Figure 1(b): 向量化解包 - 超低比特权重和激活值从打包数据类型中提取,并连接形成LUT访问索引。
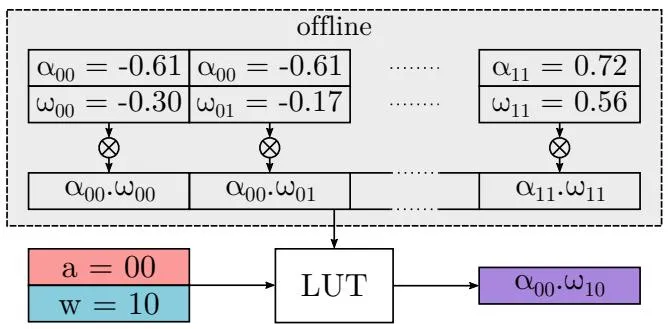
Figure 2: 查找表访问 - 预计算的超低比特激活和权重乘积通过对应索引从LUT中检索。
核心公式
量化基础
均匀量化公式:
其中 是缩放因子, 是零点。
LUT索引构建
对于2-bit量化,权重 和激活 的所有乘积预计算并存储在LUT中。
索引构建:
LUT访问:
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| LUT-16 | 16条目的查找表 | 2-bit权重+2-bit激活,128-bit LUT |
| LUT-65k | 65536条目的查找表 | 4个2-bit值的点积,64KB LUT |
| 打包方案 | 多种向量化打包策略 | 方案(a)-(d),4-5.5条指令/输出 |
| AVX2实现 | x86 SIMD优化 | 256-bit向量寄存器 |
训练流程
DeepGEMM采用离线量化方案:
- 权重的打包和量化在离线完成(训练后)
- 推理时仅需执行激活量化、打包、LUT卷积和反量化
- 支持LSQ等量化感知训练方法
算法流程
Algorithm 1: DeepGEMM算法伪代码
mask: 寄存器,提取8-bit元素的最低2位
lookup_table: 包含所有2-bit值乘积组合的查找表
lut ← addr[lookup_table]
vec_a ← addr[act_tensor]
vec_w ← addr[w_tensor]
for i ← 0 to 4 do
    shift = i * 2
    index = ((vec_w >> shift) & mask) | ((vec_a >> shift) & mask)
    res = shuffle(lut, index)
end for
reduction_sum
打包方案对比
| 方案 | AND | Shift | OR | Shuffle | 总计 |
|---|---|---|---|---|---|
| (a) 自然顺序 | 2 | 1.5 | 1 | 1 | 5.5 |
| (b) 优化mask | 2 | 1 | 0.5 | 1 | 4.5 |
| (c) 重排权重 | 2 | 0.5 | 1 | 1 | 4.5 |
| (d) 组合优化 | 2 | 0.5 | 0.5 | 1 | 4 |
LUT-16与LUT-65k对比
| 特性 | LUT-16 | LUT-65k |
|---|---|---|
| LUT条目 | ||
| LUT大小 | 128 bits (1个AVX2寄存器) | 64KB (L2缓存) |
| 索引构建 | 需要显式mask和shift | 仅需8-bit交织 |
| 灵活性 | 支持更高比特扩展 | 固定2-bit |
可扩展性
| 比特宽度 | 索引宽度 | LUT条目 | LUT大小 | AVX2寄存器 |
|---|---|---|---|---|
| 2-bit | 4-bit | 16 | 128 bits | 1 |
| 3-bit | 6-bit | 64 | 512 bits | 2 |
| 4-bit | 8-bit | 256 | 2048 bits | 8 |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| LUT替代MAC | 用查找表替换乘累加操作 | shuffle指令比乘法更快 |
| 向量化打包/解包 | 高效的位操作打包方案 | 仅需4-5.5条指令/输出 |
| 灵活量化支持 | 兼容均匀/非均匀、有符号/无符号 | LUT可存储整数或浮点值 |
| 离线预计算 | 权重LUT离线准备 | 减少推理时计算 |
| x86平台优化 | 针对AVX2指令集优化 | 256-bit向量寄存器 |
与其他方法对比
| 方法 | 平台 | 量化支持 | 数据类型 |
|---|---|---|---|
| DeepGEMM | x86 | 2-bit+ | 整数/浮点 |
| QNNPACK | x86/Arm | 8-bit | 整数 |
| Bit-serial | Arm | 1-3 bit | 整数 |
| ULPPACK | Arm/x86 | sub-8-bit | 整数 |
| Bitflow | x86 (Xeon Phi) | 1-bit | 整数 |
DeepGEMM的独特优势
- 非均匀量化支持:LUT可存储浮点值,兼容LCQ等非均匀量化方法
- 有符号/无符号统一:相同延迟,无需额外操作
- 算子融合潜力:量化常数在编译时已知,可融合量化+卷积+反量化
五、实验结果
基准测试
实验环境:
- 平台:Intel i7 9700k @ 3.6GHz
- 基线:QNNPACK INT8
- 模型:MobileNetV1, ResNet18, ResNet34, ResNet50
精度对比 (ImageNet Top-1)
| 模型 | 32-bit | 8-bit | 2-bit (LSQ) |
|---|---|---|---|
| ResNet18 | 70.5% | 71.1% | 67.9% (-2.6%) |
| ResNet34 | 74.1% | 74.1% | 72.4% (-1.7%) |
| ResNet50 | 76.9% | 76.8% | 74.6% (-2.3%) |
| VGG16 | 73.4% | 73.5% | 71.4% (-2.0%) |
结论:2-bit量化仅损失1.7-2.6%精度。
算子级加速
| 模型 | 几何平均加速 (vs QNNPACK INT8) |
|---|---|
| MobileNetV1 | 1.74× |
| ResNet18 | 1.64× |
| ResNet34 | 1.67× |
| ResNet50 | 1.57× |
| 平均 | 1.66× |
端到端加速
| 模型 | 端到端加速 (vs QNNPACK INT8) |
|---|---|
| ResNet18 | 1.62× |
| ResNet34 | 1.68× |
| ResNet50 | 1.59× |
| ResNeXt101 | 1.50× |
| GoogleNet | 1.50× |
| InceptionV3 | 1.58× |
| 平均 | 1.58× |
性能分析
- K维度越大,加速越高:DeepGEMM沿K维度向量化
- Lut-Conv是主要瓶颈:占总执行时间的57-77%
- 解包占Lut-Conv的80%:是最耗时的步骤
- 激活量化对小层开销显著:可通过算子融合优化
与ULPPACK对比
在MobileNetV1子集上:
- ULPPACK: 1.77× (几何平均加速)
- DeepGEMM: 1.74× (几何平均加速)
DeepGEMM提供与SOTA相当的性能,同时具有更多灵活性。
六、相关工作
8-bit推理库
- QNNPACK:高度优化的8-bit库,集成于PyTorch
- NCNN/gemmlowp:高效8-bit GEMM实现
- CMSIS-NN:Arm Cortex-M处理器的8-bit优化
超低比特推理
- Bit-serial:使用AND和popcount操作,主要针对Arm
- ULPPACK:将sub-byte值打包到8-bit整数中
- Bitflow:二进制网络实现,使用AVX512
- [11]:使用Arm Neon指令集的MAC向量化
七、总结
核心贡献
- 新颖的LUT方法:用查找表替代MAC操作,实现超低比特CPU推理
- DeepGEMM框架:灵活的超低精度卷积算子,兼容多种量化技术
- 详细性能分析:内核、算子和模型级别的全面性能剖析
- x86平台优化:针对AVX2指令集的向量化实现
技术影响
- 边缘部署:使超低比特模型在CPU上高效运行
- 混合精度:支持敏感层保持高精度,非敏感层降至超低精度
- 非均匀量化:首次支持浮点LUT条目的超低比特推理
- 算子融合:量化常数编译时已知,可融合多个算子
局限性
- 当前仅支持2-bit:3-bit和4-bit扩展需要更大LUT
- 平台限制:目前仅实现x86,Arm移植仍在开发中
- 解包开销:解包步骤占Lut-Conv的80%,是主要瓶颈
- 小层量化开销:激活量化对小层增加显著开销
未来工作
- 更高效的解包方案
- Arm平台移植
- 3-bit和4-bit支持
- 算子融合优化
八、参考资源
- 论文: arXiv:2304.09049
- PDF: arxiv.org/pdf/2304.09049
引用
@article{ganji2023deepgemm,
  title={DeepGEMM: Accelerated Ultra Low-Precision Inference on CPU Architectures using Lookup Tables},
  author={Ganji, Darshan C. and Ashfaq, Saad and Saboori, Ehsan and Sah, Sudhakar and Mitra, Saptarshi and AskariHemmat, MohammadHossein and Hoffman, Alexander and Hassanien, Ahmed and L{\'e}onardon, Mathieu},
  journal={arXiv preprint arXiv:2304.09049},
  year={2023}
}