Causal Deep Learning Causal Inference Deep Learning Structural Causal Models Treatment Effects Framework Paradigm Shift
Causal Deep Learning: Encouraging Impact on Real-World Problems Through Causality
剑桥大学提出的CDL框架,通过结构、参数和时间三维度对因果深度学习进行系统分类,弥合因果推理与深度学习的鸿沟
Causal Deep Learning: Encouraging Impact on Real-World Problems Through Causality
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Causal Deep Learning: Encouraging Impact on Real-World Problems Through Causality |
| 作者 | Jeroen Berrevoets, Krzysztof Kacprzyk, Zhaozhi Qian, Mihaela van der Schaar |
| 机构 | DAMTP, University of Cambridge; The Alan Turing Institute |
| 论文 | arXiv:2303.02186 |
| 发布 | 2023-03-03 (v1), 2024-02-14 (v2, 最终版) |
| 许可 | CC BY 4.0 |
| 页数 | 34页 |
| 领域 | Machine Learning (cs.LG); Artificial Intelligence (cs.AI) |
二、核心思想
问题定义
因果推理有潜力真正改变我们解决大量现实世界问题的方式,但其潜力很大程度上仍未被释放,原因在于:
- 因果方法需要关键假设,而这些假设在实践中往往无法检验
- 从业者因可用因果知识不足而回避因果推断
- 对因果知识的强调可能掩盖了统计、函数或时间性质等其他重要考虑因素
当前两大领域的割裂:
- 因果推断:依赖详尽的先验因果知识,许多不可测试
- 深度学习:擅长高维非线性建模,但缺乏因果结构意识
核心洞察
因果推理与深度学习需要融合——我们需要将因果推断与深度学习的强大建模能力相结合,以应对现实世界中高度复杂、非结构化且数据丰富的场景。
解决方案:因果深度学习(CDL)框架
CDL提出了一种三维分类框架,对因果深度学习方法进行系统性组织和指导:
        结构维度          参数维度          时间维度
        ──────────       ──────────        ──────────
    变量间的因果关系    函数的形状/形式     静态 vs 时序
    (不知道→因果)      (非参数→已知)      (时间演化)
三、技术架构
三维度详解
维度1:结构尺度(Structural Scale)
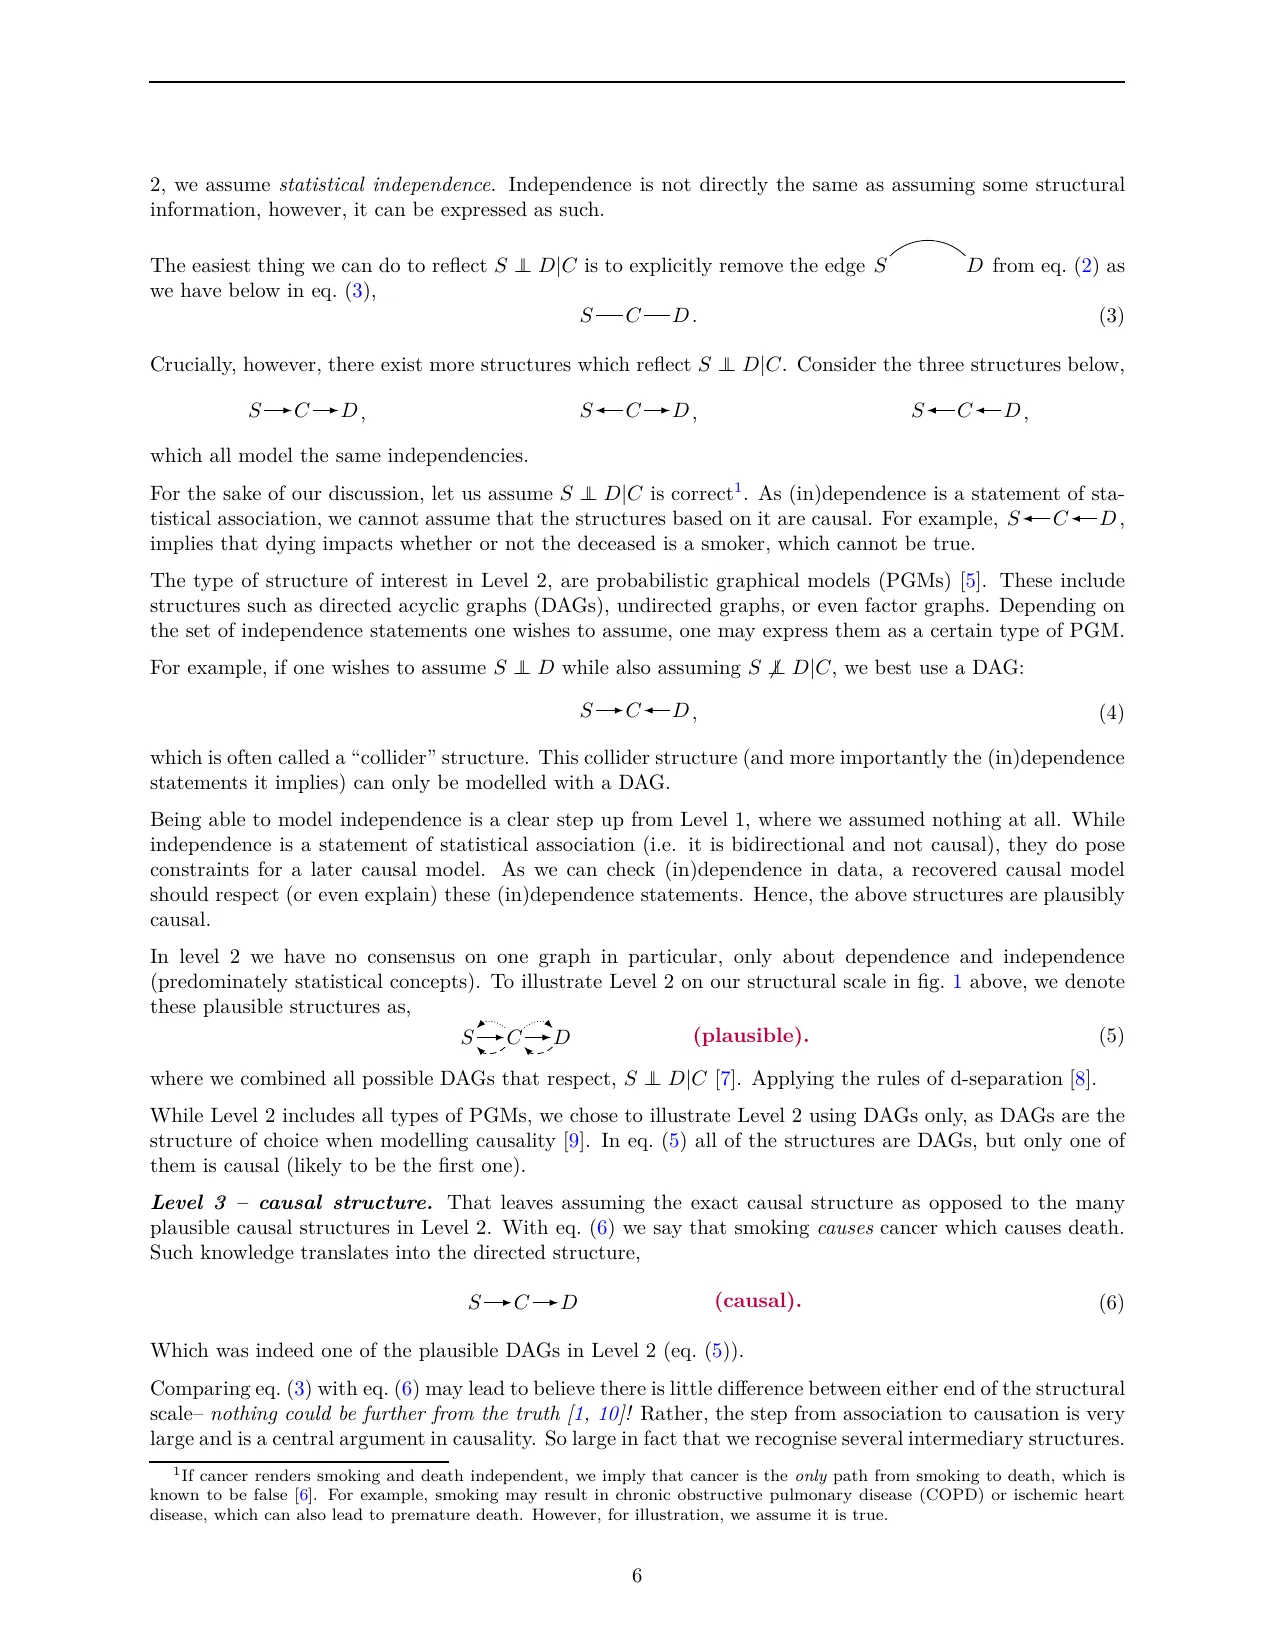
结构尺度衡量我们对变量间关系的知识程度,从少结构到多结构:
| 层级 | 名称 | 描述 | 可检验性 |
|---|---|---|---|
| Level 1 | 未知(Unknown) | 零知识,所有变量在同一因子中 | 无需检验 |
| Level 2 | 似因果(Plausible) | 统计独立性假设(如 PGMs/DAGs) | 可检验! |
| Level 3 | 因果(Causal) | 确切因果结构(如 S→C→D) | 不可检验 |
关键洞察:
- Level 2 对应 Pearl 梯度的” rung 1.5”——比 rung 1(无先验知识)多,但不到 rung 2(干预)
- 因果推断中最大的跳跃是从关联到因果,而非从 Level 1 到 Level 2
- 每个知识层级进一步限定环境,即限制可能的数据分布解释
示例(吸烟 S、癌症 C、死亡 D):
- Level 1: S — C — D(完全连接,零知识)
- Level 2: S ⊥ D | C(条件独立,多个等价DAG)
- Level 3: S → C → D(确切因果方向)
维度2:参数尺度(Parametric Scale)
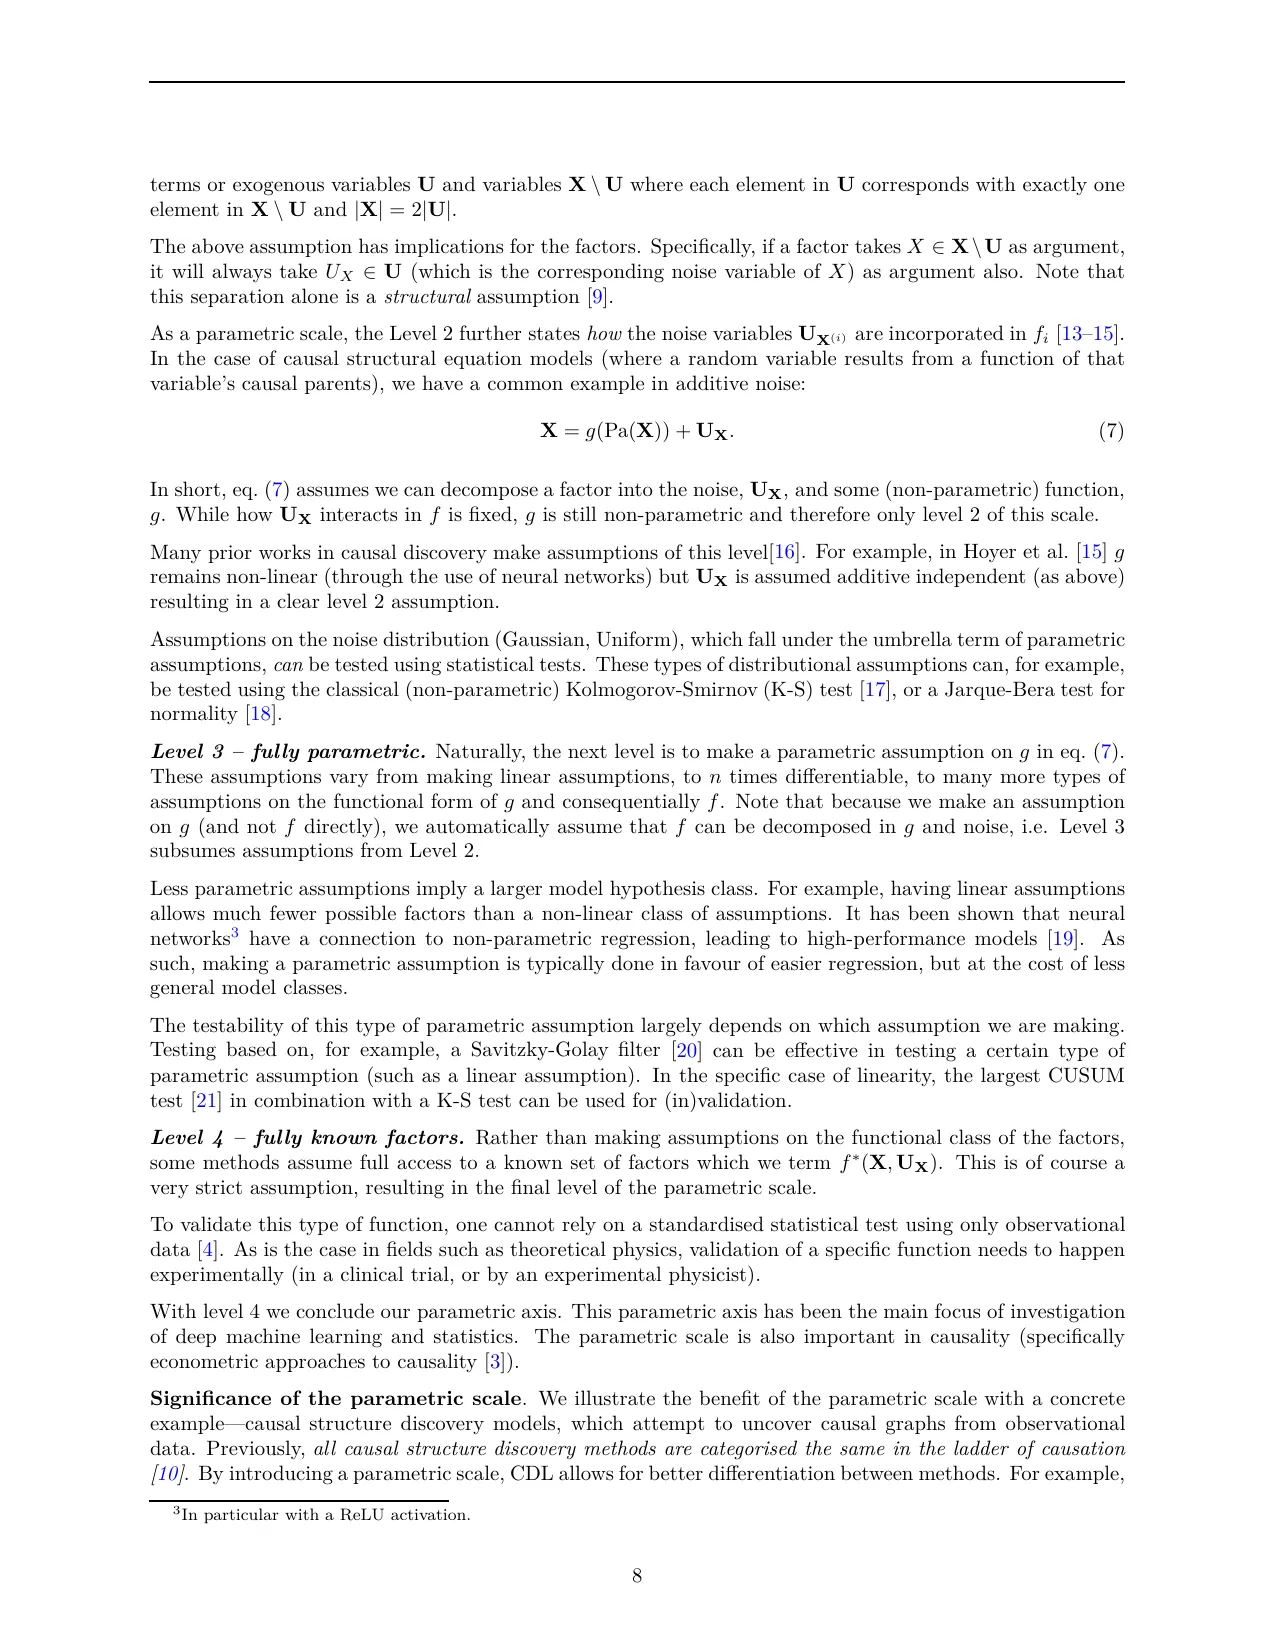
参数尺度刻画对因子函数形式的假设严格程度:
| 层级 | 名称 | 描述 | 示例 |
|---|---|---|---|
| Level 1 | 非参数(NP) | 无任何函数形式假设 | p(X) = (1/Z)∏fᵢ(X⁽ⁱ⁾) |
| Level 2 | 噪声模型(NM) | 假设噪声与函数的交互方式 | X = g(Pa(X)) + Uₓ |
| Level 3 | 参数化(Pa.) | 对 g 做强函数假设 | 线性:X = β·Pa(X) + Uₓ |
| Level 4 | 完全已知(FK) | 函数完全已知 | f*(X, Uₓ) 已知 |
关键洞察:
- Level 3 蕴含 Level 2 的假设(先假设噪声模型,再假设函数形式)
- 非参数方法(如神经网络)灵活但可能过度复杂
- 从观测数据无法标准化检验 Level 4 假设——需要实验验证
示例:
NM: X = g(Pa(X)) + Uₓ  (g非参数,Uₓ加法噪声)
Pa.: X = β·Pa(X) + Uₓ  (g线性)
FK: X = 2·Pa(X) + Uₓ   (g完全已知)
维度3:时间尺度(Temporal Scale)
时间维度区分静态模型与时序模型:
- 静态:每个变量只观测一次
- 时序:同一变量被多次观测(不仅仅是添加时间戳)
时间的重要性:
- 因果先于效应(时间箭头)
- 时序数据可帮助因果发现(Xₜ→Xₜ₊₁ 比 Xₜ₊₁→Xₜ 更合理)
- 时间使问题更复杂(同一变量在不同时间点有不同因果边)
模型指纹与知识转换
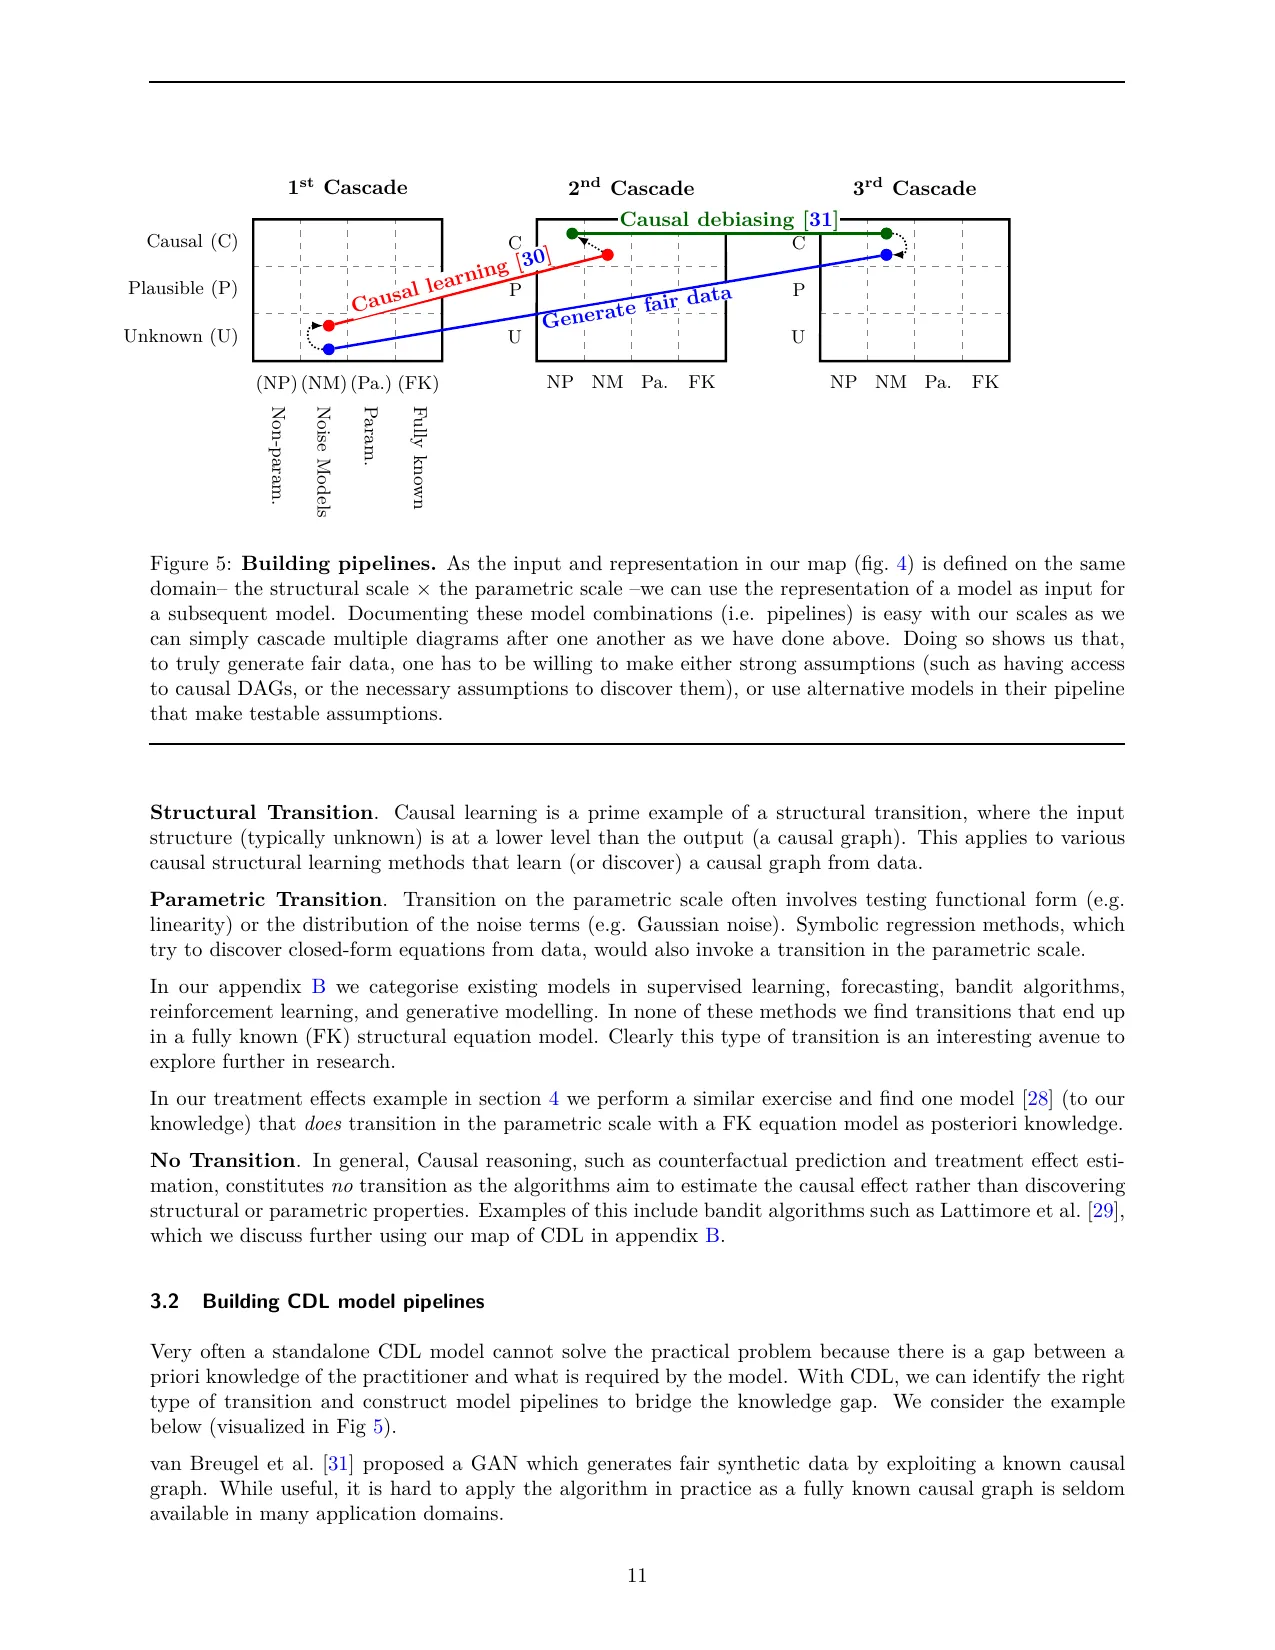
每个CDL方法可通过以下方式”指纹化”:
输入知识(先验): 结构尺度 × 参数尺度
时间属性: 静态 / 时序
输出知识(后验): 结构尺度 × 参数尺度知识转换(Transition):当方法的先验知识与后验知识不同时,称为知识转换:
- 结构转换:如因果学习(输入未知结构 → 输出因果图)
- 参数转换:如符号回归(输入非参数 → 输出已知函数)
- 无转换:如因果推理/反事实预测(目标为估计效应,而非发现结构)
模型流水线构建
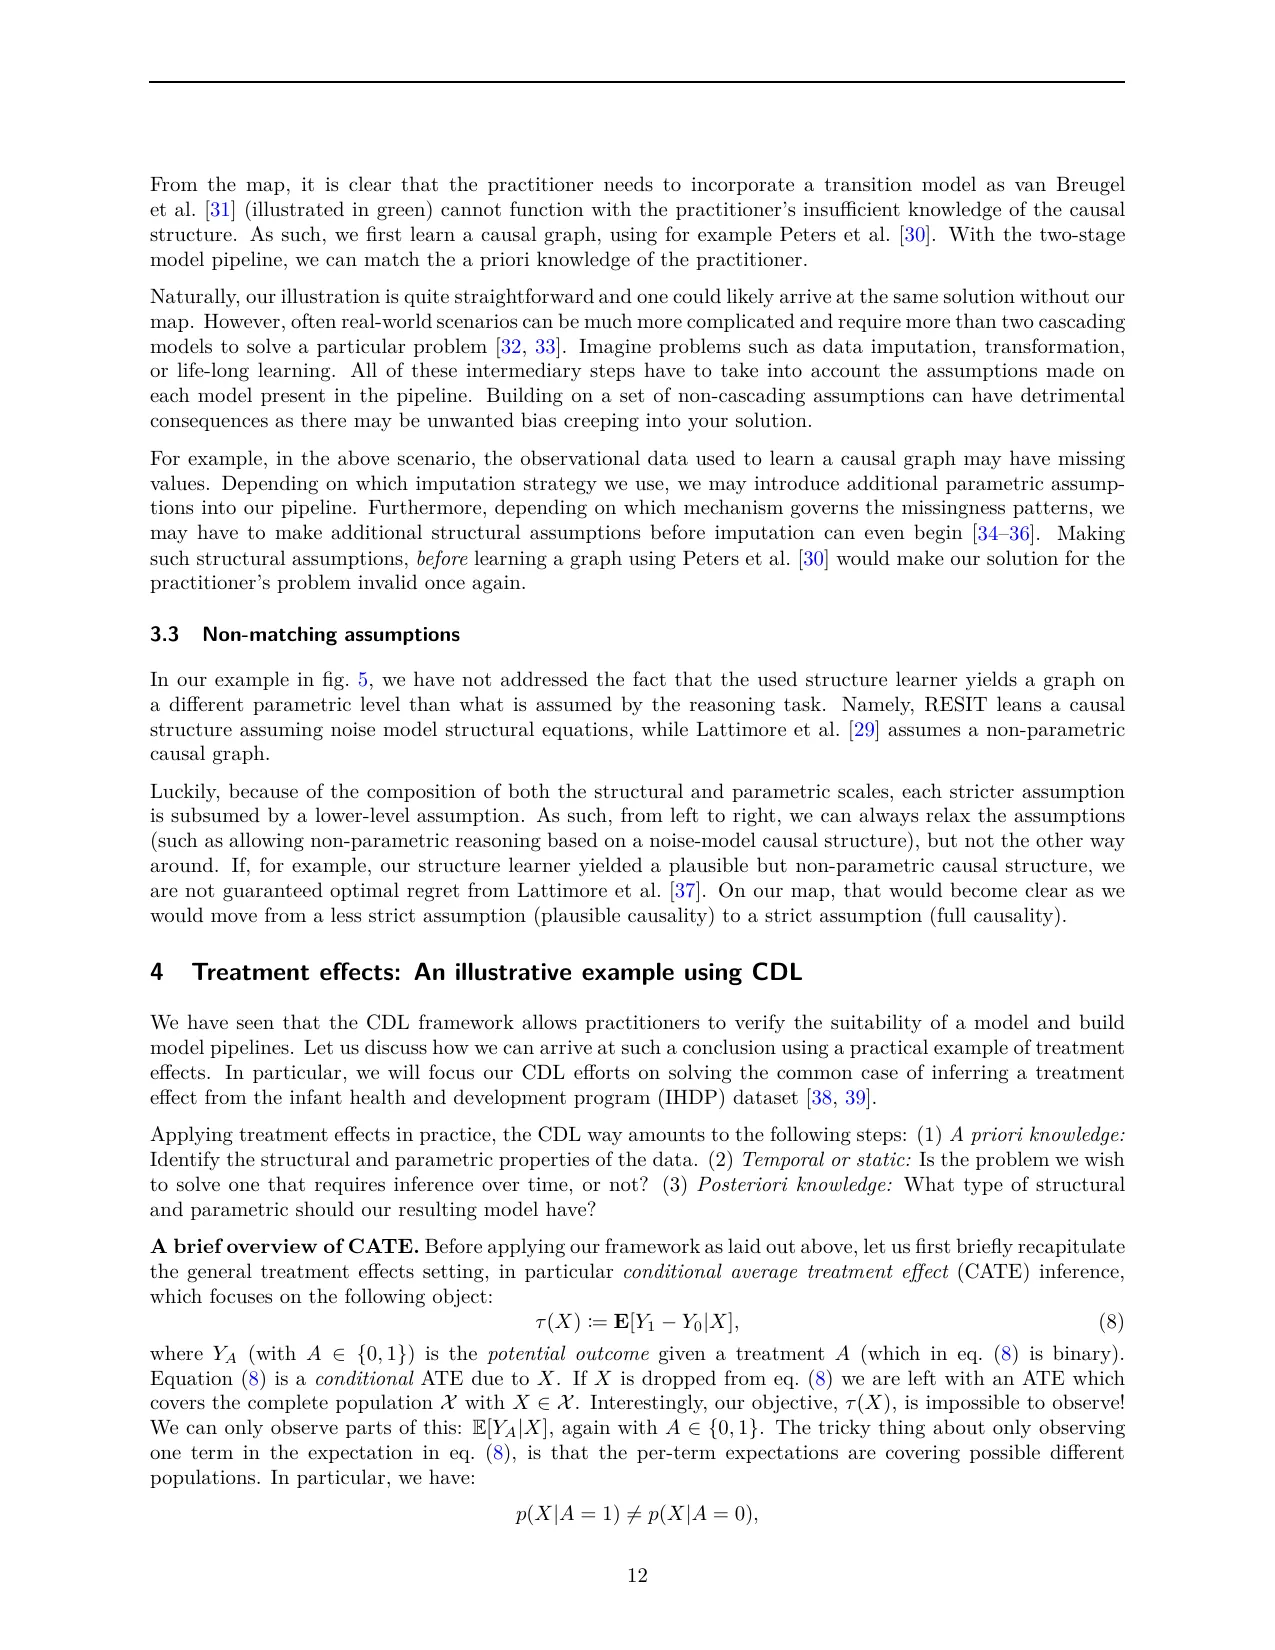
CDL框架的核心实用价值在于构建模型流水线:
观测数据 → [因果结构学习] → 因果图 → [因果推理] → 治疗效应
(U,NP) (U→C, NP) (C) (C) (C)关键原则:
- 每个模型的输入假设必须与前一个模型的输出表示匹配
- 级联假设不匹配的模型可能导致有害偏差
- 从严格到宽松的假设总是安全的(从左到右可放松),反之则不然
四、核心创新
| 创新点 | 说明 | 价值 |
|---|---|---|
| 三维CDL框架 | 结构×参数×时间,全面刻画因果深度学习 | 首次系统组织CDL方法论 |
| 似因果层级(Level 2) | 引入Pearl梯度未涵盖的”rung 1.5” | 容纳概率图模型等实用方法 |
| 参数尺度 | 区分非参数、噪声模型、参数化、完全已知 | 细化深度学习的因果假设分类 |
| 知识转换概念 | 定义模型输入/输出知识的差异 | 帮助识别方法间的兼容性 |
| 模型流水线设计指南 | 级联模型需假设匹配 | 避免有害偏差,指导实际部署 |
| 实证地图 | 对监督学习、预测、强化学习、生成模型全面分类 | 揭示研究空白,指导未来方向 |
五、实证应用分析
5.1 治疗效应(Treatment Effects)
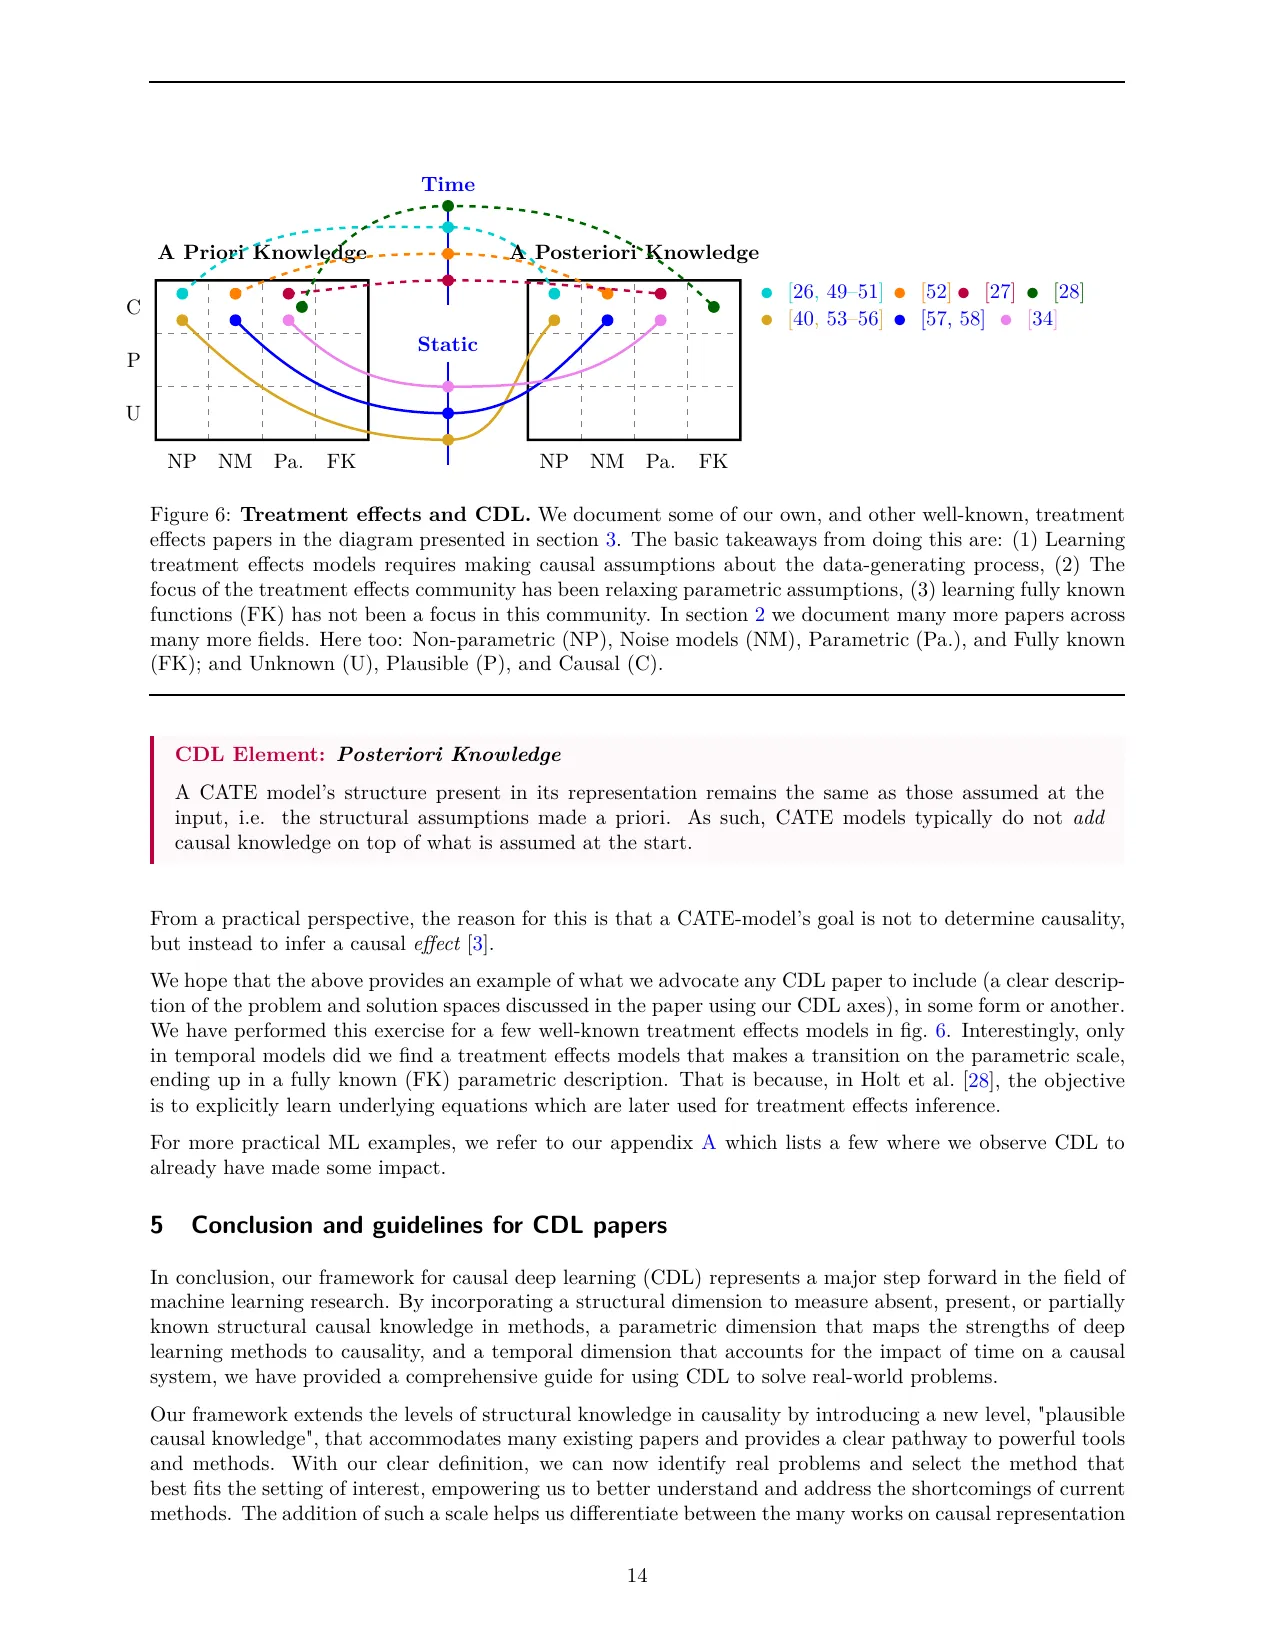
以IHDP数据集上的CATE推断为例,CDL分析显示:
CDL三要素分析:
- 先验知识:结构上假设 A←X→{Yₐ}(因果假设),参数上已知 outcome surfaces 的函数形式
- 时间:IHDP为静态数据,无需时序模型
- 后验知识:CATE模型结构不变,目标是估计效应而非发现结构
关键发现:
- 治疗效应研究聚焦于放松参数假设(从FK/NM到NP)
- 仅有 Holt et al. [28] 在时序设定中实现了参数转换(学到完全已知方程)
- CATE模型通常不做结构转换
5.2 现实世界应用
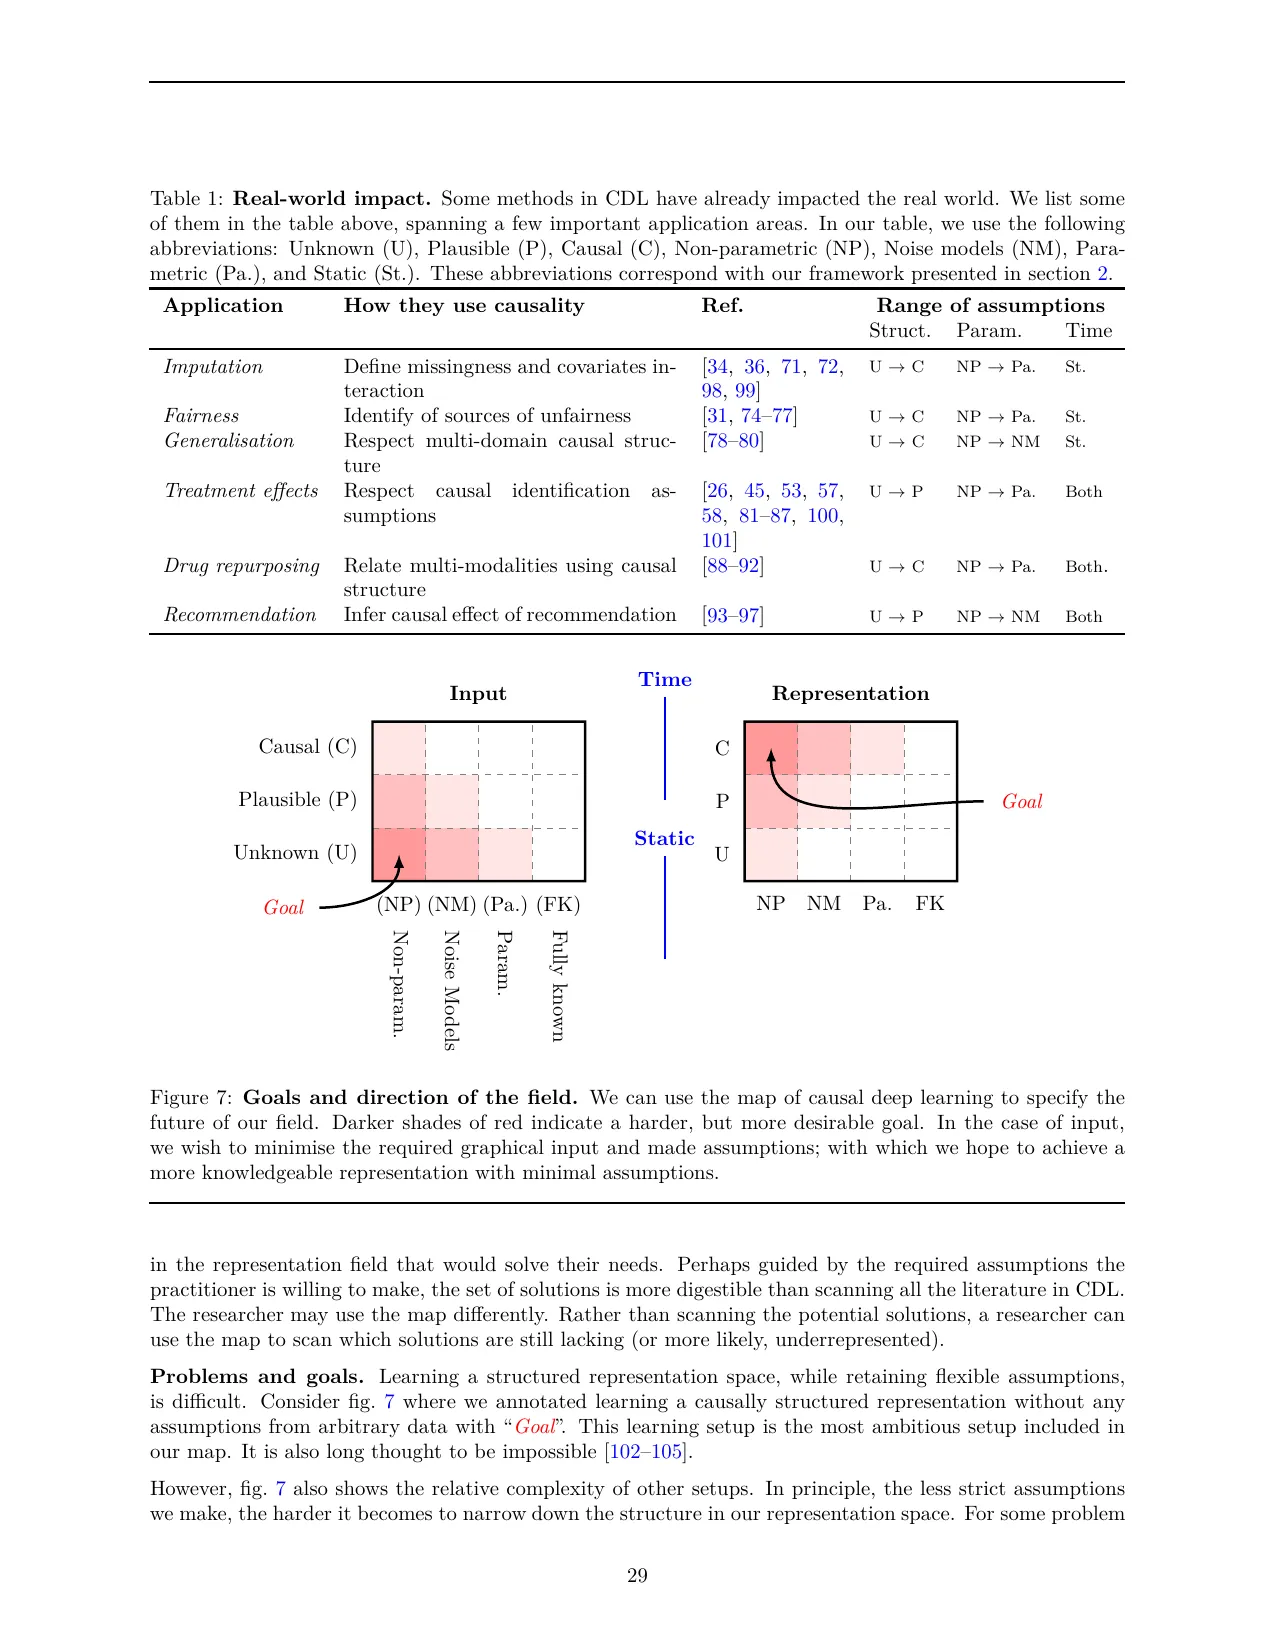
| 应用领域 | 如何使用因果性 | 假设范围 |
|---|---|---|
| 缺失值填补 | 定义缺失性与协变量的交互 | U→C, NP→Pa. |
| 公平性 | 识别不公平源 | U→C, NP→Pa. |
| 泛化 | 约束多域因果结构 | U→C, NP→NM |
| 治疗效应 | 尊重因果识别假设 | U→P, NP→Pa. |
| 药物重定位 | 结合泛化与治疗效应 | U→C, NP→Pa. |
| 推荐系统 | 推断推荐因果效应 | U→P, NP→NM |
5.3 监督学习分类
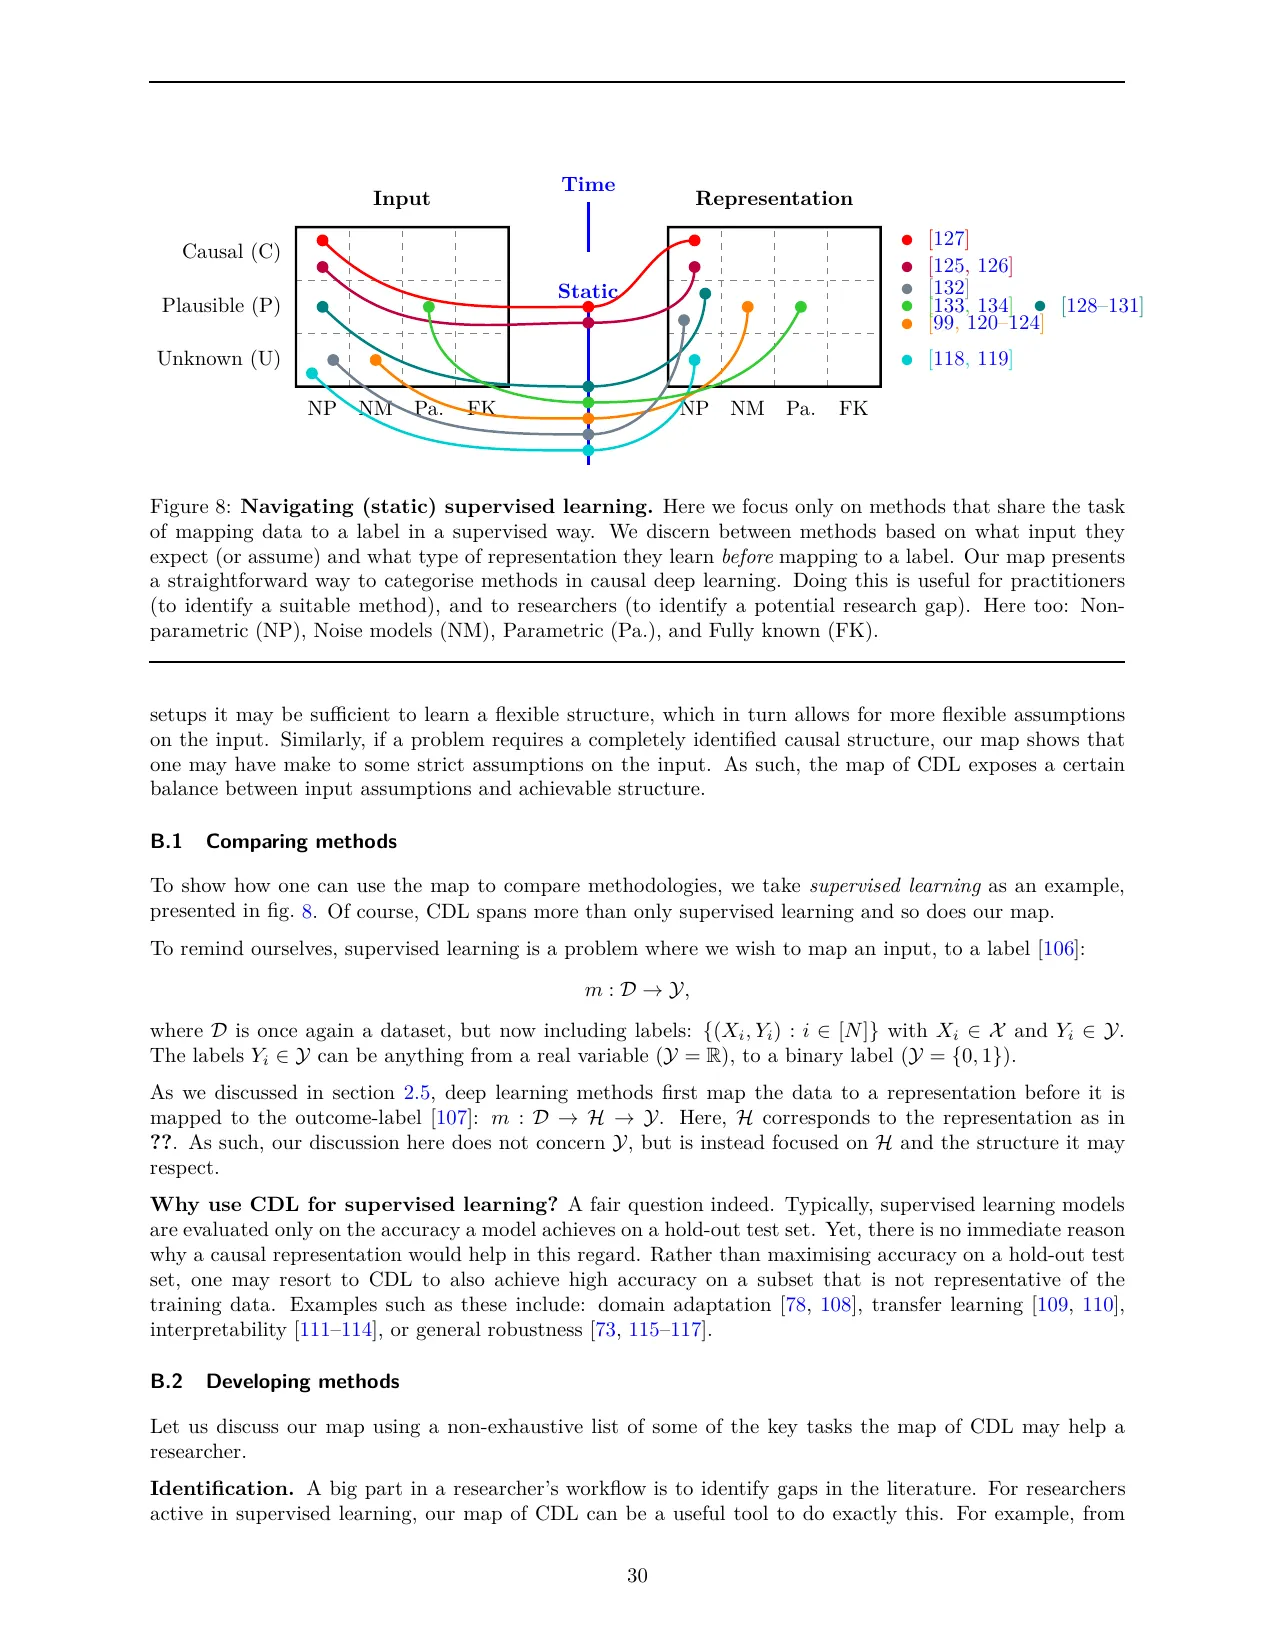
关键洞察:
- 监督学习中没有方法实现从未知到因果的结构转换
- 大量工作集中在从噪声模型学习到噪声模型(同质竞争)
- 完全已知(FK)参数假设在监督学习中完全缺失
5.4 预测与时序监督学习
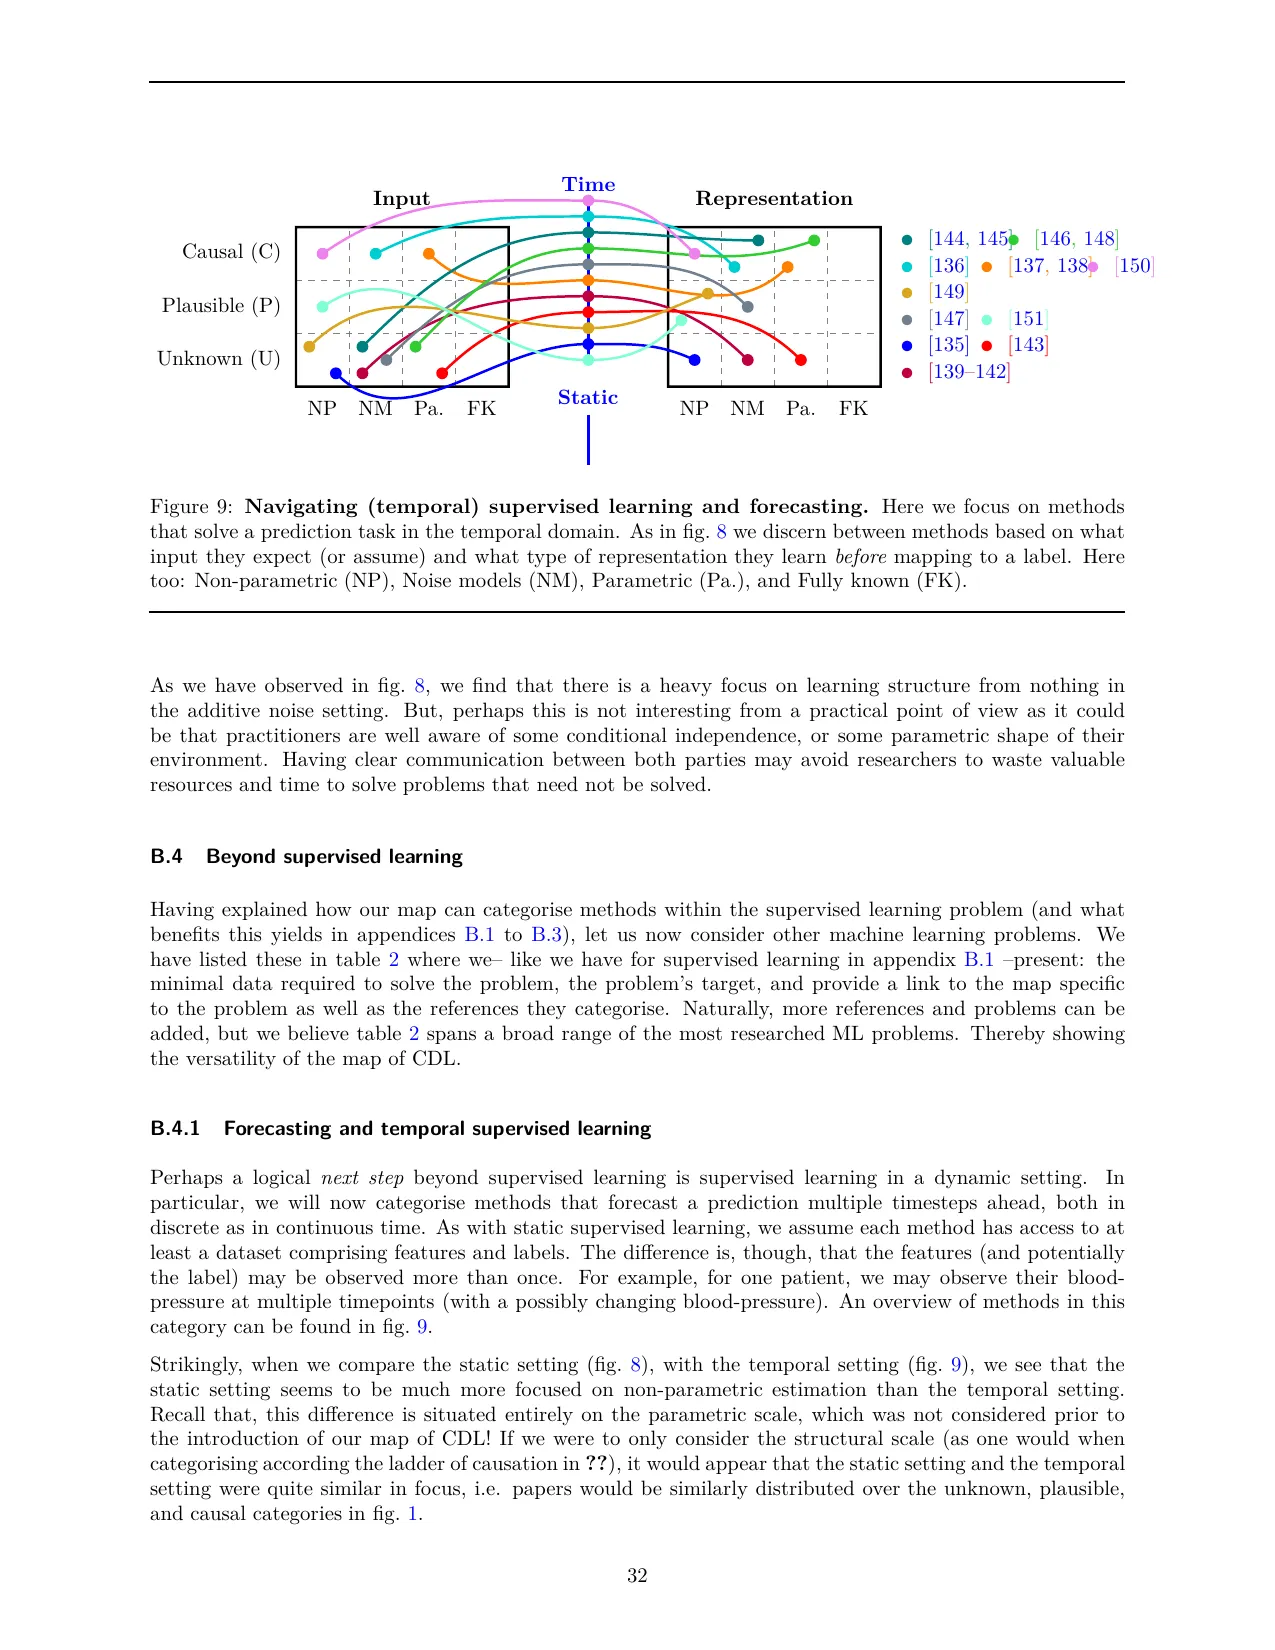
与静态设置的对比:
- 静态设置更关注非参数估计
- 时序设置更关注参数化方法
- 这一差异在引入参数尺度后才变得清晰
5.5 强化学习与Bandit
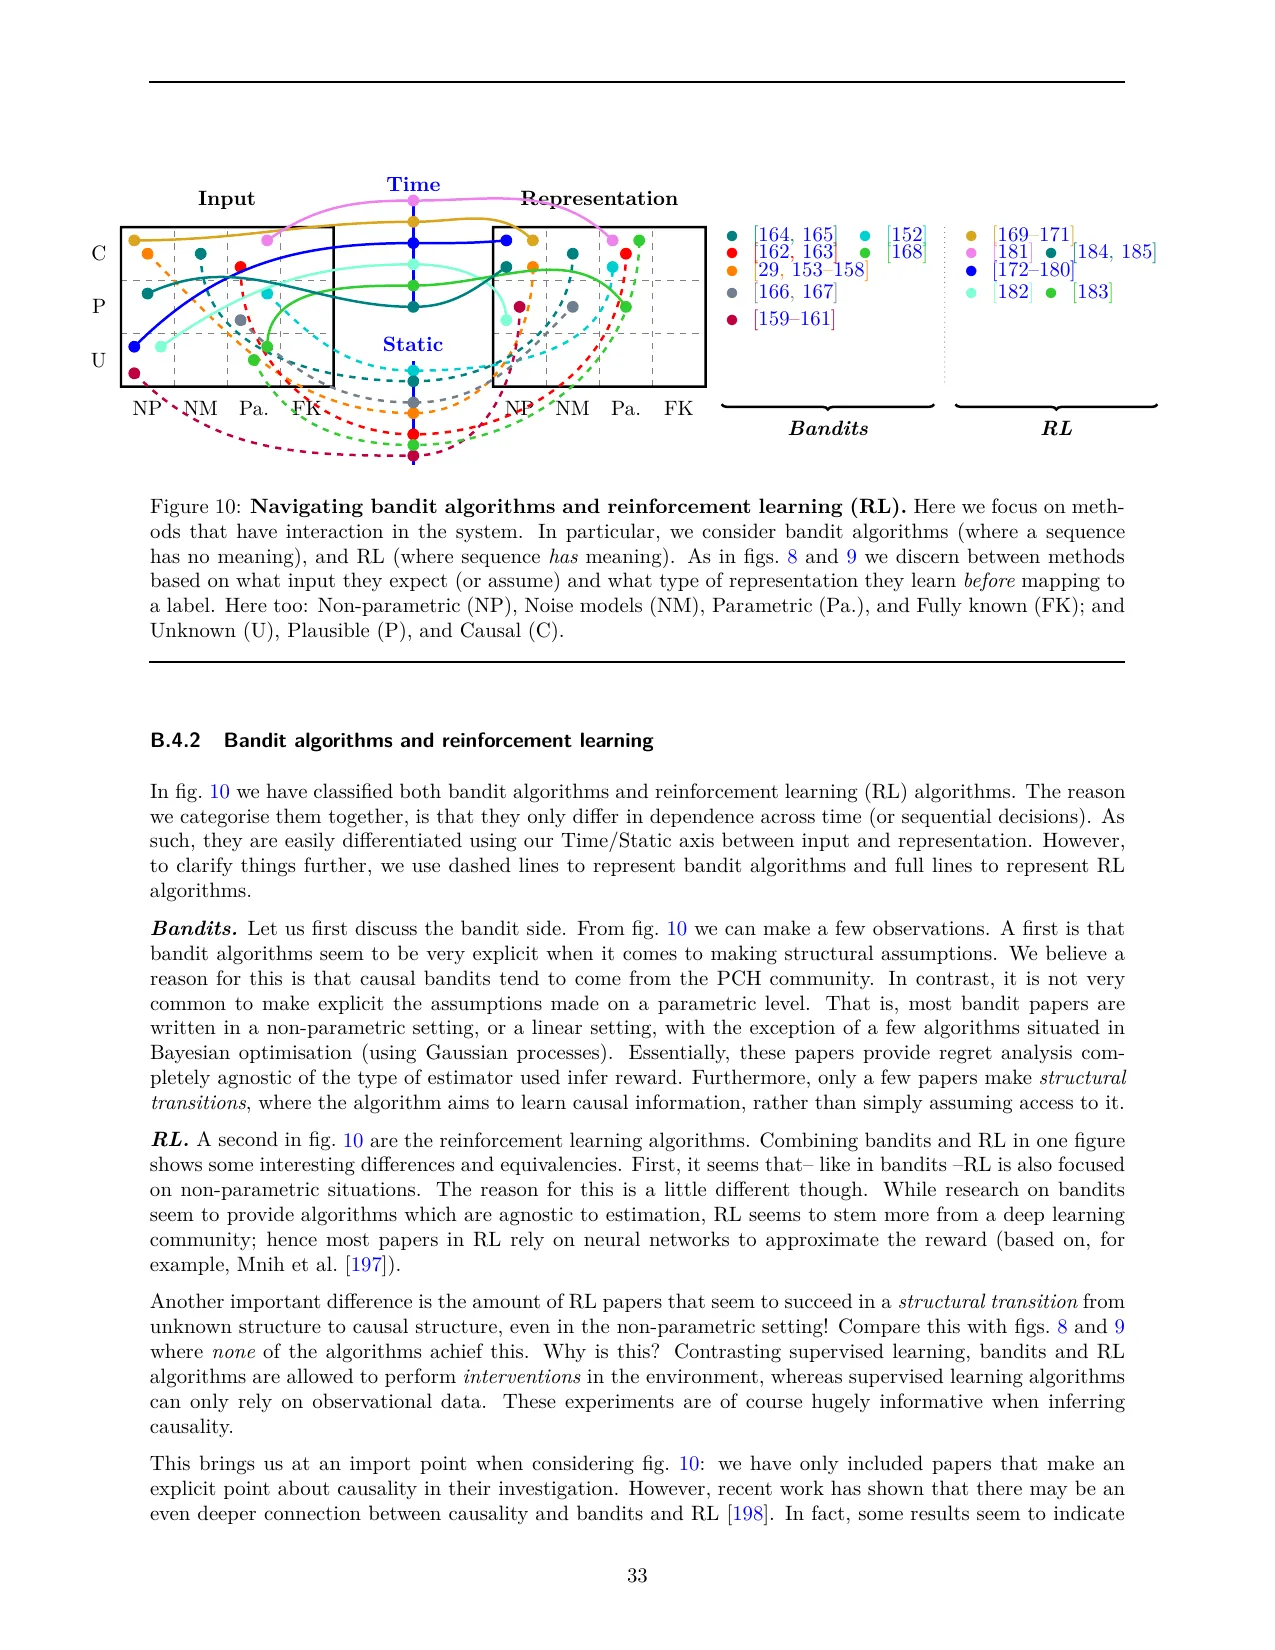
关键发现:
- Bandit算法在结构假设上非常明确(来自PCH社区)
- RL论文大量成功实现从未知到因果的结构转换——因为允许干预
- 监督学习无法做到这一点(只有观测数据)
5.6 生成建模
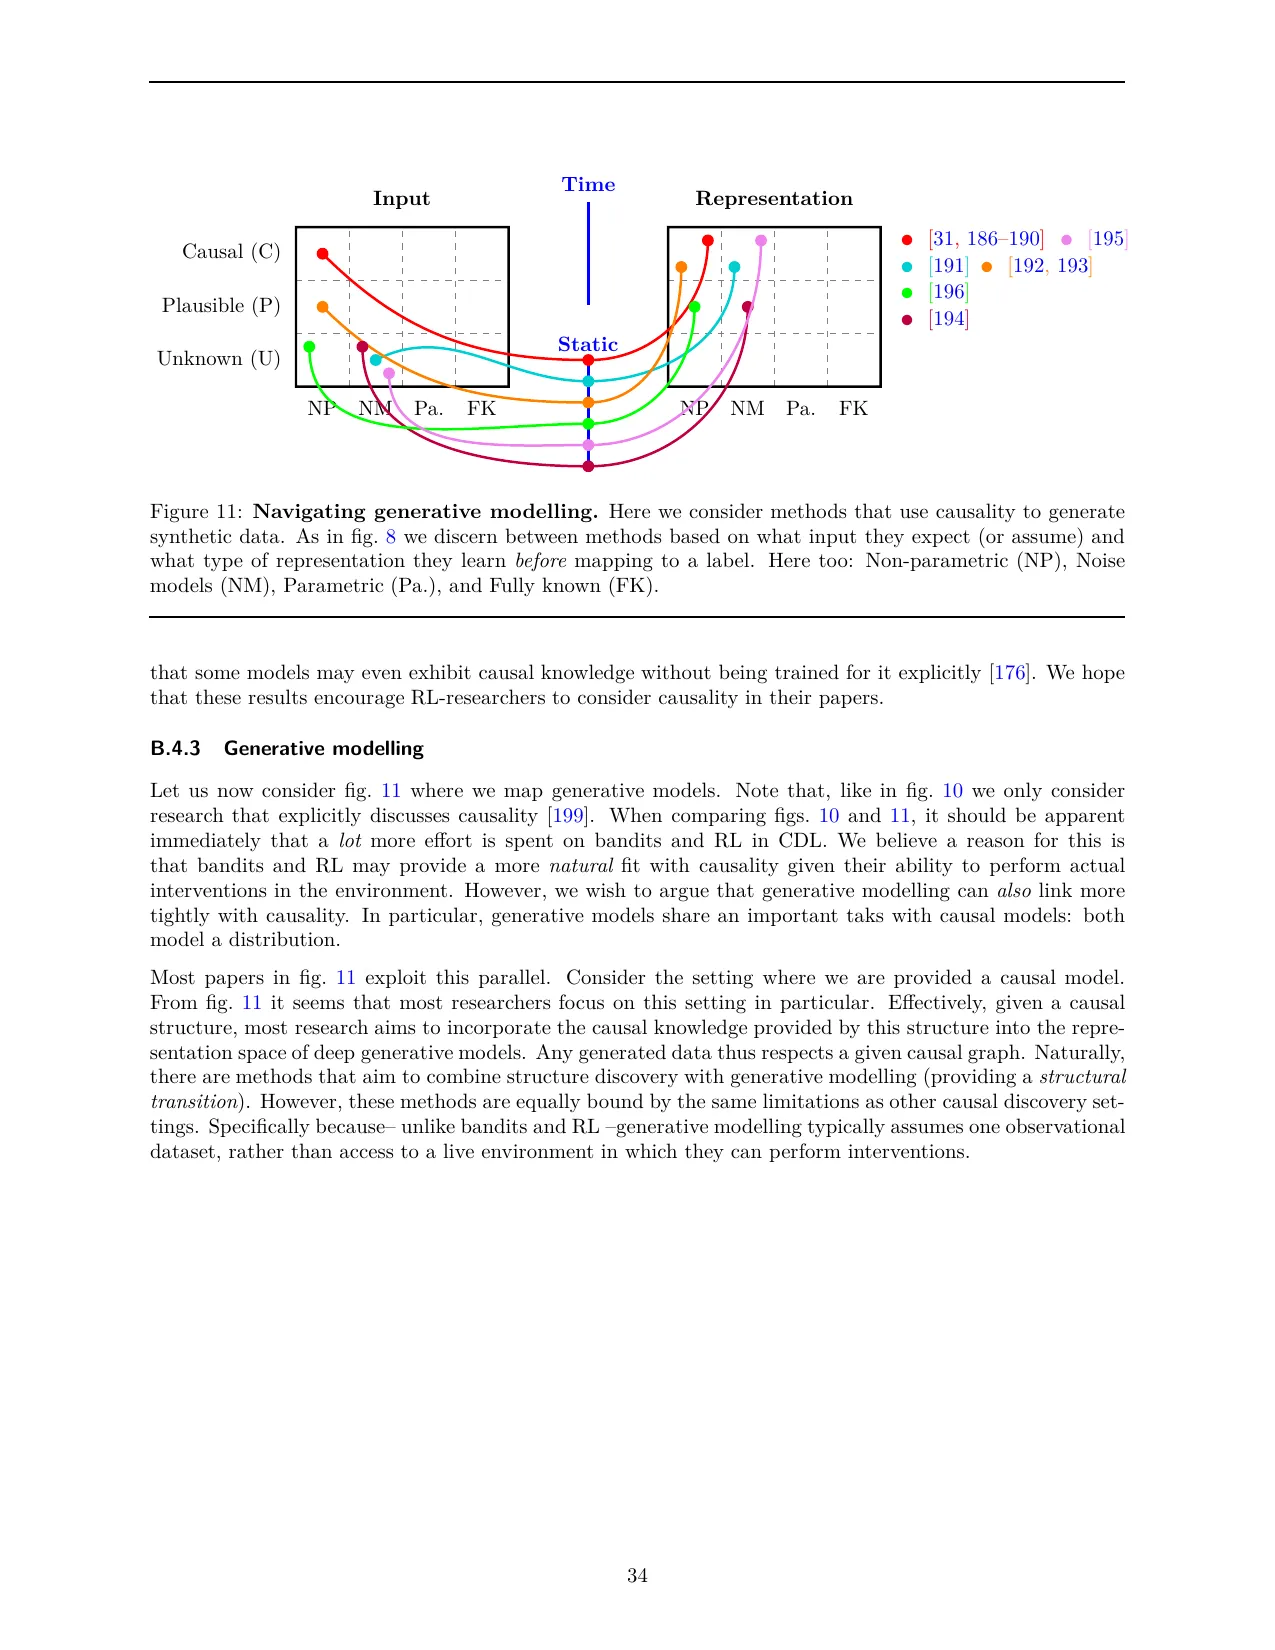
- 大多数工作利用已知因果结构指导生成模型
- 少数方法结合结构发现与生成建模
- 受限于仅有一次观测数据集,无法像RL那样进行干预
5.7 领域目标与方向
最难但最理想的目标: 从任意数据学习因果结构(无假设)
                              ▲
                             /|\
                            / | \
                           /  |  \
              已知因果结构 ← 噪声模型 ← 非参数
六、与相关工作的比较
| 维度 | CDL框架 | Pearl的因果阶梯 | 传统因果推断 | 传统深度学习 |
|---|---|---|---|---|
| 知识粒度 | 结构×参数×时间 | 仅结构(3级) | 仅结构 | 无结构意识 |
| 似因果层级 | ✅ 明确区分 | ❌ 未涵盖 | ❌ 未涵盖 | N/A |
| 参数假设 | ✅ 四级分类 | ❌ 不考虑 | 部分考虑 | 通常非参数 |
| 模型组合 | ✅ 流水线指南 | ❌ 无 | ❌ 无 | ❌ 无 |
| 实用性 | ✅ 面向从业者 | 偏理论 | 偏理论 | 偏工程 |
七、CDL论文指南
论文提出三条实用指南:
-
明确因果假设:利用已有因果知识,同时谨慎对待知识缺失;避免使用要求完全因果知识但只给出部分确认结构的方法
-
避免模型误设:通过仔细文档化和分析参数设置。非参数模型是有力盟友,但当已有某些参数知识时,不必要的复杂化会降低推断效力
-
时间需要特别关注:时间不仅是历史记录的简单添加;因果设定中时间带来新的混杂复杂性
八、总结
核心贡献
- 提出CDL三维框架:结构尺度(未知→似因果→因果)、参数尺度(非参数→噪声模型→参数化→完全已知)、时间尺度(静态→时序)
- 引入”似因果”层级:填补Pearl因果阶梯中 rung 1 和 rung 2 之间的空白
- 参数尺度系统分类:首次将深度学习的参数假设纳入因果分析框架
- 知识转换理论:定义模型输入/输出知识的差异,指导模型组合
- 模型流水线设计方法:级联模型需假设匹配,避免有害偏差
- 全面实证地图:对监督学习、预测、RL/Bandit、生成建模进行系统分类
- 四条实用指南:明确假设、避免误设、关注时间、谨慎组合
技术影响
- 为因果深度学习领域提供了统一的分类和组织框架
- 帮助研究者识别研究空白(如FK参数假设的监督学习缺失)
- 帮助实践者选择合适的因果深度学习方法
- 弥合因果推理与深度学习之间的理论与实践鸿沟
局限性
- 框架为分类和指导性,不提供具体算法
- 参数尺度的某些层级(如FK)在实际中难以达到
- “似因果”层级的具体边界在某些场景下可能有争议
- 框架本身需要更多实证验证其指导价值
九、参考资源
- 论文:https://arxiv.org/abs/2303.02186
- DOI:https://doi.org/10.48550/arXiv.2303.02186
- 许可证:CC BY 4.0
- 相关框架:Pearl的因果阶梯(Ladder of Causation)、结构因果模型(SCM)、Do-Calculus
- 关键参考:
- [1] Pearl & Mackenzie, “The Book of Why”
- [5] Koller & Friedman, “Probabilistic Graphical Models”
- [9] Pearl, “Causality”
- [10] Bareinboim et al., “On Pearl’s Hierarchy”