survey transformer inference-optimization hardware-accelerator neural-architecture-search quantization pruning kernel-optimization
Full Stack Optimization of Transformer Inference: a Survey
Transformer 推理全栈优化综述,涵盖硬件设计、软件优化、调度策略和神经架构搜索
Full Stack Optimization of Transformer Inference: a Survey
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Full Stack Optimization of Transformer Inference: a Survey |
| 作者 | Sehoon Kim, Coleman Hooper, Thanakul Wattanawong, Minwoo Kang, Ruohan Yan, Hasan Genc, Grace Dinh, Qijing Huang, Kurt Keutzer, Michael W. Mahoney, Yakun Sophia Shao, Amir Gholami |
| 机构 | UC Berkeley, NVIDIA, ICSI, LBNL |
| 论文 | arXiv:2302.14017 |
| 发布 | 2023-02-27 |
| 会议 | Workshop on Architecture and System Support for Transformer Models (ASSYST) at ISCA 2023 |
二、核心思想
本文是一篇全面的综述,系统性地分析了 Transformer 推理的全栈优化方法。作者从硬件加速器设计、软件优化策略、算子调度、以及神经架构搜索(NAS)等多个维度,对 Transformer 推理的瓶颈和优化机会进行了深入分析。
问题定义
Transformer 模型在 NLP、CV、语音识别等领域取得了优异性能,但其推理所需的计算量和内存带宽持续增长,使得在延迟敏感的应用中部署变得困难。与 CNN 相比,Transformer 的工作负载特性有显著不同:
- 矩阵乘法为主: 超过 99% 的 FLOPs 来自矩阵乘法
- 非线性操作开销: Softmax、LayerNorm 虽然 FLOPs 占比小,但内存访问量大
- 解码器内存瓶颈: 自回归解码的矩阵-向量运算算术强度极低
解决方案概述
本文提出全栈协同设计(full-stack co-design)方法,涵盖五个层面:
- 工作负载分析: 分析 Transformer 在商用硬件上的运行特性
- 硬件架构设计: 设计适合 Transformer 的专用加速器
- 模型优化: 剪枝、量化等固定架构优化
- 算子映射与调度: 解决矩阵乘法在加速器上的映射挑战
- 神经架构搜索: 自动搜索硬件高效的 Transformer 架构
三、技术架构
Transformer 基础架构
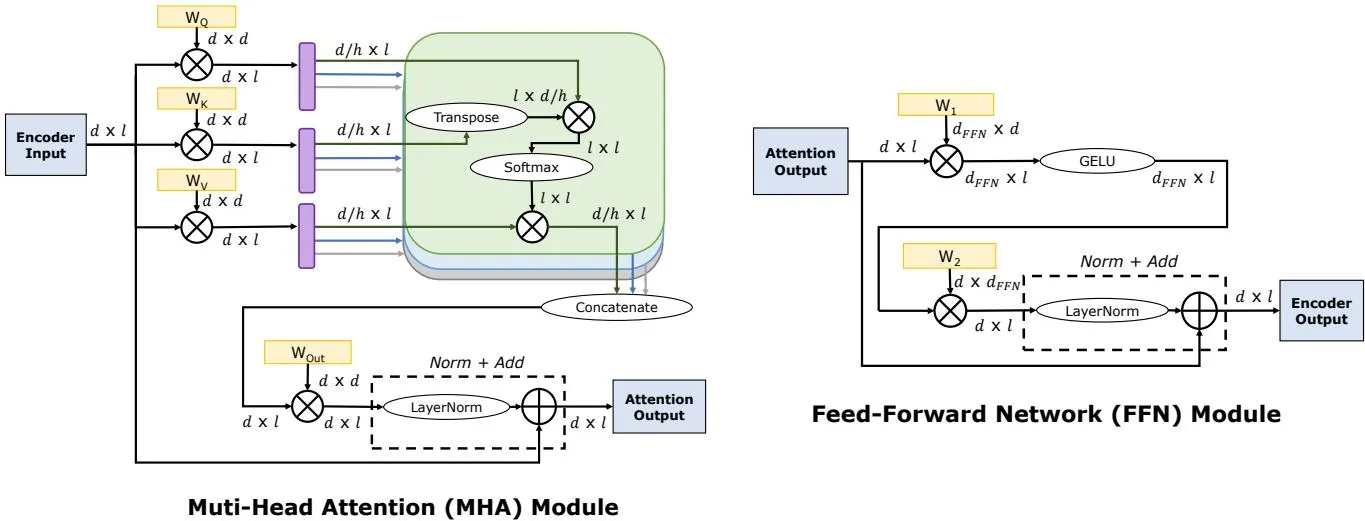
Transformer 块包含两个核心模块:
多头注意力 (MHA) 模块:
- 6 个线性操作:4 个投影层(W_Q, W_K, W_V, W_out)+ 2 个激活到激活的矩阵乘法(query×key, attn_score×value)
- 1 个 Softmax 操作
- 1 个 LayerNorm 操作
前馈网络 (FFN) 模块:
- 2 个线性操作:W_1 投影(d → d_FFN)和 W_2 投影(d_FFN → d)
- 1 个 GELU 非线性操作
- 1 个 LayerNorm 操作
非线性操作特性
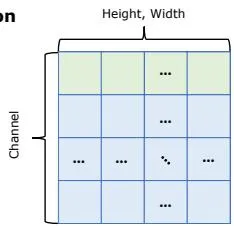
| 操作 | 遍数 | 特点 |
|---|---|---|
| Softmax | 3 遍 | 需计算指数、求和、归一化 |
| LayerNorm | 3 遍 | 需计算均值、标准差、归一化 |
| BatchNorm | 1 遍 | 统计量在训练时学习,可融合到卷积 |
Transformer 变体
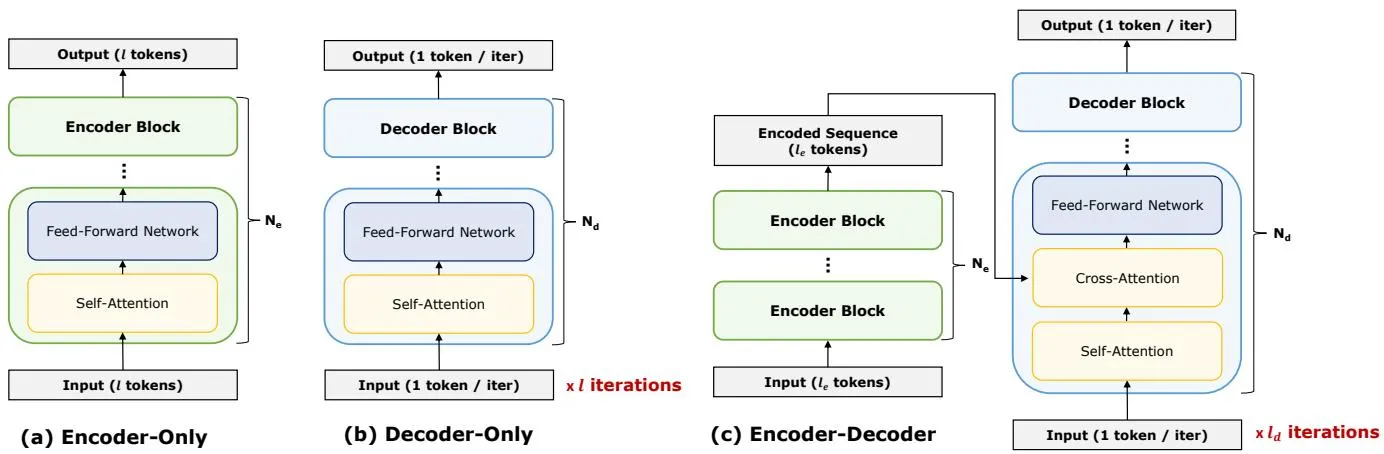
- 编码器-only: 并行处理所有 token,适合 NLU 任务
- 解码器-only: 自回归生成,适合生成任务
- 编码器-解码器: 结合两者,适合序列到序列任务
核心公式
算术强度:
MHA 矩阵乘法维度:
- W_Q/W_K/W_V 投影:
- query × key:
- attn_score × value:
FFN 矩阵乘法维度:
- W_1 投影:
- W_2 投影:
关键配置参数
| 参数 | 符号 | BERT-Base | BERT-Large | GPT-2 |
|---|---|---|---|---|
| 层数 | N | 12 | 24 | 12 |
| 模型维度 | d | 768 | 1024 | 768 |
| 注意力头数 | h | 12 | 16 | 12 |
| FFN 维度 | d_FFN | 3072 | 4096 | 3072 |
四、核心创新
工作负载分析
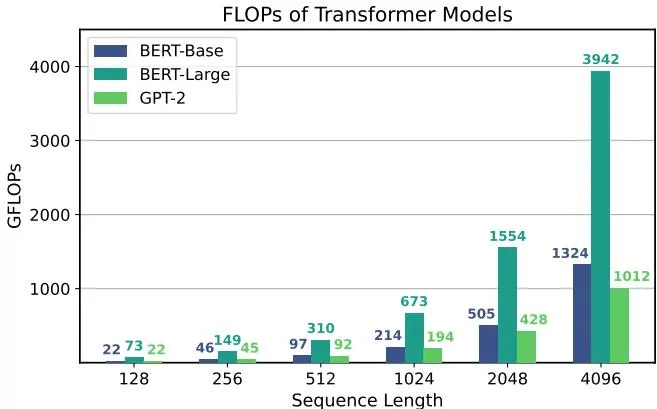
关键发现:
- FLOPs 随序列长度二次方缩放(由于 act-to-act 矩阵乘法)
- 短序列时 FFN 主导计算,长序列时 MHA 的 act-to-act 矩阵乘法主导
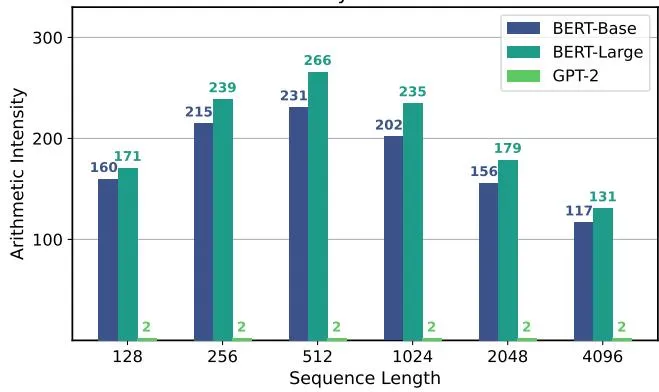
算术强度特性:
- 编码器:算术强度随序列长度先升后降
- 解码器:算术强度显著低于编码器(矩阵-向量运算)
- 解码器推理是内存带宽受限问题,而非计算受限
硬件加速器设计
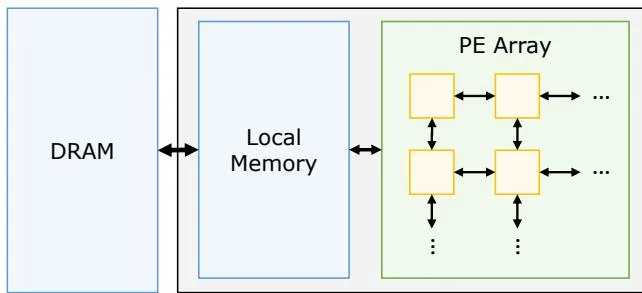
DNN 加速器基本组成:
- 片外 DRAM: 存储完整网络的权重和激活
- 全局缓冲区: 存储权重和输入的子集
- PE 阵列: 执行 MAC 操作
- 片上网络 (NoC): PE 间数据传输
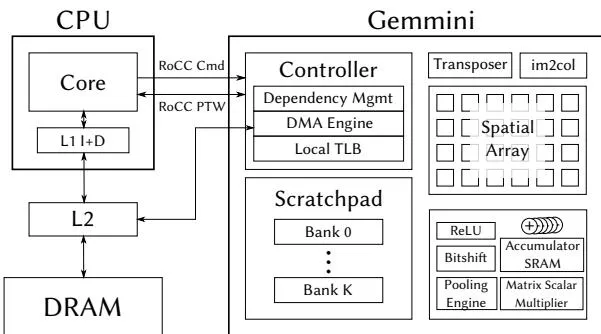
关键发现:
- 原始 Gemmini 为 CNN 设计,不适合 Transformer
- 非线性操作(Softmax、LayerNorm、GELU)是主要瓶颈
- 增加累加器大小可提升 36% 延迟性能
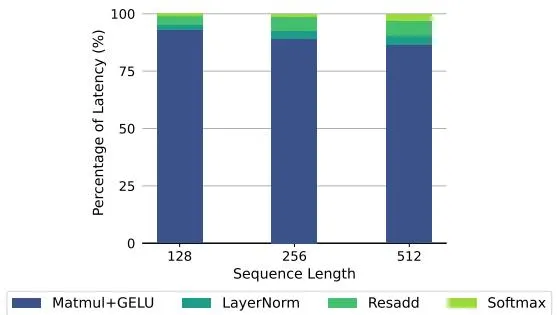
优化结果:
- 添加专用归一化单元后,矩阵乘法主导所有序列长度的执行时间
- I-BERT 量化优化消除量化/反量化操作
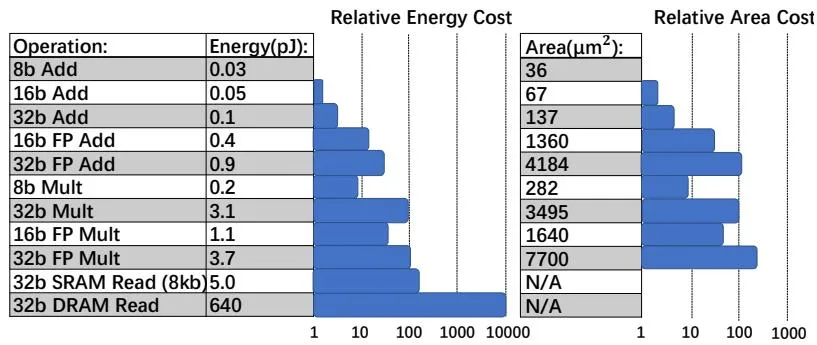
低精度优势:
- 低精度提供指数级更好的能效
- 45nm 技术下,精度每降低一半,能耗降低约 4 倍
算子映射与调度
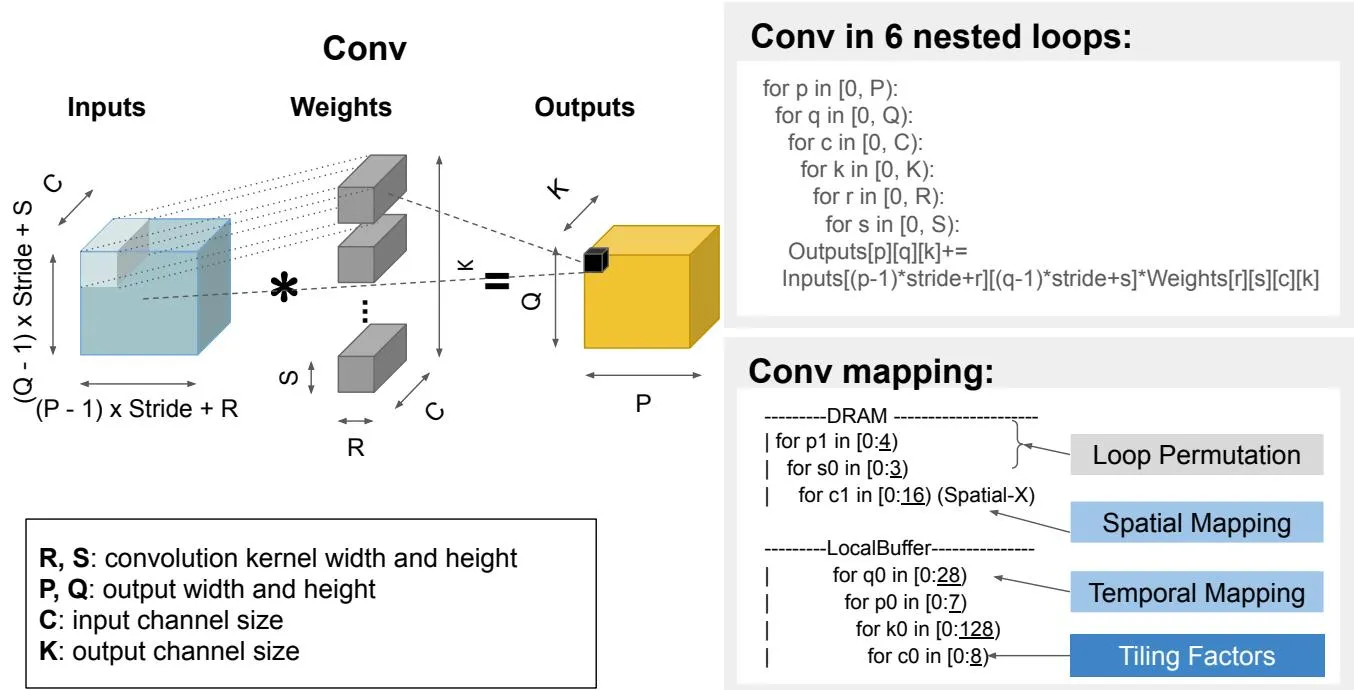
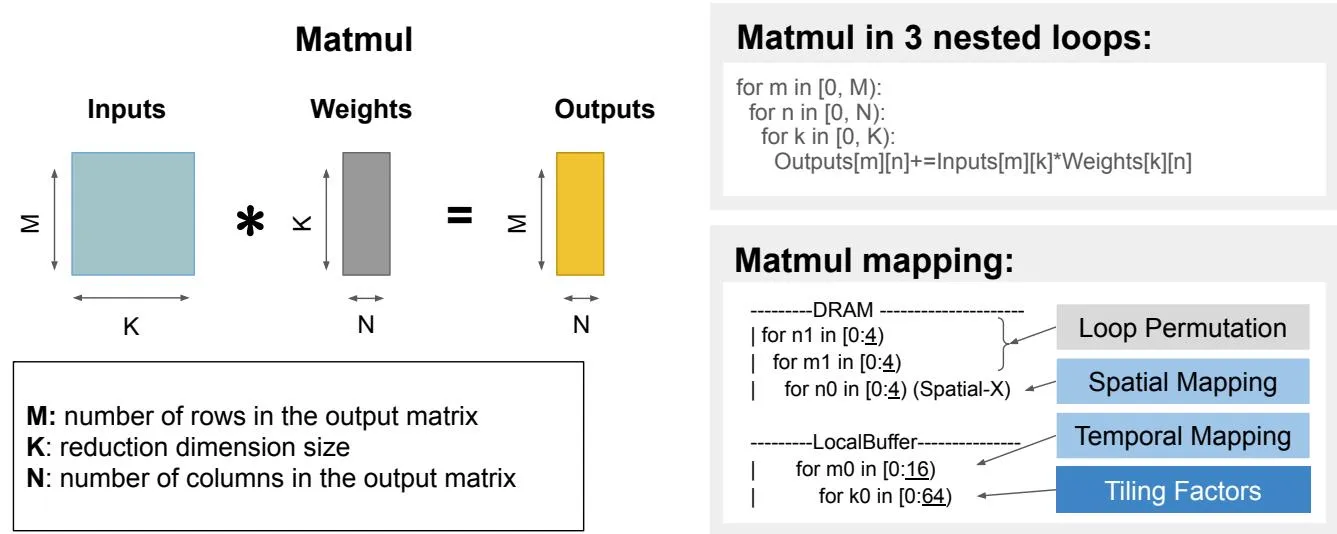
映射挑战:
- CNN 卷积:6 层循环
- Transformer 矩阵乘法:3 层循环
- 但两者具有相似的调度复杂性
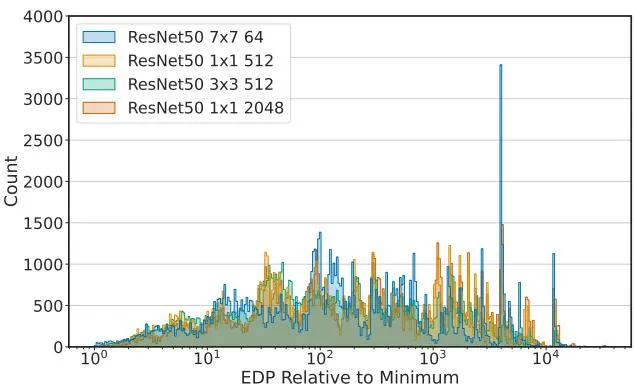
关键发现:
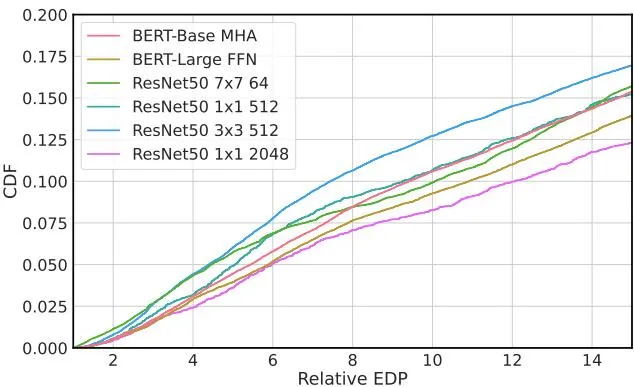
- BERT 矩阵乘法和 ResNet50 卷积的 mapspace 分布相似
- 最优和最差映射之间有 4 个数量级的 EDP 差异
- 暴力搜索或随机搜索同样困难
融合调度权衡
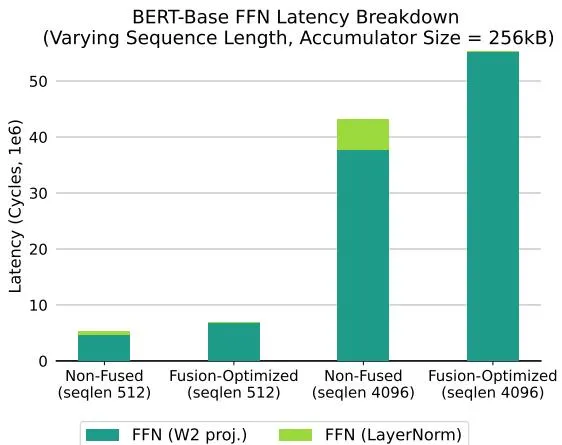
融合优化结果:
- 融合 query×key 与 Softmax 可降低延迟 78%
- 但 W_out 投影与 LayerNorm 融合可能有害
FFN 融合问题:
- FFN W_1 投影与 LayerNorm 融合反而增加 27% 延迟
- 原因:映射约束的开销超过延迟隐藏的收益
神经架构搜索 (NAS)
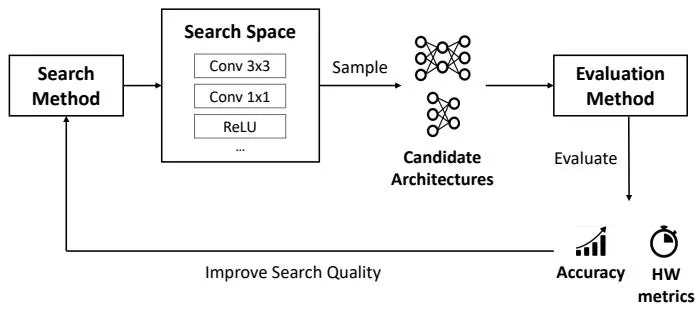
NAS 三要素:
- 搜索空间: 定义有效的候选架构
- 搜索方法: 高效探索搜索空间
- 评估方法: 评估候选架构性能
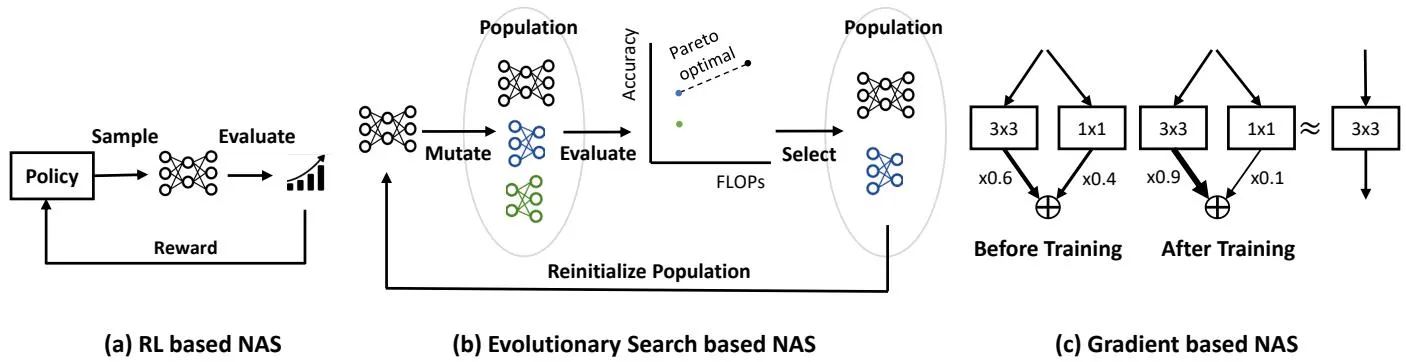
| 方法 | 特点 | 计算成本 |
|---|---|---|
| RL-based | 控制器采样架构,评估结果作为奖励 | 高 |
| Evolutionary | 种群初始化、变异、选择 | 高 |
| Gradient-based | 连续松弛,梯度优化 | 低 |
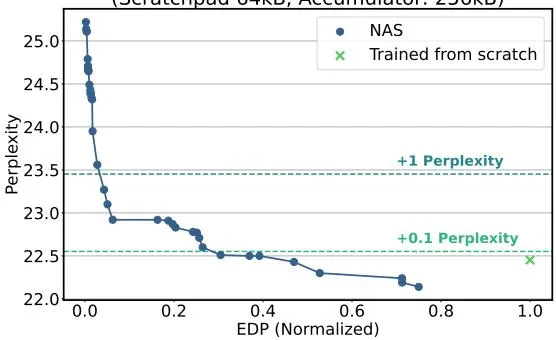
NAS 搜索结果:
- 0.1 困惑度损失:2.2× EDP 降低
- 1 困惑度损失:10.6× EDP 降低
- 可发现具有不同层数、头数、维度的 Pareto 最优架构
五、代码实现分析
本论文为综述性质,不包含具体代码实现。但作者在 Gemmini 加速器上进行了案例研究,验证了所提出方法的有效性。
Gemmini 优化要点:
- 添加专用归一化单元支持 Softmax 和 LayerNorm
- 使用 I-BERT 的多项式近似进行片上非线性操作
- 调整累加器/暂存器大小比例(256kB 累加器,64kB 暂存器)
六、实验结果
工作负载特性
| 指标 | BERT-Base (l=512) | GPT-2 (l=512) |
|---|---|---|
| FLOPs | 97.02 × 10^9 | ~22 × 10^9 |
| MOPs | 0.42 × 10^9 | ~0.14 × 10^9 |
| 算术强度 | 231.0 | ~2.0 |
| 主要瓶颈 | 计算受限 | 内存带宽受限 |
硬件优化结果
| 优化技术 | 延迟改进 |
|---|---|
| 基线 CNN 加速器 | 1× (参考) |
| 添加归一化单元 + I-BERT | 39.6× |
| 调整累加器/暂存器比例 | 额外 36% |
| 总改进 | 88.7× |
NAS 搜索结果
| 困惑度损失 | 延迟降低 | 能耗降低 | EDP 降低 |
|---|---|---|---|
| 0.1 点 | 1.4× | 1.6× | 2.2× |
| 1.0 点 | 2.4× | 4.4× | 10.6× |
算子调度分析
| 算子类型 | 循环层数 | Mapspace 大小 | 近优映射比例 |
|---|---|---|---|
| CNN 卷积 (3×3) | 6 | 10^9+ | ~10% |
| Transformer 矩阵乘法 | 3 | 10^9+ | ~10% |
七、相关工作
本综述涵盖了广泛的 Transformer 优化相关工作:
硬件加速器:
- 专用 NPU(Google TPU, Intel Nervana)
- 通用 GPU 优化(NVIDIA TensorRT)
- 学术加速器(Eyeriss, Shidiannao)
模型优化:
- 量化:INT8、FP16、混合精度
- 剪枝:非结构化、结构化
- 知识蒸馏:大模型到小模型
NAS 方法:
- RL-based:NASNet, ENAS
- Evolutionary:AmoebaNet, Evolved Transformer
- Gradient-based:DARTS, FBNet
- Transformer-specific:HAT, NAS-BERT, Primer
八、总结
核心贡献
- 全面分析: 系统性分析 Transformer 推理的工作负载特性
- 全栈视角: 涵盖硬件、软件、调度、架构搜索多个层面
- 案例研究: 在 Gemmini 加速器上验证优化方法
- 关键发现: 揭示 Transformer 与 CNN 推理的本质差异
技术影响
- 硬件设计指导: 为 Transformer 专用加速器设计提供原则
- 优化策略选择: 帮助在不同场景选择合适的优化方法
- NAS 应用: 展示 NAS 在 Transformer 优化中的潜力
- 全栈协同: 强调软硬件协同设计的重要性
局限性
- 时间限制: 综述基于 2023 年的工作,可能不包含最新进展
- 硬件特定: 案例研究基于 Gemmini,结果可能不适用于其他平台
- 任务特定: 实验主要在语言建模任务上进行
- 模型特定: 主要分析 BERT 和 GPT-2 架构
九、参考资源
- 论文链接: arXiv:2302.14017
- PDF 下载: arXiv PDF
- Gemmini 加速器: GitHub
- 相关工作:
- I-BERT: INT8 量化(参考 Fig. 14)
- Once-for-All: NAS 权重共享(参考 Sec. 6.1.3)
- Timeloop: 加速器性能建模(参考 Sec. 6.4.1)