DiT: 基于 Transformer 的可扩展扩散模型
DiT 用在 latent patch 上操作的 Transformer 替换扩散模型常用的 U-Net 骨干,提出 adaLN-Zero 条件注入块,证明 Gflops(通过增大深度/宽度或 token 数)与 FID 强负相关;DiT-XL/2 在 ImageNet 256×256 取得 SOTA FID 2.27,是 Sora/SD3/FLUX 等现代生成模型的架构基石。
Scalable Diffusion Models with Transformers (DiT)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Scalable Diffusion Models with Transformers |
| 作者 | William Peebles, Saining Xie |
| 机构 | UC Berkeley / New York University |
| 论文 | https://arxiv.org/abs/2212.09748 |
| 发布 | 2022-12-19(ICCV 2023,Oral) |
| 分类 | cs.CV |
| 代码 | https://github.com/facebookresearch/DiT |
摘要
本文探索一类基于 Transformer 架构的扩散模型。训练图像的隐扩散模型(latent diffusion),用在 latent patch 上操作的 Transformer 替换常用的 U-Net 骨干。通过前向计算复杂度(以 Gflops 衡量)的视角分析 Diffusion Transformers (DiTs) 的可扩展性,发现更高 Gflops 的 DiT——无论是增大 Transformer 深度/宽度还是增加输入 token 数——都持续获得更低 FID。除良好的可扩展性外,最大的 DiT-XL/2 模型在类条件 ImageNet 512×512 与 256×256 基准上超越所有先前扩散模型,在后者达到 SOTA FID 2.27。
历史意义:DiT 是现代视觉生成的架构基石——Sora、Stable Diffusion 3、PixArt-α、FLUX、Wan 等均以 DiT 为骨干。本文前述分析的 PPFlow (2506.23543)、DDiT (2602.16968) 等 patch 效率优化工作,其”patchify → DiT blocks → unpatchify”范式与 adaLN 条件注入均源自本文。
二、核心思想
问题定义
扩散模型此前普遍采用 U-Net 卷积骨干(如 ADM、LDM),这带有卷积网络的归纳偏置。而 Transformer 在语言、视觉识别等领域展现出卓越的可扩展性(更多计算/数据/参数 → 更好性能)。核心问题:架构选择对扩散模型的性能与可扩展性有多重要?U-Net 的归纳偏置是否必要?
解决方案概述
DiT 尽可能忠实于标准 Transformer(ViT)架构以保留其可扩展性,直接在预训练 VAE 的 latent 空间上操作:
- Patchify:将噪声 latent 切分为 patch 序列 + 位置嵌入
- DiT blocks:一系列 Transformer 块处理 token(含条件信息 t、c)
- 线性解码器:解码为噪声预测与协方差预测
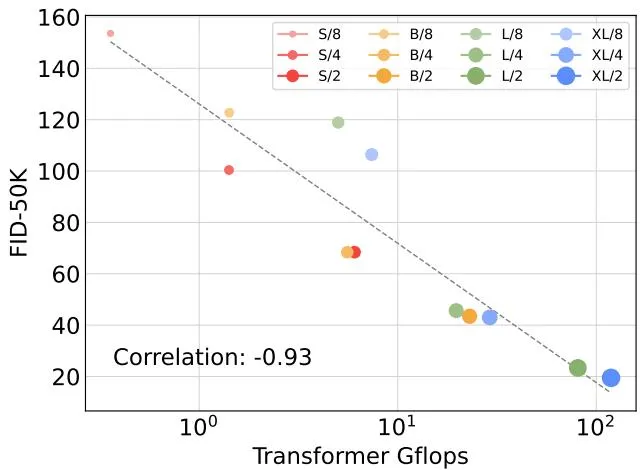
关键发现:Gflops(而非参数量)是决定 DiT 质量的关键因素——在固定参数量下仅减小 patch size(增加 token)也能显著改善 FID。
三、技术架构
整体框架
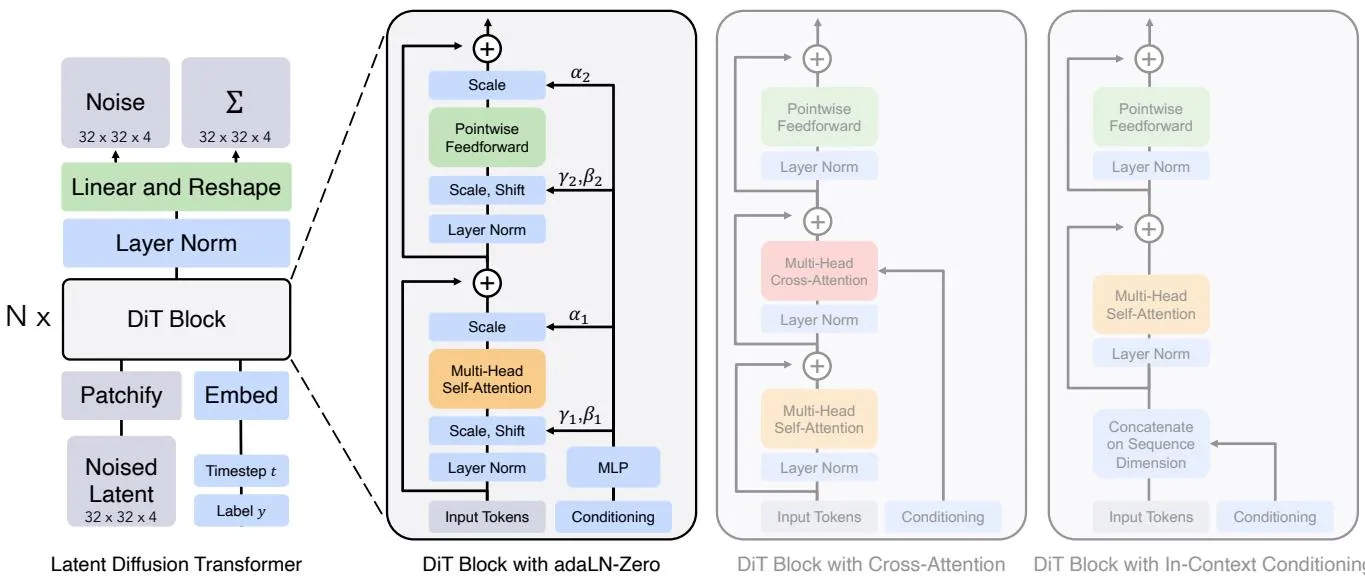
Latent Diffusion 两阶段:(1) 用冻结的 VAE 编码器压缩图像 (256×256×3 图像 → 32×32×4 latent,下采样因子 8);(2) 在 latent 空间训练扩散模型,采样后用解码器 还原。相比像素空间扩散(如 ADM 1120 Gflops),LDM 只用一小部分算力。
3.1 扩散公式(预备知识)
前向加噪:,重参数化 ,。
反向过程:,用神经网络预测统计量。
简化损失(噪声预测):
遵循 Nichol & Dhariwal:用 训练 ,用完整 项训练可学习协方差 。
Classifier-free guidance(分类器无关引导): 其中 为引导强度( 恢复标准采样),训练时随机丢弃 替换为可学习的 “null” 嵌入 。
3.2 Patchify(输入规格)
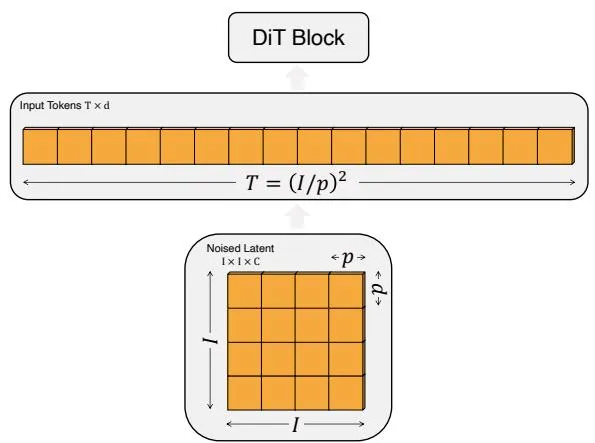
输入 latent 形状 (256×256 图像对应 32×32×4)。第一层 “patchify” 将空间输入转为 个 token,每个 维,通过线性嵌入每个 patch。随后加标准 ViT 正弦-余弦位置嵌入。
关键关系:token 数 。patch size 减半 → 变 4 倍 → 至少 4 倍 Transformer Gflops,但对参数量几乎无影响。设计空间加入 。
3.3 DiT Block 设计(条件注入的四种变体)
扩散模型需处理额外条件(噪声时间步 、类标签 )。本文探索四种 Transformer 块变体:
| 块设计 | 机制 | Gflops 开销 | 效果 |
|---|---|---|---|
| In-context | 将 嵌入作为额外 token 附加到序列(类似 cls token) | 可忽略 | 最差 |
| Cross-attention | 在自注意力后加多头交叉注意力层, 作为长度 2 的序列 | ~15% 开销(最高) | 中等 |
| adaLN | 用自适应层归一化替换标准 LayerNorm,从 嵌入和回归缩放/偏移 | 最低 | 较好 |
| adaLN-Zero ⭐ | 在 adaLN 基础上额外回归维度缩放 (残差连接前应用),零初始化使每个块初始为恒等函数 | 最低 | 最佳 |
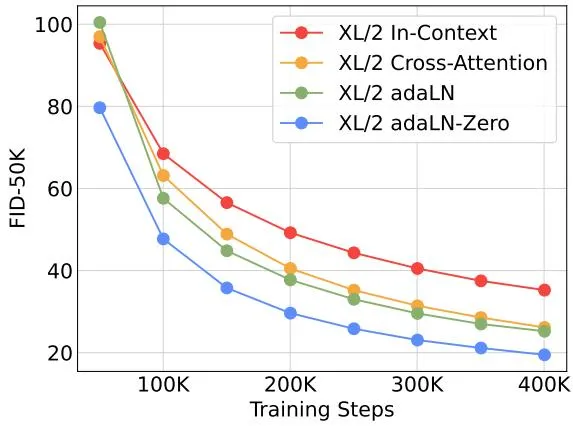
adaLN-Zero 关键设计:借鉴 ResNet 零初始化最终 BatchNorm 缩放因子加速训练的经验——将回归 的 MLP 初始化为输出零向量,使整个 DiT block 初始化为恒等映射。实验证明其 FID 在 400K 步时几乎是 in-context 的一半。此后全部模型采用 adaLN-Zero。
3.4 Transformer 解码器
最终块后,用标准线性解码器:应用最终层归一化(adaLN 则自适应),将每个 token 线性解码为 张量( 对应噪声预测 + 对角协方差预测),再重排回原空间布局。
3.5 模型配置
遵循 ViT 联合缩放 (层数)、(隐藏维)、注意力头数:
| 模型 | 层数 N | 隐藏维 d | 头数 | Gflops (I=32, p=4) |
|---|---|---|---|---|
| DiT-S | 12 | 384 | 6 | 1.4 |
| DiT-B | 12 | 768 | 12 | 5.6 |
| DiT-L | 24 | 1024 | 16 | 19.7 |
| DiT-XL | 28 | 1152 | 16 | 29.1 |
命名规则:DiT-XL/2 = XLarge 配置 + patch size 。整体 Gflops 范围 0.3–118.6。
设计空间 = patch size × block 架构 × 模型规模。
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 纯 Transformer 扩散骨干 | 用 ViT 式 Transformer 替代 U-Net,无卷积归纳偏置 | 超越所有先前扩散模型 |
| adaLN-Zero 条件注入 | 零初始化使块初始为恒等,计算最省且效果最佳 | 图 5,FID 减半 |
| Gflops-FID 强负相关 | 揭示模型计算量(非参数量)是质量关键 | 图 8 |
| 可扩展性验证 | 增深/宽或增 token 数持续降低 FID | 图 6/7/9 |
| 计算效率优势 | 118.6 Gflops vs ADM 1120 Gflops,效率高一个量级 | 表 2 |
五、实验结果
5.1 实验设置
- 数据:ImageNet 类条件生成(256×256 与 512×512)
- VAE:Stable Diffusion 预训练 VAE(下采样因子 8)
- 训练:AdamW,恒定 lr ,无 weight decay,batch 256,仅水平翻转增强,EMA decay 0.9999。无需 lr warmup 或正则化,训练极其稳定无 loss spike
- 扩散超参:沿用 ADM( 线性方差 schedule 到 )
- 评测:FID-50K(250 DDPM 步),辅以 IS、sFID、Precision/Recall;用 ADM 的 TF 评估套件
- 实现:JAX + TPU-v3 pods;DiT-XL/2 在 TPU v3-256 上约 5.7 iter/s
5.2 Block 设计消融
训练四个 DiT-XL/2(不同 block):in-context (119.4 Gflops)、cross-attention (137.6)、adaLN (118.6)、adaLN-Zero (118.6)。adaLN-Zero FID 最低且计算最省——400K 步时 FID 近乎 in-context 的一半,且显著优于 vanilla adaLN,证明条件机制与初始化都至关重要。
5.3 规模缩放
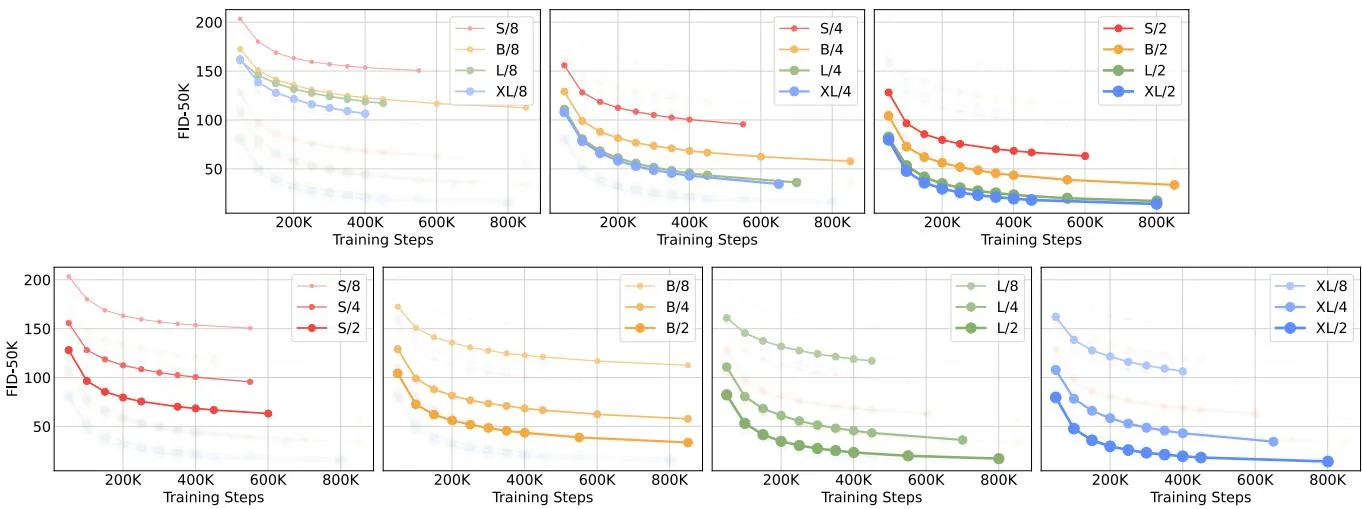
训练 12 个模型(S/B/L/XL × p=8/4/2):
- 增大模型 + 减小 patch → 持续改善 FID(图 6)
- 参数量不唯一决定质量:固定模型规模、减小 patch,参数几乎不变(实际略降),仅 Gflops 增加即改善 FID → Gflops 是关键
- 图 8:不同配置在 Gflops 相近时 FID 相近(如 DiT-S/2 ≈ DiT-B/4),Gflops 与 FID-50K 强负相关
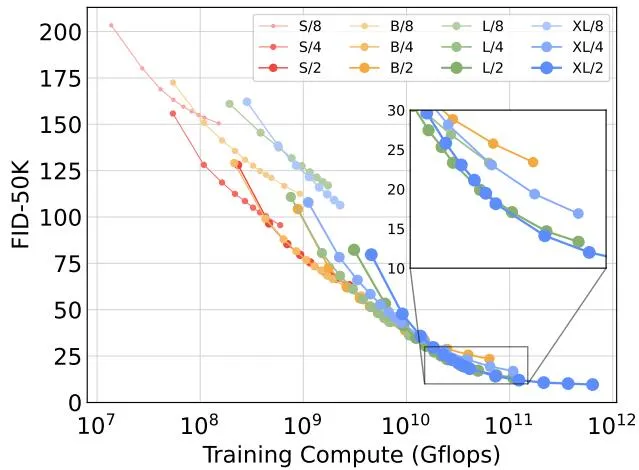
大模型计算效率更高(图 9):训练计算量估计为 模型 Gflops · batch · 步数 · 3。小模型即使训练更久,最终也比训练更少步数的大模型计算效率低。如 XL/4 在约 Gflops 后被 XL/2 超越。
5.4 SOTA 对比
ImageNet 256×256(DiT-XL/2 训练 7M 步):
| 模型 | FID↓ | sFID↓ | IS↑ | Precision↑ | Recall↑ |
|---|---|---|---|---|---|
| StyleGAN-XL | 2.30 | 4.02 | 265.12 | 0.78 | 0.53 |
| ADM-G, ADM-U | 3.94 | 6.14 | 215.84 | 0.83 | 0.53 |
| LDM-4-G (cfg=1.50) | 3.60 | - | 247.67 | 0.87 | 0.48 |
| DiT-XL/2-G (cfg=1.50) | 2.27 | 4.60 | 278.24 | 0.83 | 0.57 |
将先前最佳(LDM 3.60)降至 2.27;即使仅训 2.35M 步(与 ADM 相当),FID 2.55 仍超越所有先前扩散模型。
ImageNet 512×512(训练 3M 步,patch=2,处理 64×64×4 latent 的 1024 token,524.6 Gflops):
| 模型 | FID↓ | Gflops |
|---|---|---|
| ADM-G, ADM-U | 3.85 | 2813 |
| DiT-XL/2-G (cfg=1.50) | 3.04 | 524.6 |
将先前最佳(ADM 3.85)降至 3.04,且 Gflops 远低于 ADM(1983)/ADM-U(2813)。
5.5 模型算力 vs 采样算力
DiT 独特之处:训练后可通过增加采样步数增加计算。研究小模型能否用更多采样算力超越大模型(12 个模型 × [16,32,64,128,256,1000] 采样步):
- DiT-L/2 用 1000 步(80.7 Tflops/图)vs DiT-XL/2 用 128 步(15.2 Tflops/图,少 5×)
- 后者 FID-10K 更优(23.7 vs 25.9)
- 结论:增加采样算力无法弥补模型算力的不足
六、总结
核心贡献
- DiT 架构:简单的 Transformer 扩散骨干,超越先前 U-Net 模型并继承 Transformer 的优异可扩展性
- adaLN-Zero 块:高效的条件注入机制,零初始化恒等映射
- Gflops-FID 规律:揭示模型计算量是扩散模型质量的关键决定因素
- SOTA:ImageNet 256×256 FID 2.27、512×512 FID 3.04,且计算效率高一个量级
技术影响
- 奠定现代生成模型架构范式:Sora、Stable Diffusion 3、PixArt、FLUX、Wan、HunyuanVideo 等均采用 DiT 骨干
- “patchify → DiT blocks → unpatchify” 与 adaLN 条件注入成为标准组件
- 后续 patch 效率优化(PPFlow、DDiT 等)皆在此范式上展开
局限性与未来方向
- 论文提出应继续将 DiT 扩展到更大模型与更多 token
- 可作为文生图模型(DALL·E 2、Stable Diffusion)的即插即用骨干——这一预测已被后续工作充分验证
七、参考资源
- arXiv: https://arxiv.org/abs/2212.09748
- 代码: https://github.com/facebookresearch/DiT
- 相关工作: ADM、LDM/Stable Diffusion、ViT、Classifier-free Guidance
- 衍生架构: Sora、SD3、PixArt-α、FLUX、Wan、HunyuanVideo
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
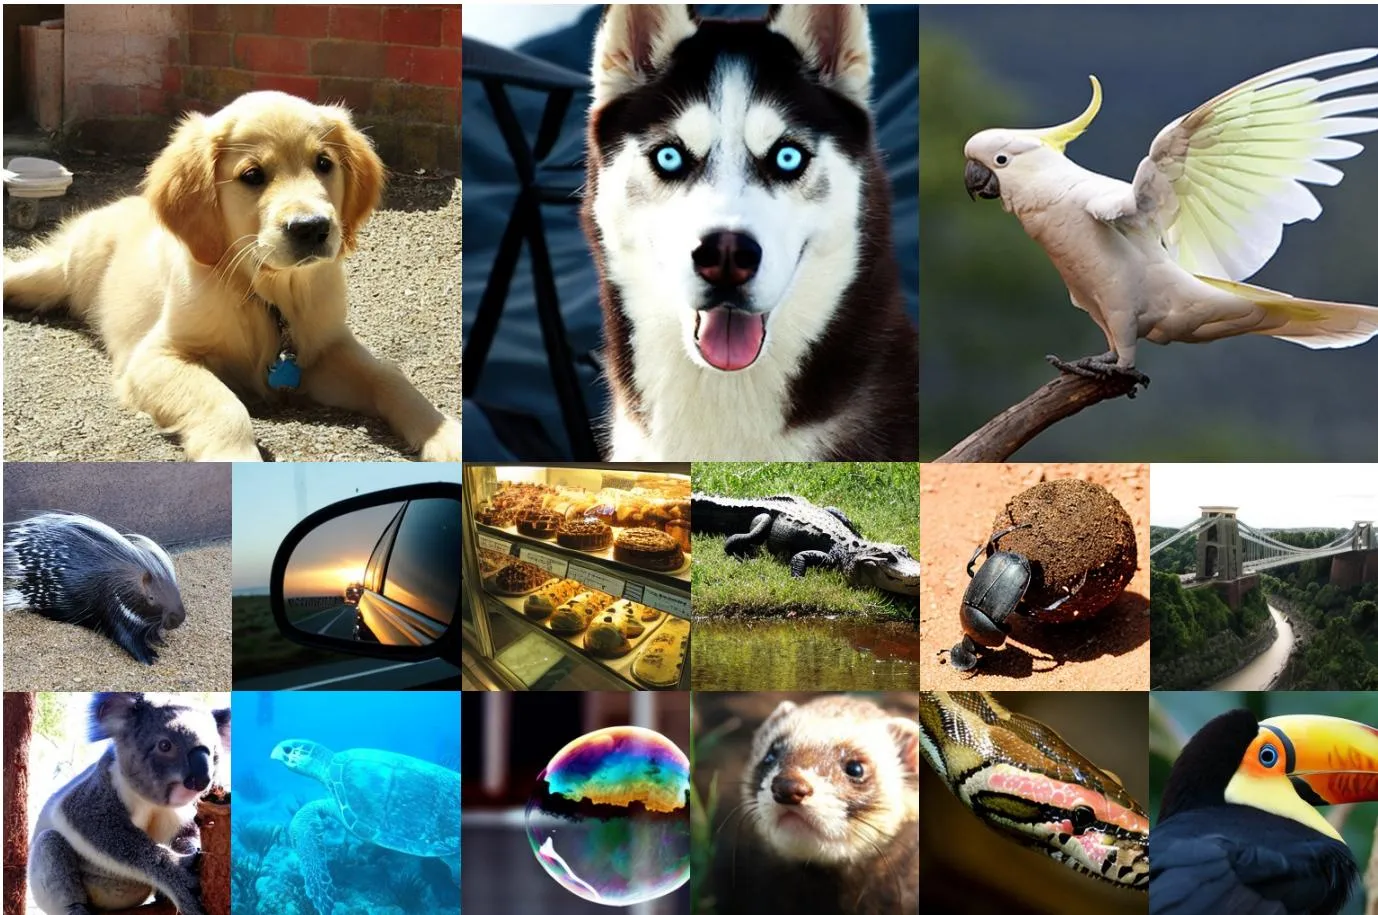
| Figure 1 | DiT-XL/2 生成样本展示 | figure-1-teaser.jpg |
| Figure 3 | DiT 架构总览(含四种 block 设计) | figure-3-architecture.jpg |
| Figure 4 | Patchify 输入规格 | figure-4-input-spec.jpg |
| Figure 5 | 条件注入策略对比(adaLN-Zero 最优) | figure-5-conditioning.jpg |
| Figure 6 | 模型规模缩放改善 FID | figure-6-scaling-fid.jpg |
| Figure 8 | Gflops 与 FID 强负相关 | figure-8-gflops-fid.jpg |
| Figure 9 | 更大模型计算效率更高 | figure-9-compute-efficiency.jpg |
分析日期: 2026-07-07 分析师: AI Paper Analyzer