Tight Certification of Adversarially Trained Neural Networks via Nonconvex Low-Rank Semidefinite Relaxations
基于低秩约束 SDP 松弛的非凸方法,突破 LP 验证器的凸松弛屏障
Tight Certification of Adversarially Trained Neural Networks via Nonconvex Low-Rank Semidefinite Relaxations
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Tight Certification of Adversarially Trained Neural Networks via Nonconvex Low-Rank Semidefinite Relaxations |
| 作者 | Hong-Ming Chiu, Richard Y. Zhang |
| 机构 | University of Illinois at Urbana-Champaign |
| 论文 | arXiv:2211.17244 |
| 代码 | https://github.com/Hong-Ming/BM-r |
| 发表 | ICML 2023 |
| 发布 | 2022-11-30 (v1), 2023-06-14 (v3) |
二、核心思想
问题定义
对抗训练(Adversarial Training)是使神经网络模型对对抗扰动具有鲁棒性的有效策略,但它是一种经验性方法,不保证模型真正鲁棒。因此需要形式化认证(formal certification)来证明模型对所有可能的未来攻击都是鲁棒的。
现有认证方法面临”凸松弛屏障”(convex relaxation barrier):
- LP 方法:基于线性规划(Wong & Kolter, 2018; CROWN 等)速度快但松弛严重,对对抗训练的模型认证鲁棒准确率仅 20.9%(而 PGD 上界为 77.4%)
- MILP/BnB 方法:如 α,β-CROWN 理论上可精确认证,但实际在合理时间内无法超越 67.2%
- SDP 方法:Raghunathan et al. (2018b) 提出的 SDP 松弛理论上更紧,但需要优化 变量( 为 ReLU 激活总数),即使 MNIST 上 200 个神经元的单层分类器也需要优化 变量的 矩阵,完全不可行
解决方案概述
提出一种非凸认证方法,基于 SDP 松弛的低秩约束(rank-r restriction),即 Burer-Monteiro 因子化。核心思想:
- 不删除 rank-1 约束(如传统 SDP),而是将其放松为 rank-r 约束()
- 将优化变量从 对称矩阵 分解为 因子矩阵 ,变量数从 降至
- 利用 Lagrangian 对偶理论证明:如果局部最优解也是全局最优解,则 KKT 乘子同时认证其全局最优性
- 如果不是全局最优,则 KKT 乘子生成一个全局改进方向,通过秩提升(rank lifting)逃逸鞍点
- 结合逐层预激活界限(BM-Full),几乎完全关闭了对抗训练模型的精确认证差距
三、技术架构
核心框架图
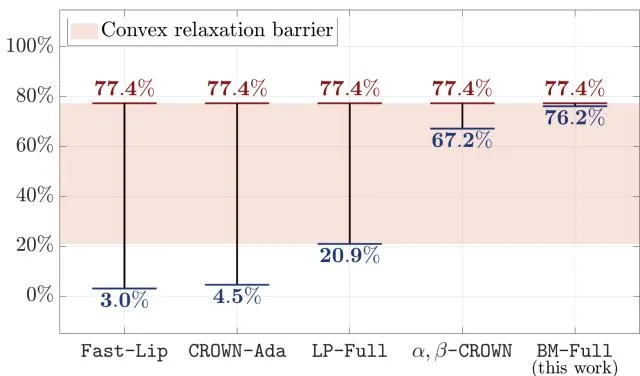
PGD 上界 77.4%,LP 方法下界 20.9%(粉色阴影 = 凸松弛屏障),α,β-CROWN 达 67.2%,本文 BM-Full 达 76.2%
关键实验可视化
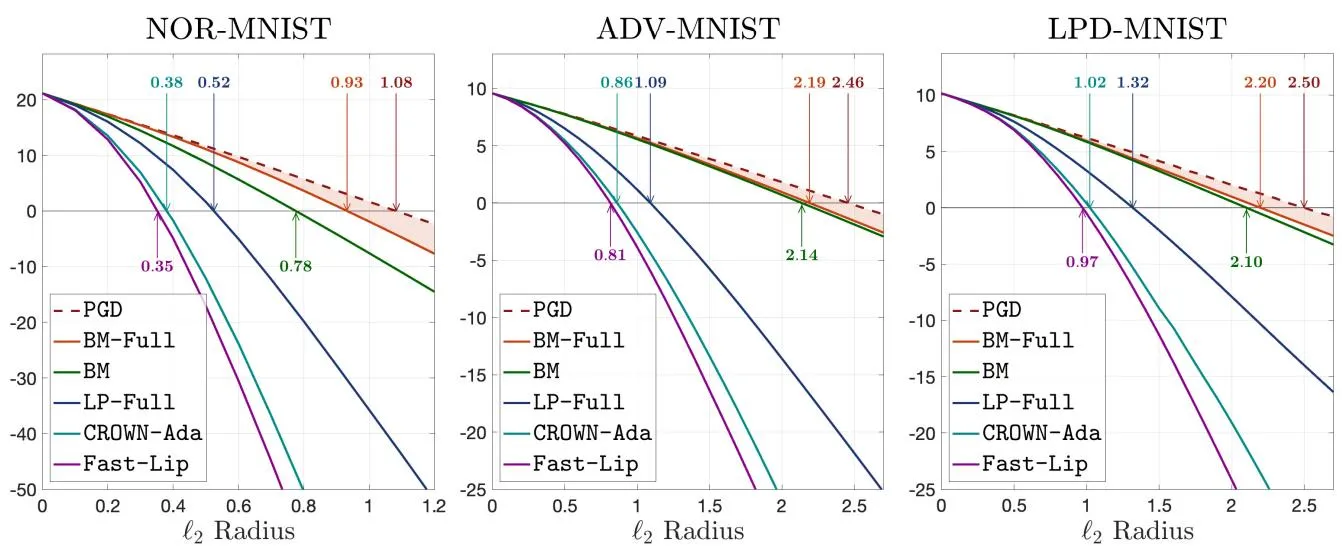 不同 扰动半径下的平均下界 vs PGD 上界 — BM-Full 始终最接近上界
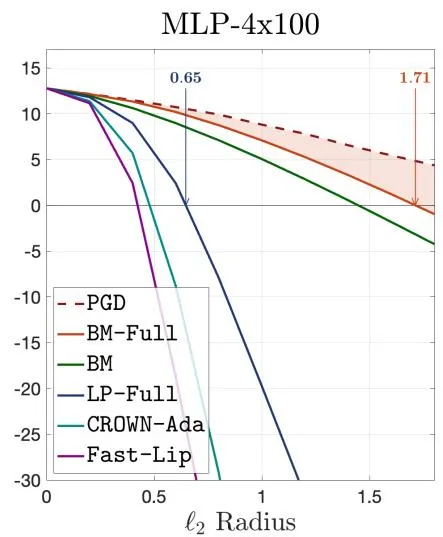 不同网络深度(4/6/9 层)下 BM 与 BM-Full 的下界对比
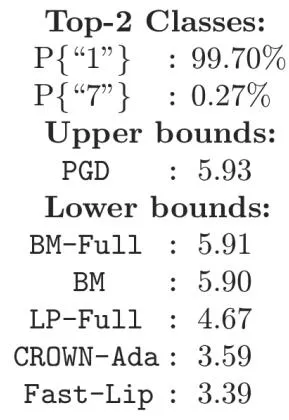 对抗示例可视化 — 不同半径下各验证器的下界对比
核心公式
半目标攻击问题(原始验证问题):
其中 是鲁棒边际(robustness margin), 表示认证鲁棒。
SDP 松弛(Raghunathan et al., 2018b):
使用 ReLU 的 rank-1 SDP 重构,优化变量 满足 且 :
低秩约束 SDP(SDP-r):
当 时等价于原始问题 (A);当 时等价于凸 SDP 松弛。
Burer-Monteiro 因子化(BM-r):
约束包括:
- 输入约束:
- ReLU 不等式:
- ReLU 互补:
- 迹约束:
变量数从 降至 。
对偶下界(Proposition 3.1):
定义松弛矩阵 ,其中 和 是对偶乘子:
全局最优性认证(Theorem 4.3):
若 是全局最优且满足 NPCQ(非零预激活约束条件),则认证一阶最优性的对偶乘子 也认证其全局最优性:
逃逸升维鞍点(Theorem 4.4):
若非全局最优且 ,则特征向量 隐式定义逃逸路径:
使目标产生二阶改进:。
算法流程(Algorithm 1)
输入: 初始松弛秩 r ≥ 2, 网络权重 W₁,...,W_ℓ 和偏置 b₁,...,b_ℓ,
      输入 x̂, 真实标签 ĉ, 目标标签 c, 扰动大小 ρ, 半径界 R

1. 求解 rank-r 松弛: 用非线性规划求解器求解 (BM-r)
   → 获取对偶乘子 y, z

2. 检查可认证的一阶最优性:
   若 ‖∇f(x) + ∇g(x)y + ∇h(x)z‖ 足够小且 g(x) ≤ 0, h(x) = 0
   → 继续;否则报错

3. 检查对偶可行性:
   计算 ε_feas = -λ_min[S(y,z)]
   若 ε_feas 足够小 → 返回 φ_lb[c] = z₀ - ε_feas · R²
   否则 → 继续

4. 逃逸升维鞍点:
   计算满足 ξ^T S(y,z)ξ = -ε_feas ‖ξ‖² 的特征向量 ξ
   设置新初始点 x₊ = ({u_k}, {vec(V_{+,k})})
   其中 V_{+,k} = [V_k, 0] + ε · [0, u_k ξ₀/u₀ + ξ_k]
   递增 r ← r + 1,以 (x₊, y, z) 为初始点重复步骤 1
BM 与 BM-Full 的区别
| 变体 | 说明 | 特点 |
|---|---|---|
| BM | 基本非凸 SDP 松弛 | 变量 ,速度快,中等精度 |
| BM-Full | BM + 逐层预激活界限 | 添加 bound propagation,精度显著提升 |
BM-Full 中的预激活界限通过将逐元素 约束转化为 Burer-Monteiro 形式加入:
四、核心创新
| 创新点 | 说明 | 依据 |
|---|---|---|
| 非凸低秩 SDP 松弛 | 首次将 Burer-Monteiro 因子化应用于对抗认证 | 变量从 →, |
| 全局最优性理论保证 | 证明在 LICQ 成立时,局部最优的对偶乘子自动认证全局最优 | Theorem 4.3, Lemma 4.2 |
| 逃逸鞍点机制 | 利用对偶间隙生成改进方向,秩提升逃逸 | Theorem 4.4,实践中 即可 |
| BM-Full 预激活界限 | 将 bound propagation 融入非凸框架 | 几乎完全关闭凸松弛屏障 |
| NPCQ 约束条件证明 | 形式化证明 ReLU 网络的 LICQ 在非零预激活时成立 | Lemma 4.2 |
五、实验结果
MNIST 认证结果(Table 1, 攻击)
| 网络 | 半径 | PGD UB | BM-Full | BM | α,β-CROWN | LP-Full | CROWN-Ada | Fast-Lip |
|---|---|---|---|---|---|---|---|---|
| 认证数量(时间) | ||||||||
| ADV-MNIST | 1.0 | 774 | 762 (47s) | 757 (28s) | 672 (24s) | 209 (8s) | 45 (12ms) | 30 (13ms) |
| ADV-MNIST | 1.3 | 614 | 569 (38s) | 559 (28s) | 399 (94s) | 25 (10s) | 7 (9ms) | 2 (12ms) |
| ADV-MNIST | 1.5 | 471 | 411 (56s) | 392 (20s) | 248 (138s) | 11 (11s) | 1 (9ms) | 1 (13ms) |
| LPD-MNIST | 1.0 | 755 | 730 (218s) | 708 (29s) | 641 (10s) | 411 (16s) | 120 (10ms) | 66 (13ms) |
| LPD-MNIST | 1.3 | 612 | 514 (129s) | 474 (26s) | 430 (33s) | 61 (19s) | 16 (10ms) | 8 (13ms) |
| LPD-MNIST | 1.5 | 505 | 391 (98s) | 350 (23s) | 316 (64s) | 23 (20s) | 5 (10ms) | 2 (14ms) |
| NOR-MNIST | 0.3 | 916 | 911 (128s) | 866 (21s) | 797 (23s) | 728 (8s) | 420 (9ms) | 348 (12ms) |
| NOR-MNIST | 0.5 | 732 | 696 (127s) | 534 (27s) | 424 (159s) | 232 (16s) | 46 (7ms) | 27 (13ms) |
| NOR-MNIST | 0.7 | 485 | 381 (156s) | 187 (30s) | 124 (253s) | 37 (19s) | 0 (13ms) | 0 (17ms) |
关键发现:
- BM-Full 在所有情况下显著优于所有 LP 基线
- 在小半径时,BM-Full 几乎认证了所有 PGD 无法攻破的样本(差距 <2%)
- 在大半径时,只有 BM-Full/BM 仍能验证大量样本
- 速度比 LP-Full 慢 5-10 倍,但远快于 α,β-CROWN(超时 300s)
认证结果(Table 2)
| 网络 | 半径 | PGD UB | BM-Full | BM | α,β-CROWN | LP-Full | CROWN-Ada | Fast-Lip |
|---|---|---|---|---|---|---|---|---|
| ADV-MNIST | 0.10 | 831 | 791 (87s) | 760 (124s) | 791 (2s) | 314 (16s) | 8 (10ms) | 4 (13ms) |
| ADV-MNIST | 0.13 | 731 | 632 (102s) | 574 (144s) | 673 (11s) | 46 (17s) | 1 (9ms) | 0 (13ms) |
| ADV-MNIST | 0.15 | 626 | 484 (127s) | 366 (125s) | 535 (22s) | 11 (15s) | 0 (9ms) | 0 (14ms) |
| LPD-MNIST | 0.10 | 868 | 855 (125s) | 828 (163s) | 818 (0.2s) | 829 (13s) | 589 (12ms) | 540 (10ms) |
| LPD-MNIST | 0.13 | 791 | 768 (104s) | 713 (126s) | 743 (0.2s) | 689 (13s) | 154 (10ms) | 120 (11ms) |
| LPD-MNIST | 0.15 | 727 | 672 (120s) | 597 (132s) | 672 (0.3s) | 545 (12s) | 43 (9ms) | 32 (12ms) |
| NOR-MNIST | 0.02 | 910 | 898 (99s) | 859 (116s) | 881 (1.4s) | 686 (3s) | 130 (9ms) | 88 (12ms) |
| NOR-MNIST | 0.03 | 775 | 729 (143s) | 617 (107s) | 713 (16s) | 278 (4s) | 8 (8ms) | 3 (12ms) |
| NOR-MNIST | 0.05 | 401 | 267 (229s) | 127 (154s) | 238 (43s) | 10 (5s) | 0 (12ms) | 0 (17ms) |
理论复杂度
| 方法 | 时间复杂度 | 空间复杂度 |
|---|---|---|
| LP (CROWN/Fast-Lip) | ||
| LP-Full | ||
| BM (基本非凸) | ||
| BM-Full | ||
| α,β-CROWN (BnB) | 指数级(最坏) | |
| 凸 SDP (MOSEK) |
其中 为总神经元数, 为松弛秩(实验中 ), 为 bound propagation 的额外项。
六、消融研究
松弛秩 的影响
实践中, 即可将对偶间隙降低到 量级。随着 递增:
- 下界单调收紧:
- 计算成本增加但可控
- 理论上完全精确认证需要 ,但实践中小 已足够
BM vs BM-Full
| 方面 | BM | BM-Full |
|---|---|---|
| 预激活界限 | 无 | 有(与 LP-Full 相同) |
| 精度 | 好 | 更好 |
| 深度网络表现 | 6 层以上开始松动 | 所有深度均保持紧致 |
| 速度 | 更快 | 稍慢(bound propagation 开销) |
关键发现:没有 bound propagation 的 BM 在超过 6 层时开始松动,而 BM-Full 在所有深度下均显著优于 LP-Full。
训练方式的影响
LPD-MNIST 使用 Wong & Kolter (2018) 的对偶下界最大化训练,因此 LP 基线在其上表现较好。但 Madry et al. (2018) 训练的 ADV-MNIST 上,LP 方法差距巨大。本文方法对两种训练方式均有效。
七、相关工作
| 方向 | 代表工作 | 局限性 |
|---|---|---|
| 精确方法 | MILP (Tjeng et al., 2019), SMT (Katz et al., 2017) | 最坏情况指数时间 |
| LP 松弛 | CROWN, Fast-Lip, LP-Full (Salman et al., 2019) | 凸松弛屏障,无法超越理论极限 |
| BnB 增强 | α,β-CROWN (Wang et al., 2021) | 300s 超时仍无法达到精确 |
| SDP 松弛 | Raghunathan et al. (2018b), Batten et al. (2021) | 不可扩展 |
| 随机平滑 | Cohen et al. (2019) | 精度损失大 |
八、总结
核心贡献
- 非凸低秩 SDP 松弛:将 SDP 变量从 降至 , 即可实现接近精确认证的精度
- 全局最优性理论:证明在 LICQ 成立时,标准 NLP 求解器的对偶乘子自动认证全局最优性
- 逃逸鞍点机制:利用对偶间隙的特征向量生成改进方向,秩提升确保收敛到全局最优
- 突破凸松弛屏障:BM-Full 在 ADV-MNIST () 上认证 762/774 个鲁棒样本(vs PGD UB 774),几乎完全关闭差距
- 跨训练方式有效:对 Madry 训练和对偶下界最大化训练均有效
性能总结
| 指标 | BM-Full | α,β-CROWN | LP-Full | CROWN-Ada |
|---|---|---|---|---|
| ADV-MNIST 认证数 | 762 | 672 | 209 | 45 |
| 相对 LP-Full 提升 | 3.6× | 3.2× | 1× | 0.2× |
| 相对 PGD UB 覆盖率 | 98.4% | 86.8% | 27.0% | 5.8% |
局限性
- 仅在 MNIST 小规模网络上验证,未扩展到 CIFAR-10 或 ImageNet
- 依赖通用 NLP 求解器(KNITRO),专用求解器未开发
- 深度网络(≥9 层)中 BM 开始松动,需依赖 BM-Full
- 理论完全精确认证需要 ,实践中小 的有效性为经验观察
- MATLAB 实现,未做工程优化
九、参考资源
- arXiv: 2211.17244
- GitHub: https://github.com/Hong-Ming/BM-r
- 凸松弛屏障: Salman et al., NeurIPS 2019
- SDP 松弛: Raghunathan et al., ICLR 2018
- CROWN: Zhang et al., ICLR 2018/2020
- α,β-CROWN: Wang et al., NeurIPS 2021
- Burer-Monteiro: Burer & Monteiro, Math. Programming 2003
- Madry 对抗训练: Madry et al., ICLR 2018