SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language
通过平滑激活离群值实现LLM的W8A8量化,支持高达530B参数模型的无损量化
SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models |
| 作者 | Guangxuan Xiao, Ji Lin, Mickael Seznec, Hao Wu, Julien Demouth, Song Han |
| 机构 | MIT, NVIDIA |
| 论文 | arXiv:2211.10438 |
| 代码 | GitHub |
| 发布 | 2022年11月18日(v1),2024年3月29日(v7) |
| 引用 | 2000+ |
二、核心思想
SmoothQuant是一种训练无关、精度保持、通用的后训练量化(PTQ)方法,通过数学等价的per-channel缩放变换,将激活中的离群值”平滑”到权重中,使激活变得易于量化,从而实现LLM的W8A8量化。
问题定义
LLM量化的两大挑战:
| 挑战 | 说明 |
|---|---|
| 激活离群值 | 当模型规模超过6.7B时,激活中出现系统性离群值,幅度比正常值大~100× |
| 硬件效率 | Per-channel激活量化精度好但无法高效映射到硬件GEMM内核 |
关键观察:
- 权重分布均匀平坦,易于量化(INT4甚至INT2都不会显著降低精度)
- 激活存在离群值,per-tensor量化会导致严重精度损失
- 离群值出现在固定的通道中,跨token一致
解决方案
SmoothQuant的核心公式:
通过per-channel平滑因子 将量化难度从激活迁移到权重。
三、技术架构
模型规模与GPU内存差距
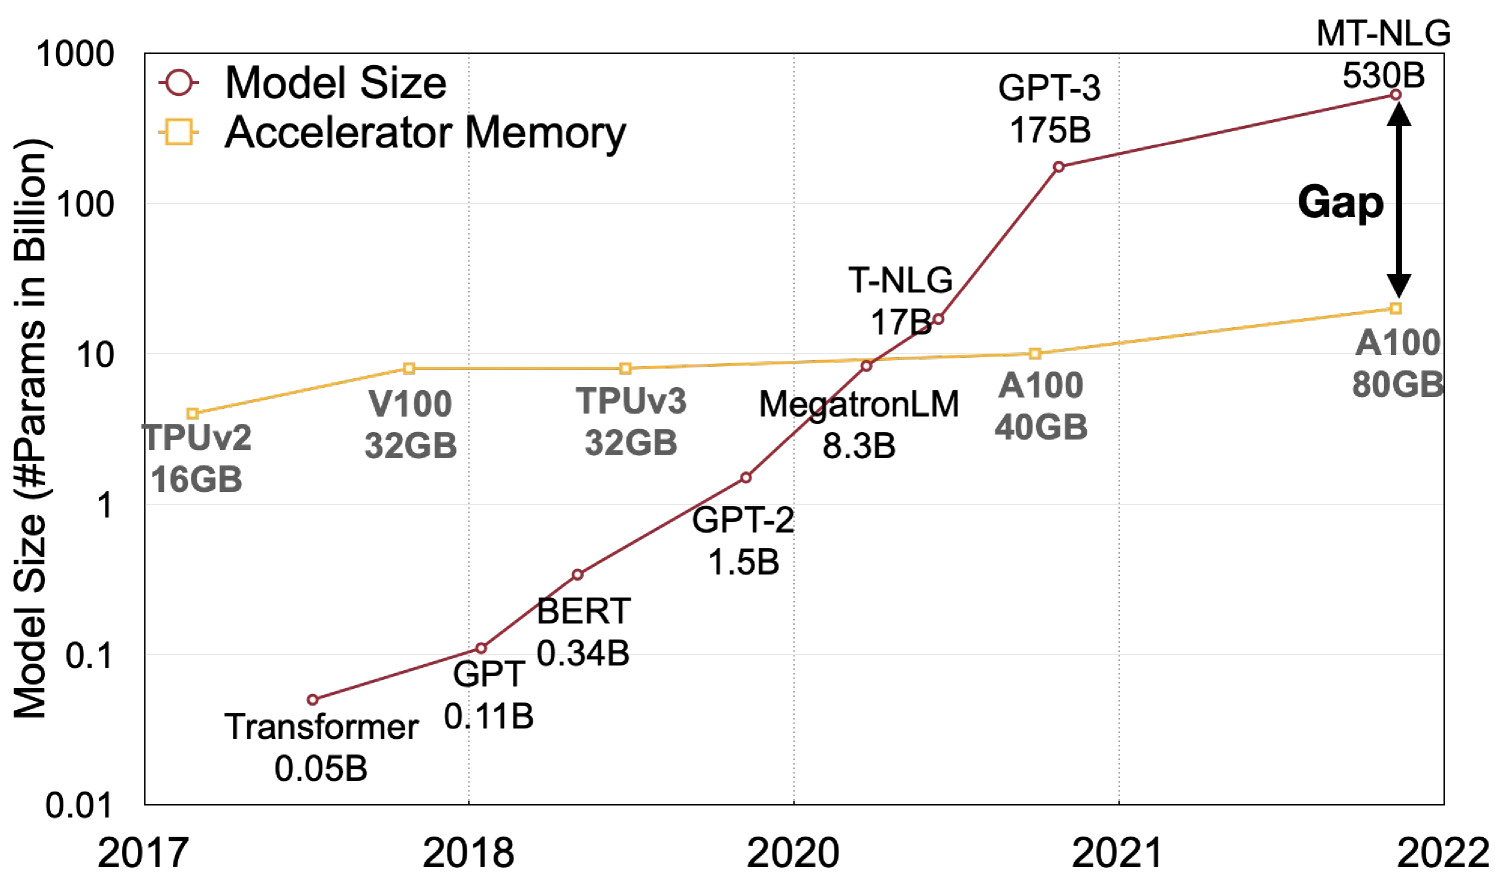
LLM模型规模的增长速度远超GPU内存,量化成为必然选择。
量化难度分析
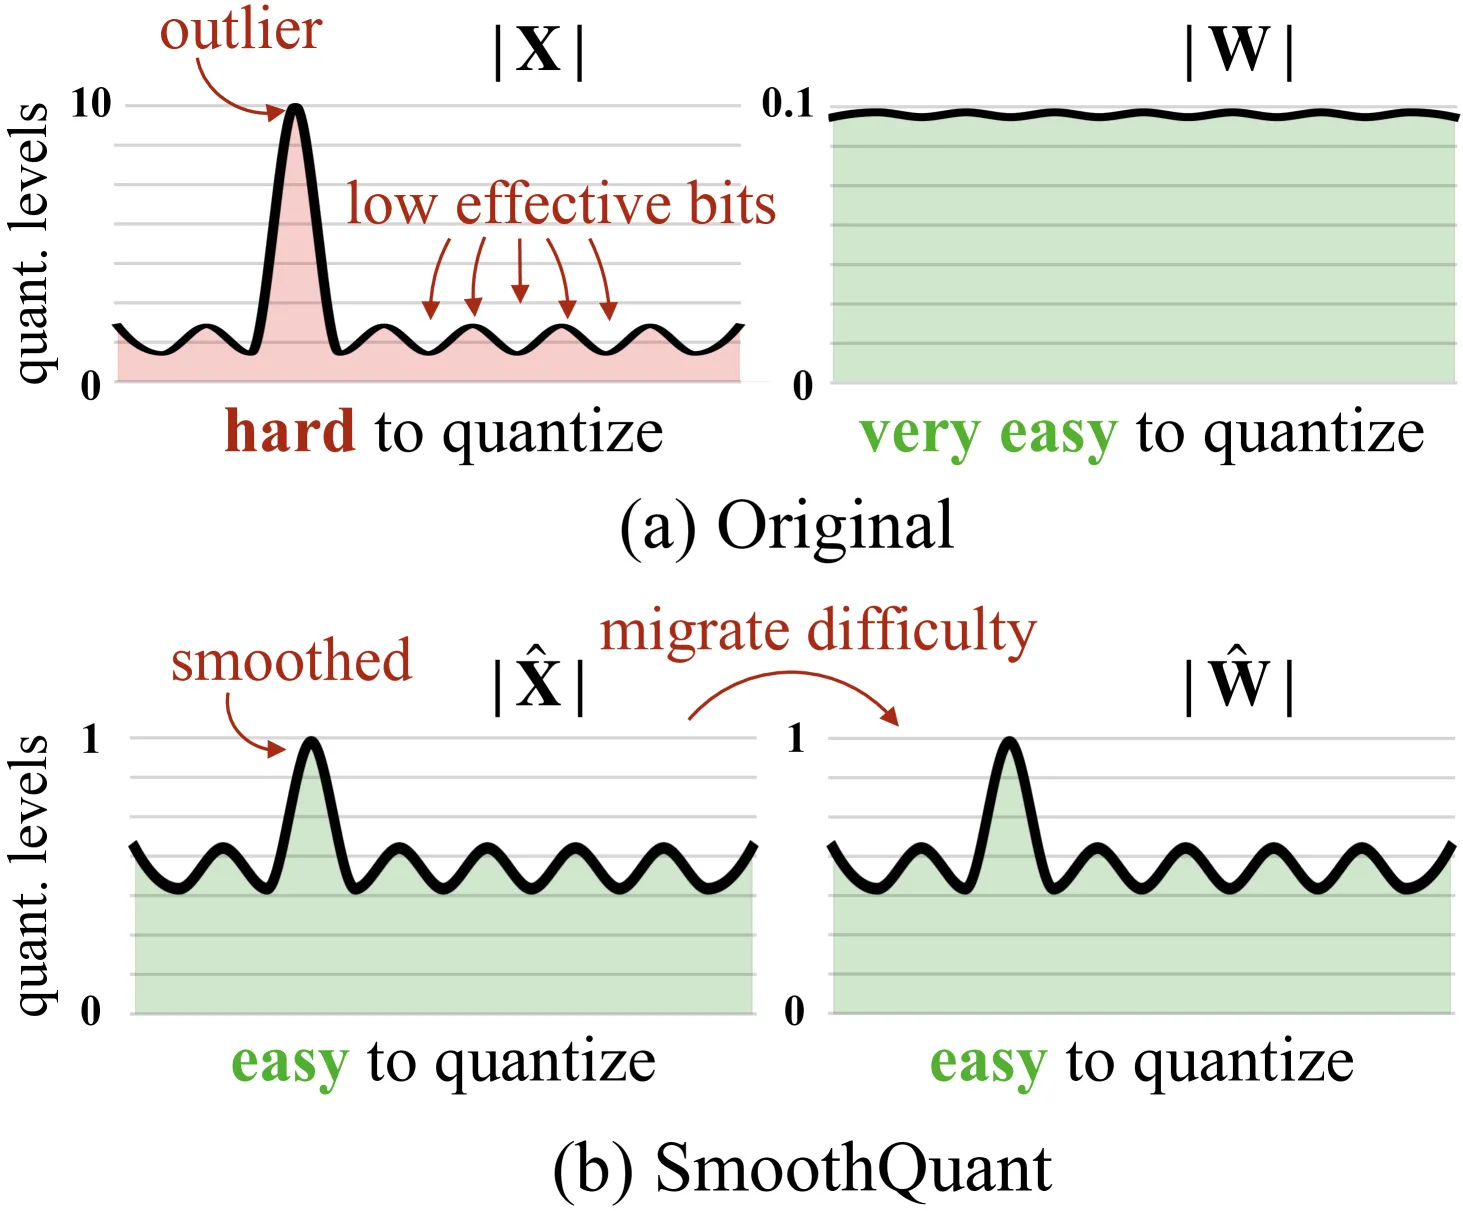
- 左图:激活有离群值,难以量化(有效量化位数低)
- 右图:平滑后激活分布均匀,易于量化
- 权重吸收了部分量化难度,但仍可接受
量化粒度
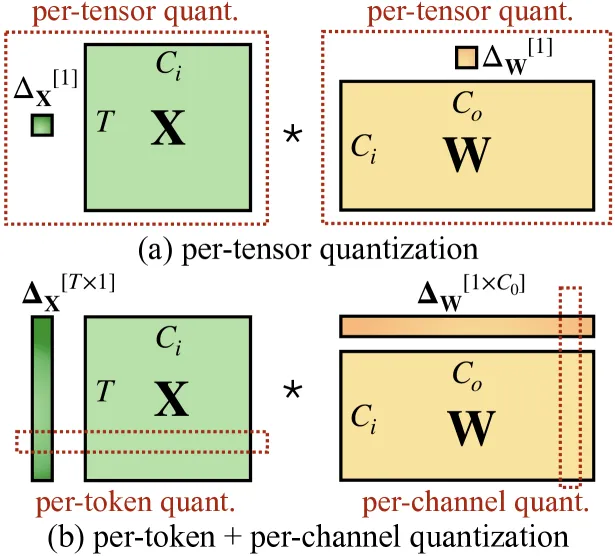
| 粒度 | 说明 | 硬件效率 | 精度 |
|---|---|---|---|
| Per-tensor | 整个矩阵一个缩放因子 | 最高 | 最低 |
| Per-token | 每个token一个缩放因子 | 高 | 中 |
| Per-channel | 每个通道一个缩放因子 | 低 | 最高 |
| Group-wise | 每组通道一个缩放因子 | 中 | 中高 |
关键矛盾:Per-channel激活量化精度最好,但无法高效映射到硬件GEMM内核。
激活离群值分析
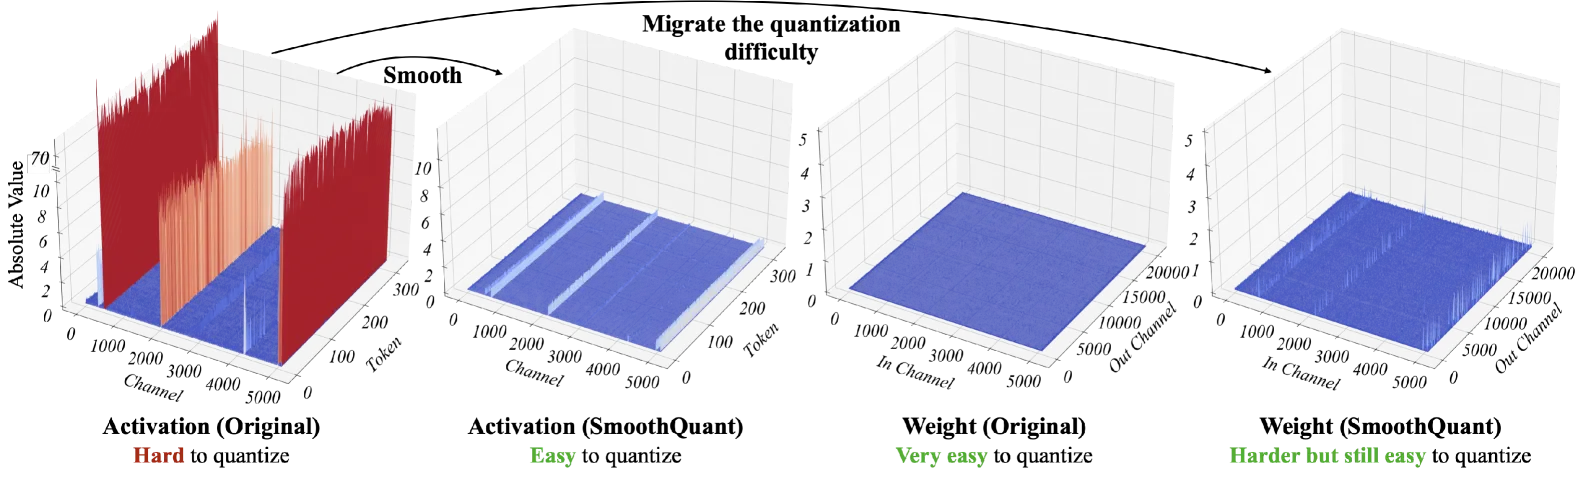
在OPT-13B上的观察:
- 激活比权重难量化:权重分布均匀,激活有显著离群值
- 离群值幅度大:离群值比正常值大~100×
- 离群值在固定通道:如果某通道有离群值,它在所有token中都持续存在
Per-tensor量化的有效位数:
当 时,非离群通道的有效量化位数极低。
SmoothQuant核心思想
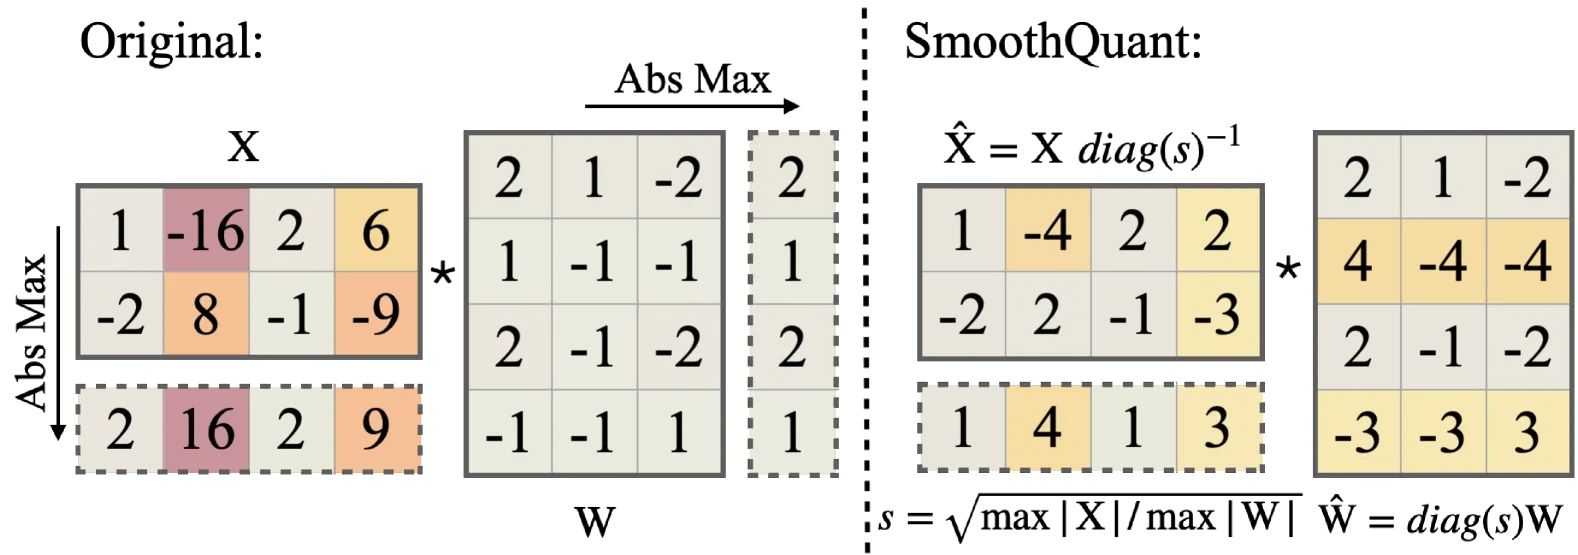
平滑因子计算:
其中 是迁移强度超参数:
- :不迁移,激活承担全部量化难度
- :完全迁移,权重承担全部量化难度
- :平衡迁移,大多数模型的最优选择
平滑操作:
- 离线将平滑因子融合到前一层的参数中(如LayerNorm的权重)
- 不引入额外的运行时开销
Transformer块的精度映射
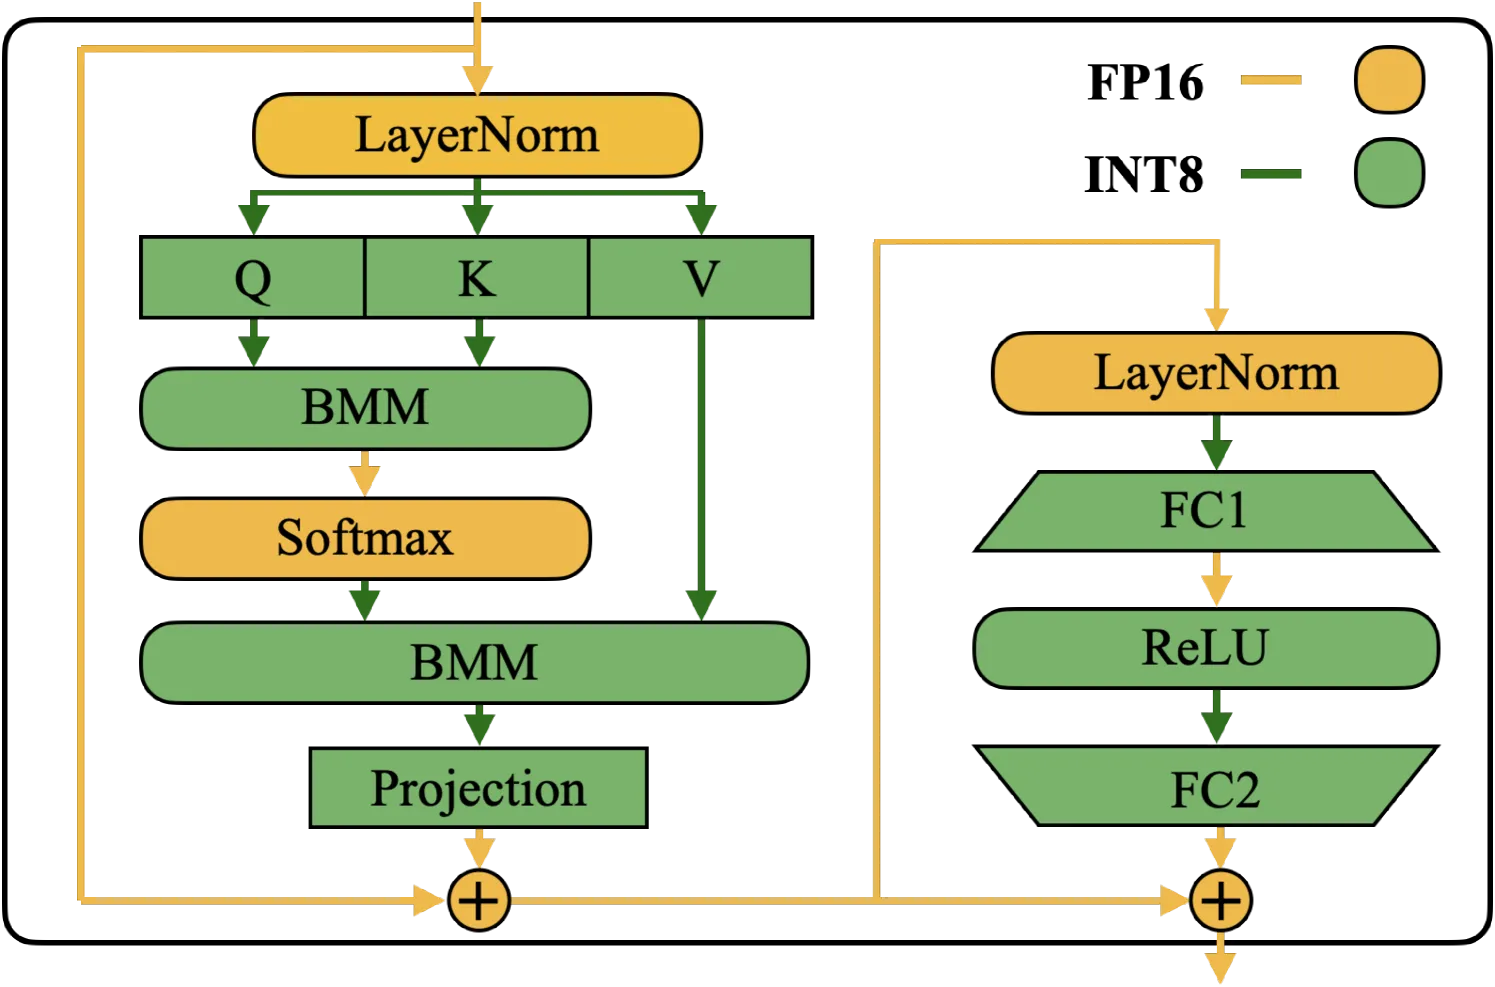
- INT8:所有计算密集的线性层和BMM操作
- FP16:轻量级逐元素操作(ReLU、Softmax、LayerNorm)
量化效率级别
| 级别 | 权重量化 | 激活量化 | 效率 | 精度 |
|---|---|---|---|---|
| O1 | Per-tensor | Per-token dynamic | 低 | 最高 |
| O2 | Per-tensor | Per-tensor dynamic | 中 | 高 |
| O3 | Per-tensor | Per-tensor static | 最高 | 高 |
四、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 激活平滑 | 数学等价的per-channel缩放 | 将离群值从激活迁移到权重 |
| 迁移强度α | 控制量化难度分配 | α=0.5是大多数模型的最优选择 |
| 离线融合 | 平滑因子融合到前层参数 | 零运行时开销 |
| 三级效率 | O1/O2/O3渐进式量化 | 灵活的精度-效率权衡 |
| 通用性 | 支持OPT/BLOOM/GLM/LLaMA/Falcon/Mistral/Mixtral | 530B模型验证 |
与现有方法对比
| 方法 | 权重 | 激活 | 精度 | 速度 | 内存 |
|---|---|---|---|---|---|
| W8A8 naive | Per-tensor | Per-tensor | ✗ | ✓ | ✓ |
| ZeroQuant | Group-wise | Per-token | ✗ | ✓ | ✓ |
| LLM.int8() | Per-channel | Mixed FP16/INT8 | ✓ | ✗ | ✓ |
| Outlier Suppression | Per-tensor | Per-tensor static | ✗ | ✓ | ✓ |
| SmoothQuant-O3 | Per-tensor | Per-tensor static | ✓ | ✓ | ✓ |
SmoothQuant是唯一同时满足精度、速度、内存三重要求的方法。
五、实验结果
评估设置
| 项目 | 配置 |
|---|---|
| 模型 | OPT (6.7B-175B), BLOOM-176B, GLM-130B, LLaMA (7B-65B), Llama-2 (7B-70B), Falcon (7B-40B), Mistral-7B, Mixtral-8x7B, MT-NLG-530B |
| 基准 | LAMBADA, HellaSwag, PIQA, WinoGrande, OpenBookQA, RTE, COPA, WikiText, MMLU |
| 硬件 | NVIDIA A100 GPU |
| 校准 | 512条随机句子,来自Pile数据集 |
OPT-175B结果
Table 6: OPT-175B零样本准确率
| 方法 | LAMBADA | HellaSwag | PIQA | WinoGrande | OpenBookQA | RTE | COPA |
|---|---|---|---|---|---|---|---|
| FP16 | 74.7% | 59.3% | 79.7% | 72.6% | 34.0% | 59.9% | 88.0% |
| W8A8 | 0.0% | 25.6% | 53.4% | 50.3% | 14.0% | 49.5% | 56.0% |
| ZeroQuant | 0.0% | 26.0% | 51.7% | 49.3% | 17.8% | 50.9% | 55.0% |
| LLM.int8() | 74.7% | 59.2% | 79.7% | 72.1% | 34.2% | 60.3% | 87.0% |
| Outlier Suppression | 0.0% | 25.8% | 52.5% | 48.6% | 16.6% | 53.4% | 55.0% |
| SmoothQuant-O3 | 74.6% | 58.9% | 79.7% | 71.2% | 33.4% | 59.9% | 90.0% |
关键发现:
- 朴素W8A8、ZeroQuant、Outlier Suppression几乎产出随机结果
- LLM.int8()保持精度但速度慢(混合精度开销)
- SmoothQuant-O3在所有指标上匹配FP16
多模型验证
Table 7: 三个100B+模型的平均准确率
| 方法 | OPT-175B | BLOOM-176B | GLM-130B |
|---|---|---|---|
| FP16 | 71.6% | 68.2% | 73.8% |
| W8A8 | 32.3% | 64.2% | 26.9% |
| LLM.int8() | 71.4% | 68.0% | 73.8% |
| SmoothQuant-O1 | 71.2% | 68.3% | 73.7% |
| SmoothQuant-O3 | 71.1% | 67.4% | 72.8% |
LLaMA系列
Table 9: LLaMA困惑度(WikiText-2)
| 模型 | FP16 | W8A8 SmoothQuant |
|---|---|---|
| LLaMA-7B | 11.51 | 11.56 |
| LLaMA-13B | 10.05 | 10.08 |
| LLaMA-30B | 7.53 | 7.56 |
| LLaMA-65B | 6.17 | 6.20 |
SmoothQuant在LLaMA系列上实现几乎无损的W8A8量化。
更多架构
Table 10: Llama-2/Falcon/Mistral/Mixtral困惑度
| 模型 | FP16 PPL | W8A8 SQ PPL | α |
|---|---|---|---|
| Llama-2-7B | 5.474 | 5.515 | 0.85 |
| Llama-2-13B | 4.950 | 4.929 | 0.85 |
| Llama-2-70B | 3.320 | 3.359 | 0.9 |
| Falcon-7B | 6.590 | 6.629 | 0.6 |
| Falcon-40B | 5.228 | 5.246 | 0.7 |
| Mistral-7B | 8.158 | 8.243 | 0.85 |
| Mixtral-8x7B | 4.609 | 4.667 | 0.85 |
关键发现:
- SmoothQuant适用于多种架构(Dense、MoE)
- 不同模型需要不同的α值(0.6-0.9)
PyTorch实现性能
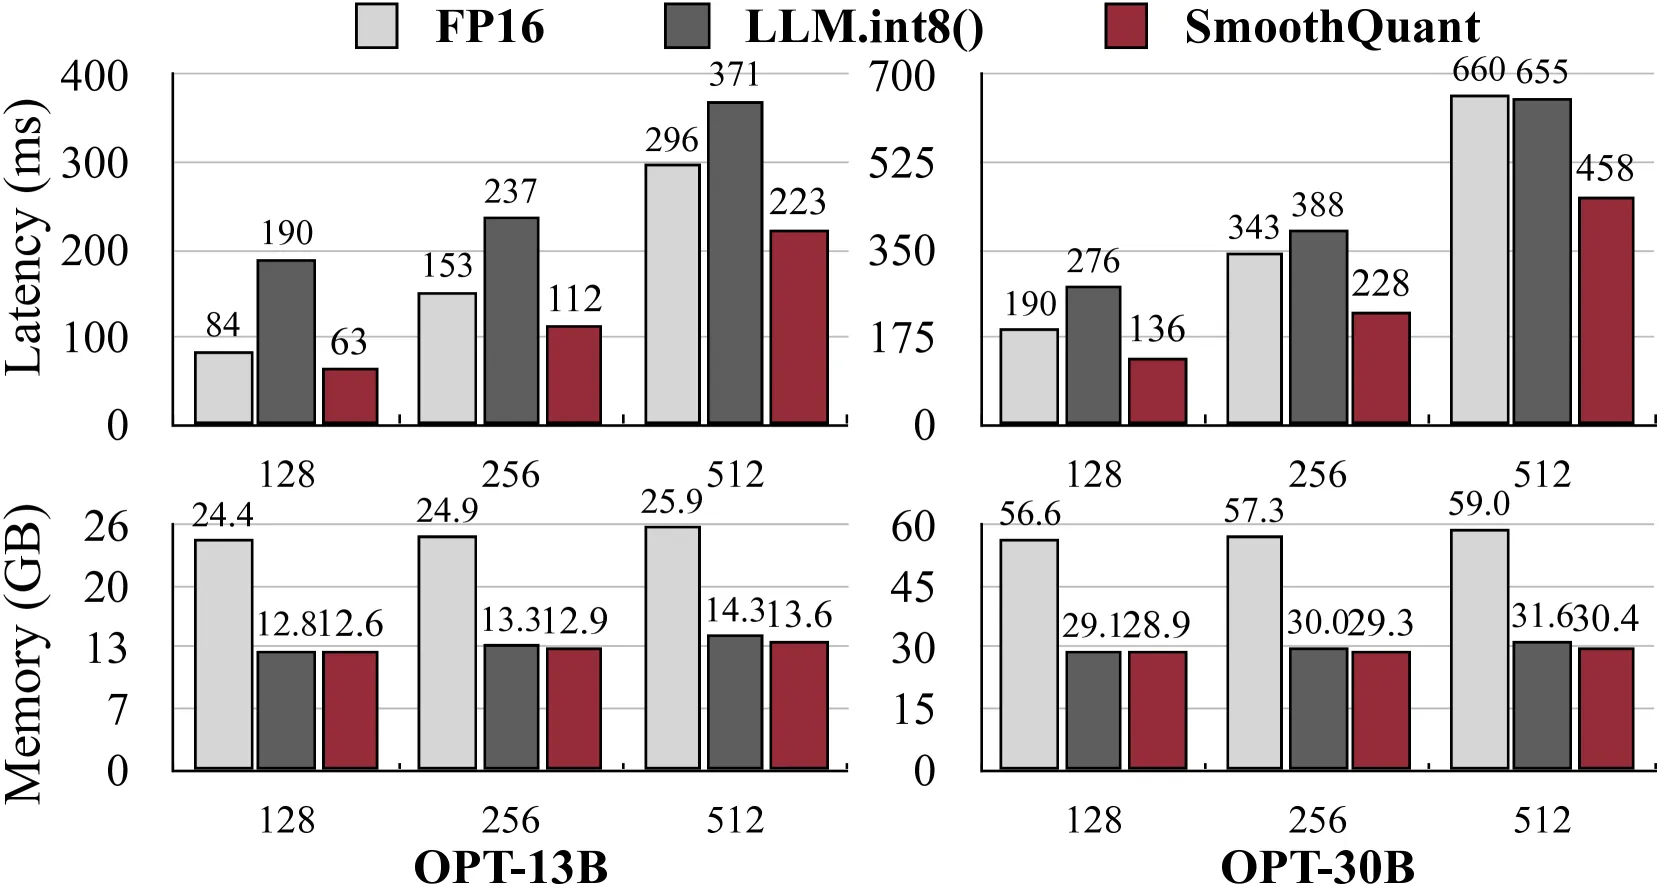
- SmoothQuant在OPT-30B上实现**1.51×**加速
- 模型越大,加速效果越显著
- LLM.int8()通常比FP16慢(混合精度开销)
- 内存减少近2×
FasterTransformer实现性能
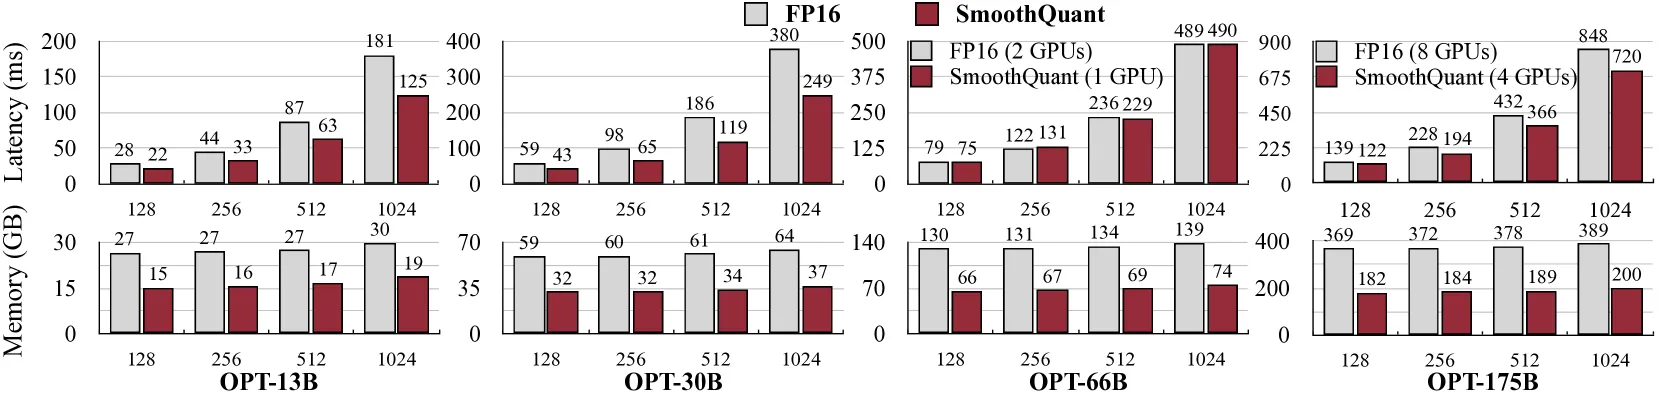
- OPT-30B单卡:最高**1.56×**加速
- OPT-66B:1 GPU达到2 GPU的FP16性能
- OPT-175B:4 GPU达到8 GPU的FP16性能
Table 11: MT-NLG 530B服务性能
| SeqLen | 精度 | GPU数 | 延迟 | 内存 |
|---|---|---|---|---|
| 256 | FP16 | 16 | 451ms | 1054GB |
| INT8 | 8 | 434ms | 533GB | |
| 1024 | FP16 | 16 | 1707ms | 1095GB |
| INT8 | 8 | 1689ms | 570GB |
关键发现:
- SmoothQuant将530B模型从16 GPU减少到8 GPU
- 延迟相当或更优
- 内存减少近2×
- 实现单节点(8×A100)部署500B+模型
解码阶段加速
Table 8: 解码阶段性能(OPT-30B,batch=16)
| SeqLen | FP16延迟 | SmoothQuant延迟 | 加速比 |
|---|---|---|---|
| 256 | 343.0ms | 227.6ms | 1.51× |
| 512 | 659.9ms | 458.4ms | 1.44× |
消融实验
迁移强度α的影响:
- α < 0.4:激活仍难量化,精度下降
- α > 0.6:权重变得难量化,精度下降
- α ∈ [0.4, 0.6]:最优区间,OPT-175B的sweet spot
量化方案延迟对比(Table 14,OPT-30B,SeqLen=512):
| 方案 | 延迟(ms) |
|---|---|
| FP16 | 659.9 |
| LLM.int8() | 654.9 |
| SmoothQuant-O1 | 490.7 |
| SmoothQuant-O2 | 478.3 |
| SmoothQuant-O3 | 458.4 |
越粗粒度的量化方案延迟越低,静态量化显著快于动态量化。
六、相关工作
| 方向 | 代表工作 | SmoothQuant优势 |
|---|---|---|
| 权重量化 | GPTQ | 同时量化激活,利用INT8 GEMM |
| 混合精度 | LLM.int8() | 无混合精度开销,速度更快 |
| 精度保持 | Outlier Suppression | 更有效地处理离群值 |
| 通用PTQ | ZeroQuant | 支持100B+模型,精度更高 |
| 激活量化 | Bondarenko et al. | 硬件友好的per-tensor方案 |
七、总结
核心贡献
- 发现激活离群值的固定通道特性,提出数学等价的平滑变换
- 通过迁移强度α平衡权重和激活的量化难度
- 实现训练无关、精度保持的W8A8 PTQ方案
- 支持从6.7B到530B的所有主流LLM架构
- 集成PyTorch和FasterTransformer,最高1.56×加速,2×内存节省
技术影响
- 开创了LLM激活平滑量化的研究方向
- 被QQQ、Atom等后续工作广泛引用和改进
- 已集成到vLLM、TensorRT-LLM等主流推理框架
- 2000+引用,成为LLM量化的基础方法
局限性
- 仅支持W8A8量化,不支持更低位宽(W4A4、W4A8)
- 需要校准数据集(512条句子)
- α值需要针对不同模型调整
- Per-tensor静态量化在某些模型上有轻微精度损失
应用场景
适合:
- 100B+大模型的高效部署
- 需要INT8 GEMM加速的场景
- 内存受限的推理服务
- 批处理推理优化
不适合:
- 需要W4或更低比特量化的场景
- 无校准数据的场景
- 对延迟极度敏感的单请求场景