Who Says Elephants Can''t Run: Bringing Large Scale MoE Models into Cloud
大规模MoE模型的高效推理框架,实现26倍吞吐量提升和4-bit量化
Who Says Elephants Can”t Run: Bringing Large Scale MoE Models into Cloud Scale Production
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Who Says Elephants Can’t Run: Bringing Large Scale MoE Models into Cloud Scale Production |
| 作者 | Young Jin Kim, Rawn Henry, Raffy Fahim, Hany Hassan Awadalla |
| 机构 | Microsoft, NVIDIA |
| 论文 | arXiv:2211.10017 |
| 发布 | 2022年11月18日 |
| 会议 | SustaiNLP 2022 (EMNLP 2022) |
| 领域 | cs.CL, cs.AI, cs.LG |
二、核心思想
问题定义
混合专家(Mixture of Experts, MoE)模型通过稀疏激活层的条件执行,使得训练具有更多参数的模型成为可能,从而在机器翻译等各种NLP任务上取得了显著更好的质量。然而,由于巨大的内存需求和低效的推理,在实际场景中部署此类模型仍然具有挑战性。
在生产环境中,传统的多语言机器翻译系统通常采用”教师-学生”蒸馏范式:为每个语言对训练、蒸馏和部署单独的小模型。例如,部署100种语言的翻译系统需要至少200个这样的模型,这不仅不可扩展,还阻碍了不同语言对之间的知识共享和迁移。
解决方案概述
本文提出了一种高效的推理框架,包含多种优化方法来加速稀疏模型的计算并大幅减少内存消耗:
- 吞吐量提升:最高26倍速度提升
- 模型压缩:通过将专家权重量化为4-bit整数,模型大小减少到原始32-bit浮点模型的近1/8
- 部署能力:能够部署136倍更大的模型,成本降低27%,质量显著优于现有解决方案
三、技术架构
整体框架图
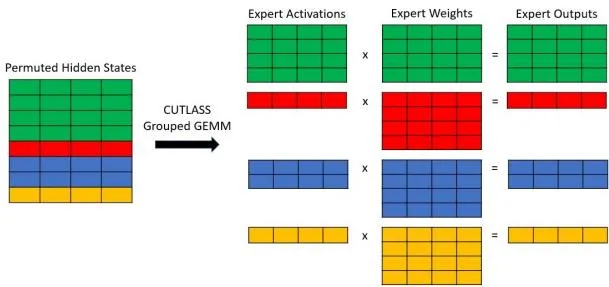
Figure 1: CUTLASS Grouped GEMM执行的计算。每种颜色代表特定专家的子矩阵,每个专家的矩阵乘法并行执行。如果黄色句子已完成,在启用批处理剪枝的情况下将从计算中省略,完全消除加载黄色专家权重矩阵的需要。
模型架构
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 架构类型 | Encoder-Decoder with MoE | 深编码器-浅解码器 |
| 嵌入维度 | Hidden dimension | 1024 |
| FFN维度 | Feed-forward hidden dimension | 4096 |
| 编码器层 | Encoder layers | 24 |
| 解码器层 | Decoder layers (半数于编码器) | 12 |
| 专家数量 | Number of experts | 32 |
| 门控算法 | Gating algorithm | Top-1 (Switch Transformer) |
| 词表大小 | Vocabulary size | 128K (SentencePiece) |
| 总参数量 | Total parameters | ~5B |
| 模型大小 | Model size (FP16) | ~10 GB |
核心公式
专家量化
对称逐通道量化:
对于形状为 的专家权重(E为专家数,M和N为任意维度),生成形状为 的缩放因子。
权重反量化算法 (Algorithm 1):
Input: E - 专家数量
       W - 量化权重, shape (E, M, N)
       S - FP16缩放因子, shape (E, 1, N)
Output: FP16反量化权重

for e = 0 to E-1:
    for m = 0 to M-1:
        for n = 0 to N-1:
            f = IntToFloat(W[e, m, n])
            W_dq[e, m, n] = f * S[e, n]
优化的I2F转换
关键观察:
- 对于任何FP16数 ,当 时,1024精确存储在指数位中, 直接存储在尾数中
- 对于任何整数 ,可以通过设置指数为1024并将Y存储在FP16尾数中来构造 的FP16表示
8-bit优化反量化:
- 加载4个int8值 到单个32位寄存器
- 创建第二个32位寄存器 ,存储 的FP16表示
- 使用浮点数学从 中减去 (1024 + 128 = 1152)
- 对 和 重复步骤2-3
4-bit优化反量化:
重新排列权重布局以减少逻辑指令:
训练流程
- 训练数据:生产规模训练数据,约40亿训练句对
- MoE层配置:每隔一层使用MoE层替代普通前馈层
- 并行策略:使用专家并行(Expert Parallelism)而非张量切片模型并行
工作流程
- Token路由:使用CUB库的GPU友好基数排序实现
- 将行索引附加到门控函数输出的元组
- 使用expert_idx作为键进行排序
- 根据排序结果排列激活矩阵
- 分组GEMM:使用CUTLASS Grouped GEMM并行计算所有专家
- 反排列:将行恢复到原始顺序并应用expert_scale
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| CUTLASS Grouped GEMM | 利用CUTLASS库实现MoE层的高效并行计算 | 支持不同输入类型的GEMM |
| 4/8-bit权重量化 | 仅量化专家权重(>90%模型参数),无需QAT | BLEU损失可忽略(-0.052~0.044) |
| 优化I2F转换 | 用高吞吐量ALU和FP16指令替代原生I2F | INT8提升28%,INT4提升56% |
| 融合GEMM+反量化 | 将反量化步骤融合到GEMM内核中 | 减少内存流量 |
| 批处理剪枝 | 动态移除已完成翻译的句子 | 最高1.14倍加速 |
量化性能对比
| 活跃专家数 | FP16 | INT8 (原生I2F) | INT8 (优化I2F) | INT4 (优化I2F) |
|---|---|---|---|---|
| 1 | 1 | 1.05 | 1.28 | 1.24 |
| 4 | 1 | 1.01 | 1.21 | 1.28 |
| 8 | 1 | 1.34 | 1.21 | 1.57 |
| 16 | 1 | 1.40 | 1.39 | 1.73 |
| 24 | 1 | 1.40 | 1.49 | 1.78 |
| 32 | 1 | 1.46 | 1.59 | 1.85 |
| 几何平均 | 1 | 1.26 | 1.35 | 1.56 |
五、实验结果
基准测试
实验环境:
- 硬件:单个NVIDIA PCIE V100
- 软件:Docker容器(Ubuntu 20.04), CUDA 11.6
- 任务:1000个tokenized英语句子翻译(~40K tokens)
翻译质量影响
INT8/INT4量化BLEU差异:
| 语言对 | INT8 Δ BLEU | INT4 Δ BLEU |
|---|---|---|
| EN-DE (Beam 1) | -0.028 | -0.052 |
| EN-DE (Beam 2) | +0.051 | -0.180 |
| DE-EN (Beam 1) | -0.084 | +0.044 |
| DE-EN (Beam 2) | -0.027 | -0.031 |
| 10语言对平均 (Beam 2) | -0.007 | -0.167 |
结论:量化对翻译质量的影响可忽略不计。
端到端性能
吞吐量对比 (input tokens/sec):
| 批大小 | Torch-FP16 | FT-FP16 | FT-INT8 | FT-INT4 |
|---|---|---|---|---|
| 1 | 16 | 388 | 401 | 400 |
| 8 | 70 | 1,594 | 1,639 | 1,662 |
| 20 | 150 | 3,025 | 3,178 | 3,247 |
| 32 | 214 | 4,008 | 4,264 | 4,379 |
| 64 | 379 | 5,371 | 5,706 | 5,935 |
| 96 | 485 | 6,689 | 7,101 | 7,483 |
关键发现:
- FT-FP16 vs Torch-FP16:14-24倍加速
- FT-INT4 vs Torch-FP16:最高26倍加速
- 批大小96时,FT-INT4达到7,483 tokens/sec
成本效益分析
| 硬件 | 参数量 | 批大小 | 价格(东美) | 延迟(ms) | 吞吐量(words/sec) | 月成本(USD/token) |
|---|---|---|---|---|---|---|
| CPU (AVX512) | 0.04B | 1 | $587.65 | 75 | 351 | 0.209 |
| CPU (AVX512) | 5.32B | 1 | $587.65 | 1,080 | 26 | 22.602 |
| NVIDIA T4 | 5.32B | 20 | $390.55 | 421 | 1,565 | 0.250 |
| NVIDIA T4 | 5.32B | 64 | $390.55 | 824 | 2,560 | 0.153 |
关键发现:
- 在CPU上部署5.32B MoE模型的成本是0.04B模型的108倍
- 优化后的GPU部署成本低于CPU上的小模型部署
- 使用T4 GPU,批大小64时月成本仅0.153 USD/token
六、相关工作
MoE模型训练
- Switch Transformers (Fedus et al., 2021):提出Top-1门控算法
- GShard (Lepikhin et al., 2020):大规模MoE模型的条件计算和自动分片
- ST-MoE (Zoph et al., 2022):设计稳定且可迁移的稀疏专家模型
推理优化
- DeepSpeed-MoE (Rajbhandari et al., 2022):专注于100B+参数模型的多GPU解码
- FasterTransformer:NVIDIA的高效transformer推理引擎
量化技术
- QAT (Wu et al., 2020):量化感知训练(本文未使用,因为权重量化不降低性能)
七、总结
核心贡献
- 高效MoE推理框架:基于FasterTransformer扩展,支持MoE模型架构
- CUTLASS Grouped GEMM集成:高效表达token路由和批处理矩阵乘法
- 4/8-bit权重量化:无需QAT,融合反量化到GEMM内核
- 批处理剪枝:动态移除已完成句子,提高MoE层效率
- 优化I2F转换:用高吞吐量指令替代原生int-to-float转换
技术影响
- 范式转变:用单个大型MoE模型替代数十个小型蒸馏模型
- 成本效益:部署136倍更大模型,成本降低27%
- 质量提升:利用跨语言迁移学习提高翻译质量
- 可扩展性:优化适用于其他架构和任务
局限性
- 单GPU限制:本文聚焦于单GPU推理场景
- 模型规模:主要针对5B参数级别的MoE模型
- 任务范围:主要在机器翻译任务上验证
未来工作
- 改进融合GEMM+反量化内核,支持完全向量化的16字节加载
- 探索分布式推理以部署更大规模模型
八、参考资源
- 论文: arXiv:2211.10017
- PDF: arxiv.org/pdf/2211.10017
- FasterTransformer: NVIDIA FasterTransformer
- CUTLASS: NVIDIA CUTLASS
引用
@article{kim2022elephants,
  title={Who Says Elephants Can't Run: Bringing Large Scale MoE Models into Cloud Scale Production},
  author={Kim, Young Jin and Henry, Rawn and Fahim, Raffy and Awadalla, Hany Hassan},
  journal={arXiv preprint arXiv:2211.10017},
  year={2022}
}