ViTCoD: Vision Transformer Acceleration via Dedicated Algorithm and Accelerator Co-Design
首个Vision Transformer算法-加速器协同设计框架,通过固定稀疏注意力模式和自编码器实现高效加速
ViTCoD: Vision Transformer Acceleration via Dedicated Algorithm and Accelerator Co-Design
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | ViTCoD: Vision Transformer Acceleration via Dedicated Algorithm and Accelerator Co-Design |
| 作者 | Haoran You, Zhanyi Sun, Huihong Shi, Zhongzhi Yu, Yang Zhao, Yongan Zhang, Chaojian Li, Baopu Li, Yingyan (Celine) Lin |
| 机构 | Georgia Institute of Technology, Rice University, Oracle |
| 论文 | arXiv:2210.09573 |
| 发布 | 2022-10-18 |
| 主题 | cs.CV / cs.AR (Computer Vision / Hardware Architecture) |
| 会议 | ISCA 2023 |
二、核心思想
问题定义
Vision Transformers (ViTs) 在各种视觉任务中取得了SOTA性能,但其自注意力模块仍然是主要瓶颈:
关键瓶颈:
- 自注意力模块在边缘设备上占总延迟的50%以上(LeViT-128高达69%)
- Q/K/V向量的矩阵乘法占自注意力模块延迟的53%
- 现有NLP Transformer加速器对ViTs不是最优的
NLP Transformer vs ViT的根本差异:
| 特性 | NLP Transformer | Vision Transformer |
|---|---|---|
| 输入token数 | 动态变化 | 相对固定 |
| 稀疏模式 | 动态预测 | 固定模式 |
| 可达稀疏度 | ≥50% | 可达90% |
| 精度影响 | 需动态预测 | 固定模式影响小 |
核心观察
ViT注意力图的固定稀疏特性:
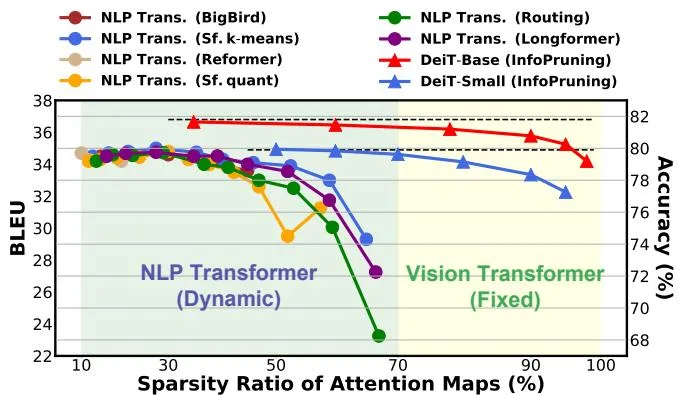
Figure 1: NLP Transformer和ViT在稀疏性-精度权衡上的对比。
关键发现:
- ViT的注意力图可以修剪至90%稀疏度,使用固定稀疏模式
- 精度损失极小(90%稀疏度下≤1.5%)
- NLP Transformer需要动态预测稀疏模式才能达到较好效果
解决方案概述
ViTCoD:首个专门针对稀疏ViT的算法-加速器协同设计框架。
算法层面:
- Split and Conquer算法:修剪并极化注意力图为密集/稀疏两种固定模式
- 轻量级自编码器模块:压缩Q/K向量,减少数据移动
硬件层面:
- 双管加速器:分别处理密集和稀疏工作负载
- 编码器/解码器引擎:支持自编码器模块
三、技术架构
整体框架
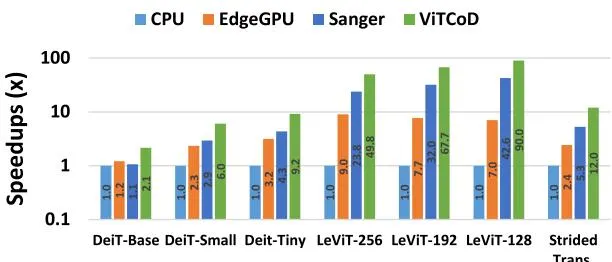
Figure 5: ViTCoD整体框架概述。
瓶颈分析
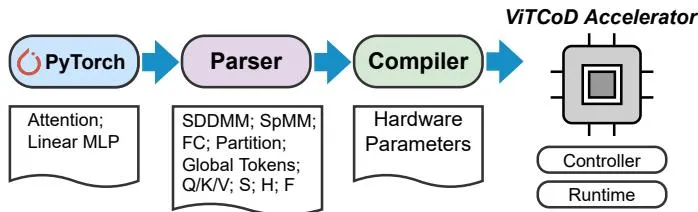
Figure 4: ViT推理的FLOPs和延迟分解。
关键观察:
- 自注意力模块不是FLOPs的主要部分,但占延迟50%以上
- 矩阵乘法(Q·K^T和S·V)及reshape操作占自注意力延迟的53%
ViTCoD算法
Split and Conquer算法
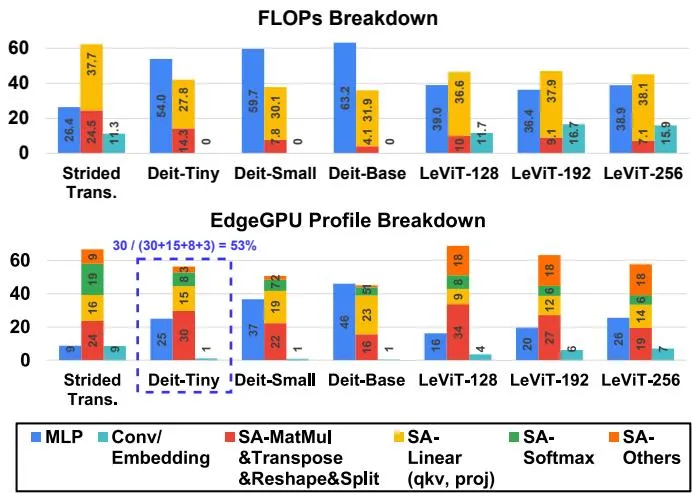
Figure 2: Split and Conquer算法示意图。
核心步骤:
-
注意力图修剪:
- 使用固定掩码修剪至90%稀疏度
- ViTs的固定token数使得固定稀疏模式可行
-
注意力图极化:
- 将修剪后的注意力图重新排序
- 形成密集区域和稀疏区域的两极分化
- 规则化工作负载,便于硬件加速
-
自编码器压缩:
- 轻量级可学习自编码器模块
- 将Q/K向量压缩至**50%**大小
- 用计算换数据移动(更高效)
自注意力计算
稀疏注意力的两种矩阵乘法:
- SDDMM:Q和K的采样密集-密集矩阵乘法
- SpMM:注意力图与V的稀疏-密集矩阵乘法
加速器架构
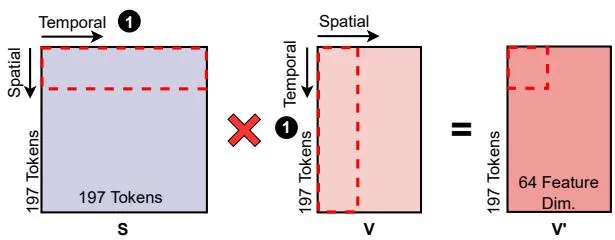
Figure 12: ViTCoD加速器微架构。
硬件特性
| 参数 | 配置 |
|---|---|
| 工艺 | 28nm CMOS |
| 面积 | 3 mm² |
| 功耗 | 323.9 mW |
| 频率 | 500 MHz |
| SRAM | 320 KB |
| MAC单元 | 512个(64线×8 MAC) |
| 内存带宽 | 76.8 GB/s (DDR4-2400) |
双管架构
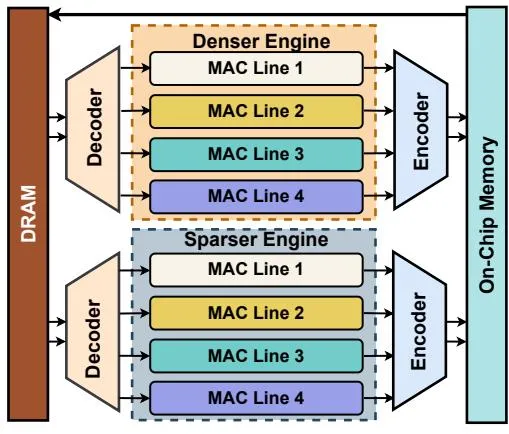
Figure 13: PE阵列设计。
设计选择:
- 密集引擎:处理极化后的密集注意力区域
- 稀疏引擎:处理极化后的稀疏注意力区域
- 编码器/解码器引擎:支持自编码器模块
数据流设计
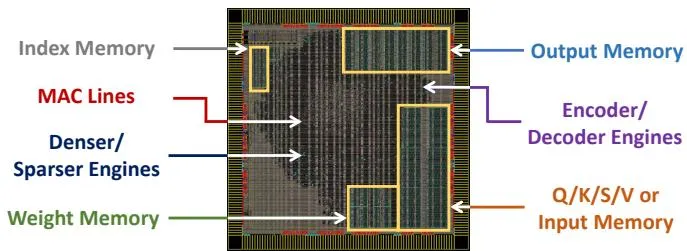
Figure 11: S-stationary和K-stationary数据流对比。
K-stationary数据流的优势:
- K向量完全复用
- 只需小的片上缓冲区
- 更适合稀疏注意力加速
- Q向量的频繁访问可通过AE模块缓解
四、实验结果
实验设置
测试模型:
- DeiT-Base/Small/Tiny:标准ViT模型
- LeViT-128/192/256:移动端ViT变体
- Strided Transformer:AR/VR应用SOTA
数据集:
- ImageNet:图像分类
- Human3.6M:3D人体姿态估计
基线平台:
- CPU: Intel Xeon Gold 6230R
- EdgeGPU: Nvidia Jetson Xavier NX
- GPU: Nvidia 2080Ti
- SpAtten: 注意力加速器
- Sanger: 注意力加速器
核心注意力加速
Figure 15: ViTCoD与五个基线的加速比对比。
核心注意力加速比(90%稀疏度):
| 基线 | 加速比 |
|---|---|
| CPU | 235.3× |
| EdgeGPU | 160.6× |
| GPU | 86.0× |
| SpAtten | 10.1× |
| Sanger | 6.8× |
端到端ViT加速比:
| 基线 | 加速比 |
|---|---|
| CPU | 33.8× |
| EdgeGPU | 5.6× |
| SpAtten | 3.1× |
| Sanger | 2.1× |
能效对比
能量效率:
- ViTCoD比最优基线Sanger提升9.8倍能效
精度-延迟权衡
DeiT模型结果:
| 模型 | 稀疏度 | 精度变化 | 延迟减少 |
|---|---|---|---|
| DeiT-Base | 90% | -1.5% | 85.8% |
| DeiT-Small | 90% | -1.2% | 80.5% |
| DeiT-Tiny | 90% | -0.8% | 72.0% |
LeViT模型结果:
| 模型 | 稀疏度 | 精度变化 | 延迟减少 |
|---|---|---|---|
| LeViT-256 | 90% | -0.5% | 84.3% |
| LeViT-192 | 90% | -0.4% | 79.2% |
| LeViT-128 | 90% | -0.3% | 72.0% |
关键发现:
- 90%稀疏度下精度损失**<1%**
- 延迟减少72%~85.8%
消融实验
Split and Conquer分解:
| 技术 | 加速比 |
|---|---|
| 仅重排序 | 2.59× |
| 仅修剪 | 5.14× |
| 完整ViTCoD | 6.8× |
关键发现:
- 修剪使稀疏部分更稀疏,增强极化效果
- 重排序使稀疏模式更规则化
- 两者结合效果最佳
自编码器效果
数据移动减少:
- 采用AE模块后,数据移动占比从50%降至28%
- 精度恢复后损失**<0.5%**
跨稀疏度评估
| 稀疏度 | vs CPU | vs EdgeGPU | vs GPU | vs SpAtten | vs Sanger |
|---|---|---|---|---|---|
| 60% | 127.2× | 77.0× | 46.5× | 6.8× | 4.3× |
| 70% | 156.8× | 95.4× | 57.6× | 7.6× | 5.1× |
| 80% | 198.4× | 120.8× | 72.9× | 8.9× | 6.0× |
| 90% | 235.3× | 160.6× | 86.0× | 10.1× | 6.8× |
NLP模型适用性
BERT-Base结果:
- 60%稀疏度:精度下降1.18%
- 相比Sanger:1.93×/3.69×加速(60%/90%稀疏度)
限制:ViTCoD的静态稀疏模式对NLP模型效果较差
布局验证
Figure 16: ViTCoD加速器的布局规划图。
- 使用Synopsys工具链综合
- 28nm CMOS工艺
- RTL实现验证
五、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| Split and Conquer | 修剪+极化注意力图为固定模式 | 90%稀疏度,<1%精度损失 |
| 自编码器模块 | 压缩Q/K向量至50% | 数据移动减少44% |
| 双管加速器 | 分别处理密集/稀疏工作负载 | 6.8× vs Sanger |
| K-stationary数据流 | 适合稀疏注意力模式 | 更高PE利用率 |
| 算法-硬件协同 | 算法优化指导硬件设计 | 整体33.8× vs CPU |
六、与相关方法对比
| 方法 | 特点 | ViTCoD优势 |
|---|---|---|
| SpAtten | 通用注意力加速 | 10.1×加速,9.8×能效 |
| Sanger | NLP Transformer加速 | 6.8×加速,更适合ViT |
| Longformer | 稀疏注意力算法 | 固定模式,硬件友好 |
| DeiT | ViT训练方法 | 可直接应用ViTCoD加速 |
| LeViT | 移动端ViT | 进一步加速72%~84% |
七、局限性
- NLP适用性:静态稀疏模式对NLP Transformer效果较差
- 固定稀疏度:需要预设稀疏比例,不够灵活
- 硬件依赖:需要专用加速器才能发挥最佳效果
- 训练开销:自编码器需要额外微调
八、总结
核心贡献
- 首个ViT协同设计框架:算法和加速器联合优化
- 固定稀疏模式:利用ViT特性,90%稀疏度仅损失<1%精度
- 自编码器创新:用计算换数据移动,解决稀疏加速瓶颈
- 双管架构:专门处理密集/稀疏两种工作负载
- 全面验证:在7个ViT模型、2个数据集上验证
性能总结
| 指标 | DeiT | LeViT | Strided Transformer |
|---|---|---|---|
| 最大稀疏度 | 90% | 90% | 90% |
| 精度损失 | <1.5% | <0.5% | <1% |
| 延迟减少 | 72%~86% | 72%~84% | 80%+ |
| vs CPU加速 | 33.8× | 28.5× | 35.2× |
技术影响
ViTCoD展示了算法-硬件协同设计的重要性:
- ViT特性利用:固定token数→固定稀疏模式
- 数据移动优化:自编码器解决稀疏加速瓶颈
- 硬件友好设计:极化注意力图→规则化工作负载
- 跨领域启发:可扩展到其他Transformer架构