Flow Matching for Generative Modeling
无仿真训练连续归一化流(CNF)的新范式:通过回归条件概率路径的向量场,统一并超越扩散模型,并引入最优传输(OT)路径
Flow Matching for Generative Modeling:无仿真训练 CNF 的生成建模新范式
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Flow Matching for Generative Modeling |
| 作者 | Yaron Lipman, Ricky T. Q. Chen, Heli Ben-Hamu, Maximilian Nickel, Matt Le |
| 机构 | Meta AI (FAIR)、Weizmann Institute of Science |
| 论文 | https://arxiv.org/abs/2210.02747 |
| 代码 | https://github.com/facebookresearch/flow_matching(官方库,后续开源) |
| 发布 | 2022-10-06(v1),2023-02-08(v2,ICLR 2023) |
| 主题 | Machine Learning (cs.LG); Artificial Intelligence (cs.AI); stat.ML |
Flow Matching (FM) 是继 DDPM、Score-based SDE 之后生成建模领域最重要的奠基性工作之一。它把”扩散过程”从生成建模中彻底抽离,直接以概率路径 + 向量场回归为核心,成为 Stable Diffusion 3、Flux、Meta Movie Gen 等现代大规模生成模型的理论基石。
二、核心思想
问题定义
连续归一化流(Continuous Normalizing Flow, CNF) 用一个由神经网络参数化的时变向量场 通过 ODE 定义流映射 ,从而将简单先验 (如标准高斯噪声)推送为复杂数据分布 。CNF 理论上能建模任意概率路径(包含扩散所能表达的路径),但其传统训练依赖:
- 最大似然训练:需要昂贵的 ODE 数值仿真(前向 + 反向),因 ODE 求解的串行特性导致时间复杂度极高,难以扩展到高维图像;
- 已有 simulation-free 方法:要么涉及难以估计的积分(Rozen et al. 2021),要么在 minibatch 下梯度有偏(Ben-Hamu et al. 2022)。
因此,除扩散(可用去噪分数匹配高效训练)外,没有可扩展的 CNF 训练算法。
解决方案概述
论文提出 Flow Matching (FM):一个 simulation-free(无仿真) 的 CNF 训练目标——直接回归一个能生成目标概率路径的固定向量场,无需在训练中求解 ODE。
三个关键洞察层层递进:
- 边缘向量场可由条件向量场”边缘化”构造(Theorem 1)——把难以处理的边缘 VF 分解为仅依赖单个样本 的简单条件 VF;
- Conditional Flow Matching (CFM) 与 FM 具有相同的梯度(Theorem 2)——从而可以只用逐样本的条件目标进行无偏训练,完全不需要访问难解的边缘概率路径或边缘向量场;
- 一般化的高斯条件概率路径族(Theorem 3)——既能复现已有的 VE/VP 扩散路径,又能引入全新的最优传输(OT)路径,后者轨迹为直线、训练更快、采样更高效、泛化更好。
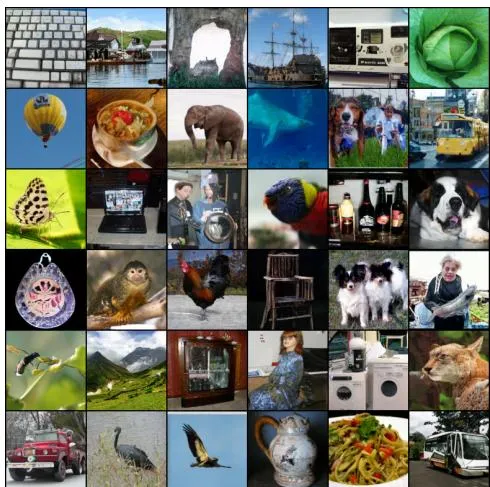
Figure 1:使用 Flow Matching + OT 概率路径训练的 CNF 在 ImageNet-128 上的无条件采样结果。
三、技术架构
3.1 预备知识:CNF
数据空间 。两个核心对象:
- 概率密度路径 ,满足 ;
- 时变向量场 。
向量场 通过 ODE 构造流映射 :
\frac{d}{dt}\phi_t(x)=v_t(\phi_t(x)),\qquad \phi_0(x)=x \tag{1,2}
CNF 用神经网络 建模向量场,通过 push-forward 将先验 变换为 :
p_t=[\phi_t]_*p_0,\qquad [\phi_t]_*p_0(x)=p_0(\phi_t^{-1}(x))\det\left[\frac{\partial\phi_t^{-1}}{\partial x}(x)\right] \tag{3,4}
若 满足式(3),则称 生成 概率路径 。判定方法是连续性方程(continuity equation)。
3.2 Flow Matching 目标
给定目标概率路径 与生成它的向量场 ,定义 FM 目标为回归损失:
\mathcal{L}_{\mathrm{FM}}(\theta)=\mathbb{E}_{t,p_t(x)}\|v_t(x)-u_t(x)\|^2 \tag{5}
其中 ,。问题: 和 都是未知的(没有闭式解),因此 FM 目标本身不可直接优化。
3.3 从条件路径构造边缘路径与向量场
给定单个数据样本 ,定义条件概率路径 ,满足边界条件 (先验噪声)、(集中在 附近)。对 边缘化得到边缘概率路径:
p_t(x)=\int p_t(x|x_1)q(x_1)dx_1 \tag{6}
p_1(x)=\int p_1(x|x_1)q(x_1)dx_1\approx q(x) \tag{7}
关键洞察 1:边缘向量场可通过对条件向量场加权”边缘化”得到:
u_t(x)=\int u_t(x|x_1)\frac{p_t(x|x_1)q(x_1)}{p_t(x)}dx_1 \tag{8}
Theorem 1:给定生成条件路径 的条件向量场 ,则式(8)定义的边缘向量场 生成式(6)的边缘概率路径 (二者满足连续性方程)。
3.4 Conditional Flow Matching (CFM)
式(6)(8)含难解积分,无法直接计算 。论文提出更简单的 CFM 目标:
\mathcal{L}_{\mathrm{CFM}}(\theta)=\mathbb{E}_{t,q(x_1),p_t(x|x_1)}\big\|v_t(x)-u_t(x|x_1)\big\|^2 \tag{9}
其中 ,,。与 FM 不同,CFM 只要能从 采样、计算 (均为逐样本、易处理)即可获得无偏估计。
关键洞察 2 / Theorem 2:在 假设下, 与 相差一个与 无关的常数,因此 。
这意味着:优化逐样本的 CFM,等价于优化难解的 FM——无需访问边缘路径或边缘向量场,只需设计合适的条件路径与条件向量场。这与去噪分数匹配(denoising score matching)的思想相通,但 FM 直接匹配向量场而非分数。
3.5 高斯条件概率路径族
考虑一般形式的高斯条件路径:
p_t(x|x_1)=\mathcal{N}(x\mid\mu_t(x_1),\sigma_t(x_1)^2 I) \tag{10}
边界条件:(→ 标准高斯噪声);(→ 集中于 )。
选择最简单的正则(仿射)流:
\psi_t(x)=\sigma_t(x_1)x+\mu_t(x_1) \tag{11}
它把噪声 推送到 。将 代入 CFM 损失得到可直接优化的形式:
\mathcal{L}_{\mathrm{CFM}}(\theta)=\mathbb{E}_{t,q(x_1),p(x_0)}\left\|v_t(\psi_t(x_0))-\frac{d}{dt}\psi_t(x_0)\right\|^2 \tag{14}
Theorem 3:对式(10)的高斯路径及式(11)的流映射,唯一对应的条件向量场为:
u_t(x|x_1)=\frac{\sigma_t'(x_1)}{\sigma_t(x_1)}\big(x-\mu_t(x_1)\big)+\mu_t'(x_1) \tag{15}
3.6 两种特例路径
Example I — 扩散条件向量场(复现已有扩散模型):
-
VE(Variance Exploding) 路径 ,得 u_t(x|x_1)=-\frac{\sigma_{1-t}'}{\sigma_{1-t}}(x-x_1) \tag{17}
-
VP(Variance Preserving) 路径 ,其中 ,得 u_t(x|x_1)=-\frac{T'(1-t)}{2}\left[\frac{e^{-T(1-t)}x-e^{-\frac{1}{2}T(1-t)}x_1}{1-e^{-T(1-t)}}\right] \tag{19}
该条件 VF 恰好与 Song et al.(2020b) 的 probability-flow ODE 一致,但配合 FM 目标训练更稳定鲁棒。注意:扩散路径在有限时间内并不能真正到达噪声分布,实践中只能用高斯近似 ;而 FM 可直接设定 ,完全掌控路径。
Example II — 最优传输(OT)条件向量场(本文提出的新路径):
令均值与标准差随时间线性变化:
\mu_t(x)=tx_1,\qquad \sigma_t(x)=1-(1-\sigma_{\min})t \tag{20}
对应向量场(对所有 有定义):
u_t(x|x_1)=\frac{x_1-(1-\sigma_{\min})x}{1-(1-\sigma_{\min})t} \tag{21}
条件流:
\psi_t(x)=(1-(1-\sigma_{\min})t)x+tx_1 \tag{22}
CFM 损失变为极其简洁的形式:
\mathcal{L}_{\mathrm{CFM}}(\theta)=\mathbb{E}_{t,q(x_1),p(x_0)}\big\|v_t(\psi_t(x_0))-\big(x_1-(1-\sigma_{\min})x_0\big)\big\|^2 \tag{23}
该 正是两个高斯 之间的 OT 位移映射(McCann 1997),粒子沿直线、匀速运动:
p_t=[(1-t)\mathrm{id}+t\psi]_\star p_0 \tag{24}
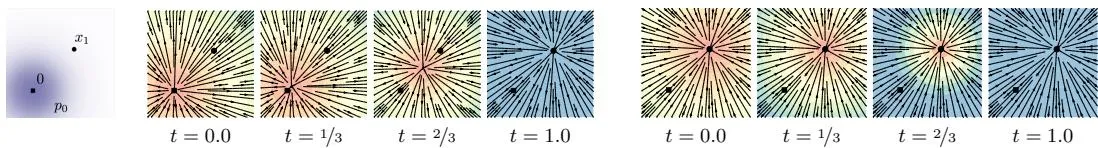
Figure 2:OT 路径的条件向量场方向随时间恒定(可写为 ),比扩散路径的条件分数函数更易被参数模型拟合。
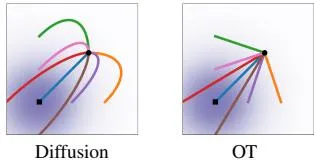
Figure 3:扩散路径采样轨迹会”过冲(overshoot)“最终样本导致回溯,而 OT 路径保持直线。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Flow Matching 目标 | 直接回归生成目标概率路径的向量场,无仿真训练 CNF | 式(5);打破扩散之外无可扩展 CNF 训练的壁垒 |
| 边缘化定理 | 边缘 VF = 条件 VF 加权积分,可分解难解的边缘目标 | Theorem 1(连续性方程证明) |
| CFM 梯度等价 | 逐样本 CFM 与 FM 梯度相同,无需访问边缘量 | Theorem 2 |
| 统一高斯路径族 | VE/VP 扩散路径均为特例,可直接设定 | Theorem 3,式(15) |
| OT 直线路径 | 线性插值 = 两高斯间 OT 位移映射,直线匀速轨迹 | McCann(1997),式(20)-(24) |
| 脱离扩散推理 | 直接以概率路径为一等对象,不再需要构造 SDE | Example II |
五、代码实现分析
FM/CFM 的训练循环极其简洁(以 OT 路径为例,式(23)):
# 训练一步(伪代码)
x1 ~ q(x1)                       # 采样数据
x0 ~ N(0, I)                     # 采样噪声先验
t  ~ U[0, 1]                     # 采样时间
# OT 条件流:直线插值
xt = (1 - (1 - sigma_min) * t) * x0 + t * x1     # psi_t(x0),式(22)
# 回归目标(与 t 无关的常向量)
target = x1 - (1 - sigma_min) * x0               # 式(23)
loss = || v_theta(xt, t) - target ||^2
loss.backward()- 网络架构:直接复用 Dhariwal & Nichol (2021) 的 U-Net(ADM),几乎无改动,仅将输出解释为向量场 ;
- 采样:从 出发,用现成 ODE 求解器(如
dopri5)积分式(1)得到 ; - 无需噪声调度调参、无需 SDE 离散化、采样成本训练期间恒定。
六、实验结果
数据集:CIFAR-10、ImageNet 32/64/128。评估用 dopri5 自适应求解器(绝对/相对容差 1e-5)。
6.1 密度建模与样本质量(Table 1 左)
同一 U-Net 架构、相同超参与迭代数下,对比不同训练损失(NLL 单位 BPD↓,FID↓,NFE↓):
| 模型 | CIFAR-10 NLL | CIFAR-10 FID | CIFAR-10 NFE | IN-32 NLL | IN-32 FID | IN-64 NLL | IN-64 FID | IN-64 NFE |
|---|---|---|---|---|---|---|---|---|
| DDPM | 3.12 | 7.48 | 274 | 3.54 | 6.99 | 3.32 | 17.36 | 264 |
| Score Matching | 3.16 | 19.94 | 242 | 3.56 | 5.68 | 3.40 | 19.74 | 441 |
| ScoreFlow | 3.09 | 20.78 | 428 | 3.55 | 14.14 | 3.36 | 24.95 | 601 |
| FM w/ Diffusion | 3.10 | 8.06 | 183 | 3.54 | 6.37 | 3.33 | 16.88 | 187 |
| FM w/ OT | 2.99 | 6.35 | 142 | 3.53 | 5.02 | 3.31 | 14.45 | 138 |
FM-OT 在所有指标上全面领先:NLL、FID 最优,且 NFE(采样函数评估次数)最少。即使在同一扩散路径上,FM 训练也优于 Score Matching。
6.2 ImageNet 128×128(Table 1 右)
| 模型 | NLL | FID |
|---|---|---|
| Uncond. BigGAN | - | 25.3 |
| PGMGAN | - | 21.7 |
| FM w/ OT | 2.90 | 20.9 |
在无条件 128×128 上取得 SOTA 级 FID(除使用自监督条件的 IC-GAN 外)。
6.3 更快训练与更高效采样
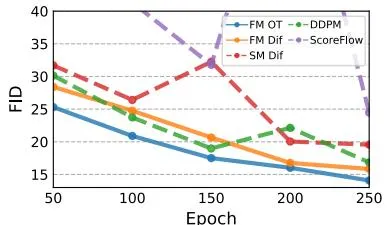
Figure 5:ImageNet 64×64 训练过程中的图像质量。FM-OT 比所有基线更快、更大幅度地降低 FID。
- 收敛更快:ImageNet-128 上,Dhariwal & Nichol 训练 4.36M 迭代(batch 256),而 FM(模型大 25%)仅用 500k 迭代(batch 1.5k),图像吞吐量少 33%;
- 采样成本恒定:分数匹配的采样成本在训练中会剧烈变化,FM 训练时采样成本保持不变。
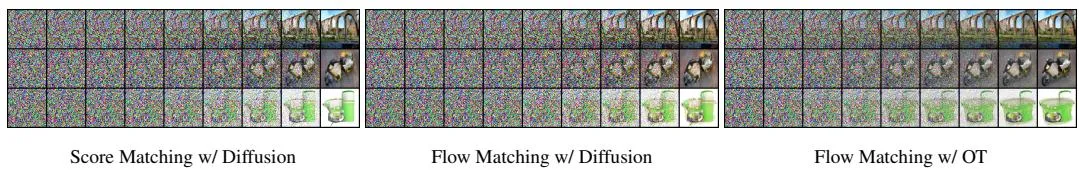
Figure 6:相同初始噪声下的采样路径。OT 路径近似线性地去噪,扩散路径则在末端才显著去噪。
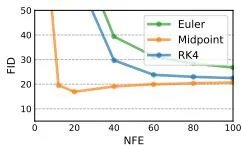
Figure 7:Flow Matching(尤其 OT 路径)允许用更少的函数评估次数(NFE)获得低误差解——采样更快更可靠。
6.4 低维可视化(2D checkerboard)
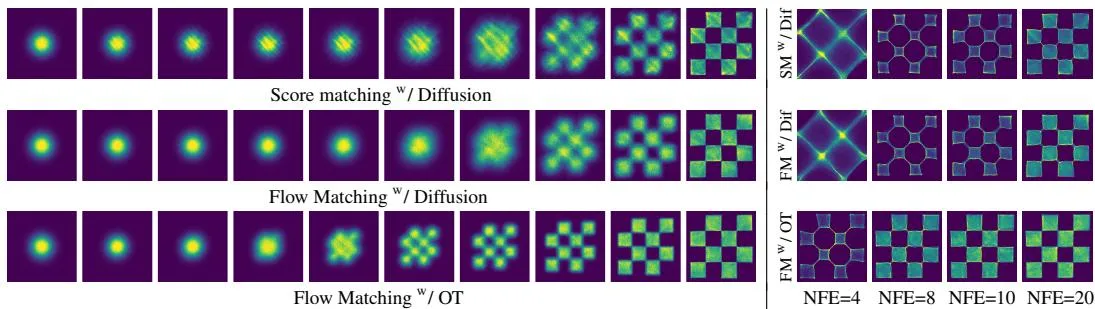
Figure 4:(左)不同目标训练的 CNF 在 2D 棋盘数据上的轨迹,OT 路径更早形成棋盘图案且训练更稳定;(右)FM+OT 用中点法可高效采样。
七、相关工作
- CNF(Chen et al. 2018):连续时间归一化流,原用最大似然训练但需昂贵 ODE 仿真,难扩展到高维;后续工作多为正则化 ODE(augmentation、正则项、随机积分区间),未改变根本训练算法。
- Simulation-free CNF:Rozen et al.(2021) 积分难估计;Ben-Hamu et al.(2022) minibatch 梯度有偏——FM 兼具无偏梯度与高维可扩展性。
- 扩散模型(Sohl-Dickstein 2015;Ho 2020;Song 2020b/2021):通过构造扩散过程间接定义概率路径,用去噪分数匹配训练。CFM 受此启发但直接匹配向量场,且不受限于单参数扩散路径。
- 并发工作:Liu et al.(2022, Rectified Flow)、Albergo & Vanden-Eijnden(2022, Stochastic Interpolants) 得到类似的条件目标;Neklyudov et al.(2023) 在 为梯度场时导出隐式目标。
八、总结
核心贡献
- 提出 Flow Matching (FM):无仿真、可扩展地训练 CNF 的回归目标,突破扩散之外无高效 CNF 训练算法的壁垒;
- 提出 Conditional Flow Matching (CFM):证明逐样本条件目标与 FM 梯度等价(Theorem 2),使训练无需访问难解的边缘量;
- 建立统一的高斯条件概率路径族(Theorem 3),将 VE/VP 扩散路径纳为特例,并证明扩散路径上 FM 训练比分数匹配更稳定;
- 引入 Optimal Transport (OT) 路径:直线匀速轨迹,训练更快、采样 NFE 更低、泛化更好,在 ImageNet 上全面超越扩散基线。
技术影响
Flow Matching 把”扩散过程”从生成建模中剥离,确立了 “概率路径 + 向量场回归” 的新范式。它直接催生并支撑了 Rectified Flow、Stochastic Interpolants,以及 Stable Diffusion 3、Flux、Meta Movie Gen、Qwen-Image 等一系列基于 flow-matching / rectified-flow 的现代大规模生成模型,成为当前主流图像/视频生成的理论核心。
局限性
- 虽然条件流是最优传输,但边缘向量场并非 OT 解(只是期望其相对简单);
- 高斯路径族的选择仍需人工设计边界条件;
- 论文主要在无条件 ImageNet 上验证,大规模文本条件生成的潜力在后续工作中才充分展开。
九、参考资源
- 论文:https://arxiv.org/abs/2210.02747
- 官方代码:https://github.com/facebookresearch/flow_matching
- 相关:Rectified Flow (Liu et al. 2022)、Stochastic Interpolants (Albergo & Vanden-Eijnden 2022)、Neural ODE / CNF (Chen et al. 2018)