Mimose: An Input-Aware Checkpointing Planner for Efficient Training on GPU
Mimose - 输入感知型张量检查点规划器,用于GPU高效训练
Mimose: An Input-Aware Checkpointing Planner for Efficient Training on GPU
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Mimose: An Input-Aware Checkpointing Planner for Efficient Training on GPU |
| 作者 | Jianjin Liao, Mingzhen Li, Qingxiao Sun, Jiwei Hao, Fengwei Yu, Shengdong Chen, Ye Tao, Zicheng Zhang, Hailong Yang, Zhongzhi Luan, Depei Qian |
| 机构 | 北京航空航天大学 (Beihang University), 商汤科技 (SenseTime Research) |
| 论文 | https://arxiv.org/abs/2209.02478 |
| 代码 | 未公开 |
| 发布日期 | 2022年9月6日 |
| 许可 | arXiv非独占分发许可 |
| 领域 | 分布式、并行与集群计算 (cs.DC) |
二、核心思想
问题定义
在深度学习训练中,GPU显存消耗主要来源于激活张量(activation tensors)。尽管张量检查点(checkpointing)技术已被提出以在受限的GPU显存预算下实现训练,但输入张量的动态变化特性尚未被利用来优化性能。具体而言:
- 输入张量动态性:由于数据集多样性和数据增强操作,每个mini-batch的输入张量大小在训练过程中是动态变化的,导致GPU显存占用不断变化。
- 现有方法的不足:静态检查点规划器(如Sublinear、Checkmate)保守地针对最大输入尺寸生成计划,对小输入造成大量冗余计算;动态规划器(如DTR)则在遇到相同输入时重复生成计划,带来显著开销。
核心挑战:
- 挑战1:由于输入张量的动态性,检查点规划需要在运行时(runtime)确定。
- 挑战2:检查点规划需要动态应用于训练过程,而不会显著降低性能。
解决方案概述
Mimose 是一个输入感知的张量检查点规划器,它根据预测的当前输入张量的GPU内存使用动态调整检查点计划,以最大化GPU内存利用率并最小化性能开销。
三个核心组件:
- 穿梭在线采集器(Shuttling Online Collector):在线收集每层GPU内存使用和正向传播时间,无需预先分析模型结构。
- 闪电内存估计器(Lightning Memory Estimator):基于采集数据构建轻量级预测模型,对任意输入张量大小进行亚毫秒级内存预测(二次多项式回归)。
- 响应式内存调度器(Responsive Memory Scheduler):基于预估内存消耗探索近优检查点计划,并使用缓存策略避免对重复输入尺寸重复生成计划。
整个训练流程分为两个阶段:
- 防护执行(Sheltered Execution):前10-30次迭代用于采集内存数据,构建预测模型。
- 响应执行(Responsive Execution):基于预测模型动态生成和切换检查点计划。
三、技术架构
整体框架
┌─────────────────────────────────────────────────────────────┐
│                       Mimose 框架                            │
├──────────────────┬──────────────────┬───────────────────────┤
│  Shuttle Online  │  Lightning       │  Responsive Memory    │
│     Collector    │  Memory Estimator│     Scheduler         │
├──────────────────┼──────────────────┼───────────────────────┤
│ • 每块双向前向    │ • 二次多项式回归   │ • 贪心调度算法        │
│ • 在线无先验知识  │ • 亚毫秒级预测    │ • 输入缓存策略        │
│ • 数据过滤机制    │ • <1ms训练/预测   │ • 按层时间戳排序      │
├──────────────────┴──────────────────┴───────────────────────┤
│  阶段1: Sheltered Execution (10-30 iter) → 阶段2: Responsive Execution  │
└─────────────────────────────────────────────────────────────┘
训练流程
Mimose将训练分为两个阶段:
阶段1:防护执行(Sheltered Execution)
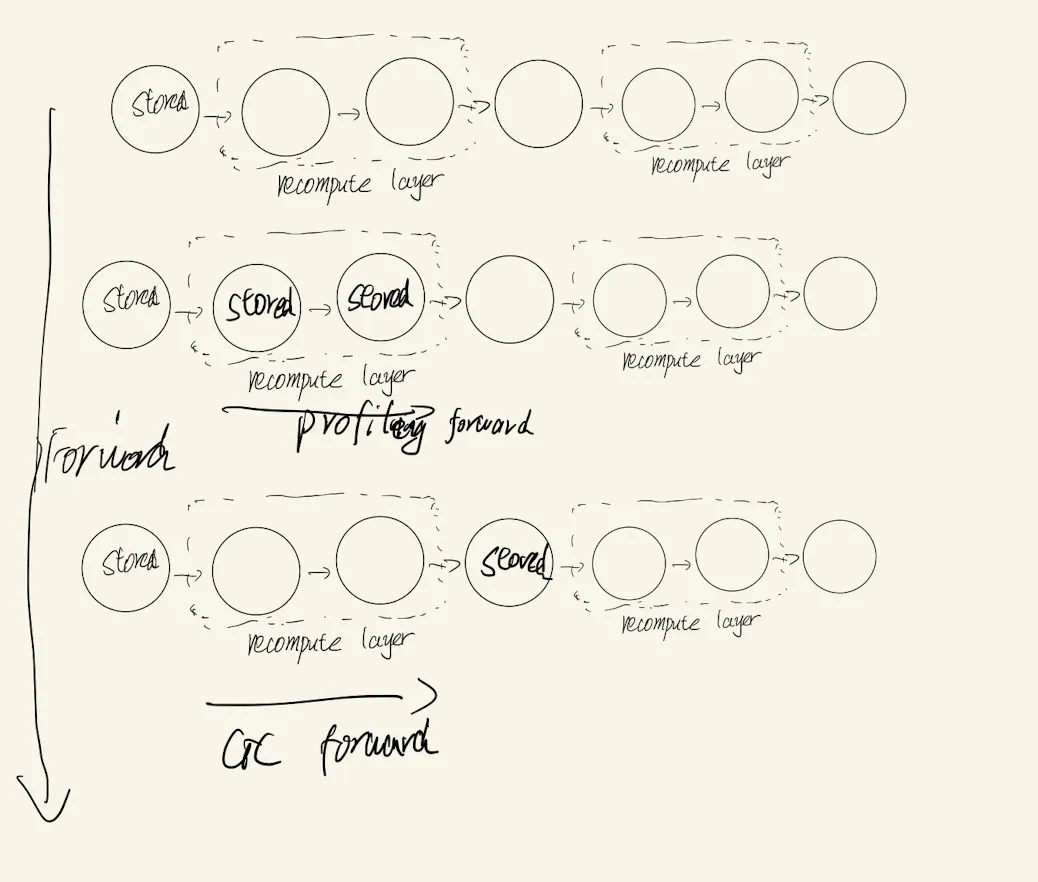
在防护执行阶段,Mimose使用穿梭在线采集器,将DL模型拆分为一系列构建模块序列(如encoder块、attention块),在每个训练迭代中对每个块执行两次前向传播:
第一次前向:正常执行,丢弃输出张量和激活张量
第二次前向:反转操作,立即丢弃所有激活张量,仅检查点保留输出张量
目的:最小化内存使用,准备下一块的内存数据采集- 块间激活张量保留在GPU内存中(与Sublinear规划器一致)
- 此阶段仅需10-30次迭代
- 总时间开销上限为正常训练的2倍(因为多了一次前向)
阶段2:响应执行(Responsive Execution)
- 将增强后的输入张量传递给响应式内存调度器
- 如果缓存中存在相似输入尺寸的已生成计划,直接读取(缓存命中)
- 如果缓存未命中,调度器结合内存估计器在<1ms内推导出近优检查点计划
- 在线采集器冻结,不再需要额外信息
核心公式
输入-激活张量相关性模型(二次多项式回归):
其中:
- :第 层的激活内存使用,给定输入大小
- :通过采集数据拟合得到的多项式系数
该模型基于以下理论发现:
- 激活张量的大小几乎总是与输入张量大小呈多项式相关
- 大多数情况下最高为二次方关系
- 每个算子的输入大小与mini-batch输入张量大小成线性相关
不同算子类别的输入-输出张量关系:
-
元素级算子(Elementwise):如ReLU、add
-
固定输出大小算子(Fixed-output-sized):如AdaptiveAvgPool
-
隐式约简算子:如Linear、GEMM、Convolution、maxPool (线性相关,其中 由stride、kernel_size、padding等固定参数决定)
-
注意力机制(典型结构):
- Q、K、V形状:,其中
- Matmul后: 产生 张量
- 内存增长:
- Scale + Softmax后又产生两个 中间张量
- 最终输出:
贪心调度算法伪代码:
输入: 内存预算 M, 输入张量大小 x, 层集合 L
输出: 需丢弃/重计算的层集合 L'

步骤1: est_mem ← MemoryEstimator(x)          // 预估每层内存
步骤2: 将层按激活张量大小降序排序
步骤3: 将大小相近(±10%误差)的层分到同一个桶中
步骤4: 每个桶内按前向时间戳升序排序
步骤5: excess_mem ← (Σest_mem - M)           // 超出内存预算的部分
步骤6: while excess_mem > 0:
  - 若某层的最大内存仍小于 excess_mem:
    选择激活最大的层
  - 否则:
    选择最接近 excess_mem 的层
  - L'.append(l), excess_mem -= est_mem[l]
- 优先选择前向时间较早的层(减少峰值内存)检查点策略的关键观察:
- 在前向传播中更早执行的层,其激活在反向传播结束时才恢复,此时大多数其他层的激活已释放
- 因此,在大小相近的层之间,优先选择前向传播中靠前的层进行检查点操作,以最小化峰值内存
内存预测模型评估
评估了六种回归模型作为候选:
| 回归模型 | 样本数 | 训练时间 (ms) | 预测延迟 (μs) | 错误率 |
|---|---|---|---|---|
| 多项式(n=1) | 10 | 0.90 | 14.78 | 4.04% |
| 多项式(n=2) | 10 | 0.98 | 16.21 | 0.32% |
| 多项式(n=3) | 10 | 1.01 | 17.88 | 0.32% |
| SVR | 10 | 1.01 | 107.05 | 3.80% |
| SVR | 50 | 2.70 | 110.39 | 3.56% |
| DecisionTree | 10 | 3.98 | 82.97 | 5.67% |
| DecisionTree | 50 | 21.15 | 82.25 | 1.50% |
| XGBoost | 10 | 428.76 | 1348.26 | 5.13% |
| XGBoost | 50 | 2504.11 | 1354.93 | 1.43% |
结论:二次多项式回归模型以最低的训练/预测开销实现了千分之一的预测错误率,是最优选择。
四个任务上二次多项式模型的预测精度:
| 任务 | 样本数 | 训练时间 (ms) | 预测延迟 (μs) | 错误率 |
|---|---|---|---|---|
| MC-Roberta | 10 | 0.94 | 15.50 | 0.46% |
| QA-XLNet | 10 | 1.02 | 16.93 | 0.33% |
| QA-Bert | 10 | 1.18 | 16.45 | 0.33% |
| TC-Bert | 10 | 0.98 | 16.21 | 0.32% |
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 穿梭在线采集器 | 每块双向前向传播,收集内存和时间数据 | 每块2次前向,块间保留激活 |
| 数据过滤器 | 过滤无效数据(三层判断规则) | 检查点层及其父子层的数据排除 |
| 内存估计器 | 二次多项式回归模型 | n=2, 10个样本, 0.98ms训练 |
| 内存调度器 | 贪心算法生成检查点计划 | ±10%容差桶,按前向时间排序 |
| 缓存管理器 | 缓存已生成的检查点计划 | 以输入大小为键索引 |
数据过滤机制
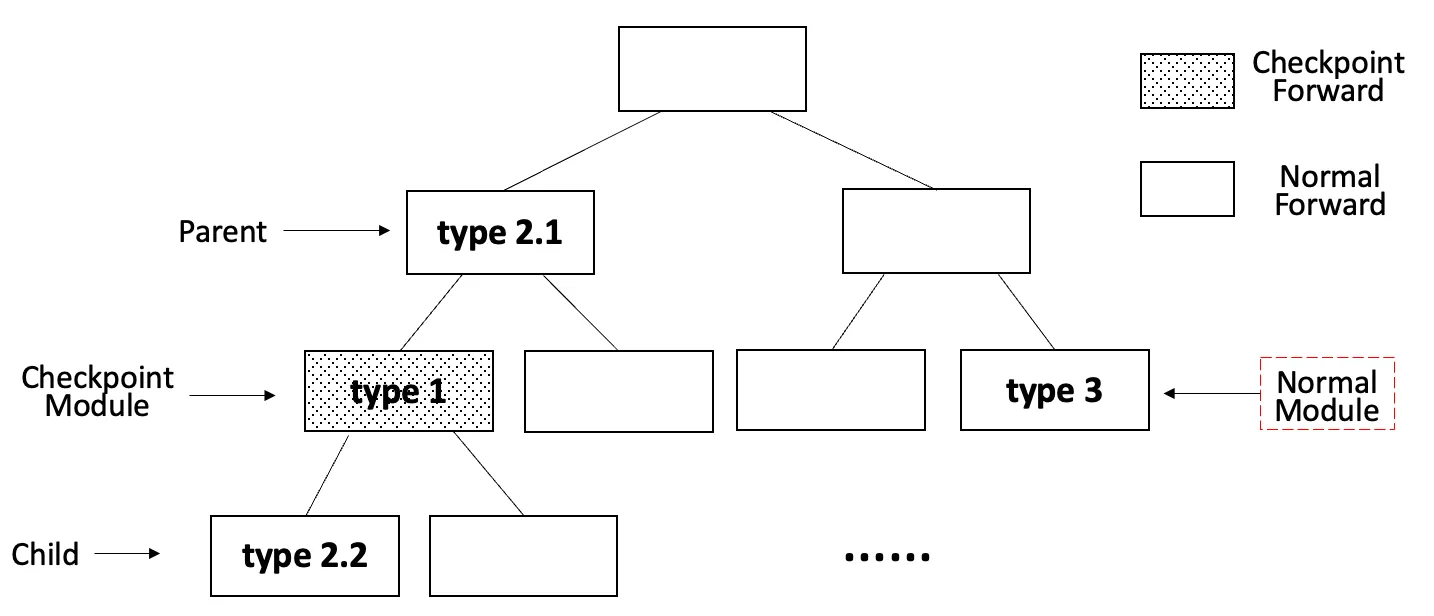
PyTorch的eager模式下没有计算图,数据无法区分当前层是在torch.no_grad()上下文中运行还是正常前向。因此设计了三层数据过滤规则:
- 当前层被检查点:数据应被移除(不存在激活张量)
- 当前层未被检查点,但父层或子层被检查点:数据应被移除
- 以上都不是:数据有效
内存预测模型
不同层/结构的输出张量大小与输入张量大小的关系,涵盖elementwise、fixed-output、implicit-reduction和typical-structure四类典型模式。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 在线GPU内存估计器 | 在模型训练中在线构建内存使用预测模型,无需任何先验知识 | 10次迭代即可达到千分之一级的预测误差 |
| 输入感知的检查点调度 | 根据输入的实时内存预测动态调整检查点计划 | 相比Sublinear提升约17.1%,相比DTR提升约15.0% |
| 缓存策略 | 对相同/相似输入尺寸复用已生成的检查点计划 | 避免了DTR对重复输入尺寸重复规划的开销 |
| 基于前向时间的层选择 | 在大小相近的层中优先选择前向传播中靠前的层 | 减少反向传播期间的峰值内存(如图layer-selection-impact所示) |
| 轻量级多项式回归 | 采用二次多项式而非复杂的XGBoost等模型 | 预测延迟<17μs vs XGBoost的>1300μs,误差相当 |
五、代码实现分析
实现基础
Mimose基于PyTorch的检查点API(torch.utils.checkpoint,自v0.4.0起提供)开发,因此兼容广泛使用PyTorch编写的训练代码。虽然这使得无法实现张级(tensor-level)的内存规划,但在动态输入场景下带来了显著的性能优势。
实现细节
- 采集阶段:包裹每个层的前向传播,比较状态差异来推导内存使用和计算时间
- 响应执行:内存调度器持有缓存存储已生成的检查点计划,以输入张量大小作为索引键
- 快速切换:在前向传播中查找当前层ID是否存在于之前生成的检查点计划中,开销可忽略不计
- RNG状态管理:确保每次迭代的输出与正常前向执行一致(保存和恢复随机数生成器状态)
支持的模型类型
- NLP模型(Bert-base, Roberta-Base, XLNet):完全支持,110-125M参数
- CV模型(ResNet, Swin-Transformer):部分支持,stage边界处有step-down效果
- 两阶段目标检测模型:暂不支持(anchor/proposal数量不可预测),留作未来工作
六、实验结果
实验设置
- 硬件:双路Intel Xeon E5-2680v4 CPU (28核), 双NVIDIA V100 GPU
- 软件:Ubuntu 20.04 LTS, CUDA 11.3, cuDNN v8.2.0, PyTorch v1.11, HuggingFace transformers v4.18.0
- 对比方法:Sublinear(静态规划器)、DTR(动态规划器)、Baseline(无检查点的原始PyTorch)
基准测试任务
| 任务 | 数据集 | 模型 | 参数量 | Batch Size |
|---|---|---|---|---|
| 多选题 (MC-Roberta) | SWAG | Roberta-Base | 125M | 16 |
| 问答 (QA-XLNet) | SQuAD | XLNet | 110M | 16 |
| 问答 (QA-Bert) | SQuAD | Bert-Base | 110M | 12 |
| 文本分类 (TC-Bert) | GLUE-QQP | Bert-Base | 110M | 32 |
总体性能对比
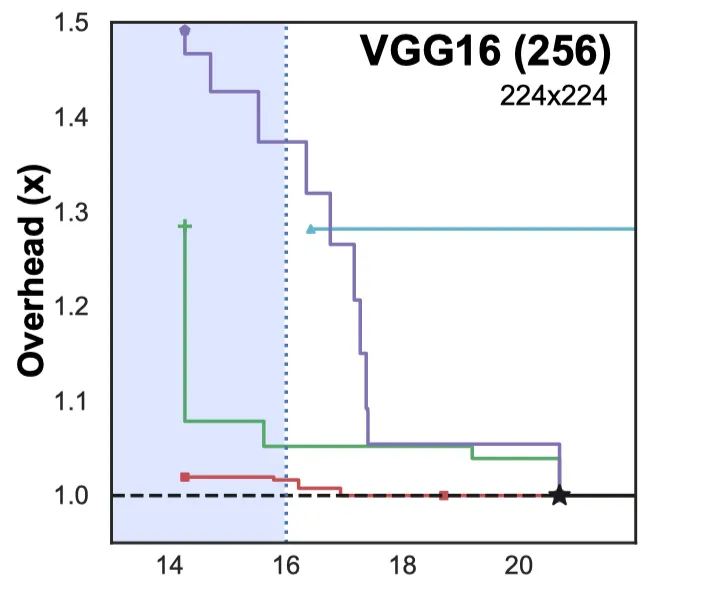
在不同内存预算下,各方法的单轮训练时间(归一化到Baseline):
-
vs Sublinear:Mimose约提升17.1%,因为Sublinear只能基于最大输入张量生成静态计划,对小输入产生大量冗余计算
-
vs DTR:Mimose平均提升约15.0%,原因包括:
- DTR的检查点延迟占迭代时间的比例很高(因OOM触发)
- DTR反复生成相同输入的计划造成大量搜索开销
- DTR在运行时产生大量内存碎片(例如MC-Roberta任务在7GB预算下DTR碎片达2.5GB,而Mimose仅为0.5GB)
-
内存预算的影响:Mimose的性能随内存预算增加而改善。在8GB预算下,Mimose相比Baseline仅慢5.1%。即使内存预算接近下限(如MC-Roberta任务的3.36GB),Mimose仍能保证正常执行。
内存消耗
- 内存消费上限与内存预算之间的差距很小(0.5GB-1GB),用于应对可能的内存碎片
- 存在少量特别低的内存消耗点,原因是前几轮迭代的数据采集器对所有模块重新计算以获得逐层内存使用情况
- 当输入增大至触及内存预算时,Mimose通过检查点计划丢弃部分激活张量来降低内存消耗
- 相似输入尺寸共享相同检查点计划,曲线呈现小幅分段上升趋势
开销分解(6GB内存预算)
| 任务 | 迭代时间 | 采集器开销 | 估计器+调度器 | 总开销 |
|---|---|---|---|---|
| MC-Roberta | 371.86 ms/iter | 145.99 ms (10次) | 0.26ms~0.32ms (17次) | 1464.77 ms (3.93 iter) |
| QA-XLNet | 1033.56 ms/iter | 294.47 ms (10次) | 0.31ms~0.39ms (69次) | 2967.76 ms (2.87 iter) |
| QA-Bert | 452.89 ms/iter | 118.96 ms (10次) | 0.27ms~0.38ms (24次) | 1196.88 ms (2.64 iter) |
| TC-Bert | 250.27 ms/iter | 157.73 ms (10次) | 0.27ms~0.34ms (51次) | 1592.49 ms (6.36 iter) |
关键发现:
- 采集器占单次迭代时间的25%-65%(由于双向前向和较慢的第一轮迭代)
- 内存估计器和调度器的总开销<1ms(占单次迭代时间的不到0.2%)
- Mimose总开销平均仅为3.95次迭代,而一个epoch包含数千次迭代
收敛性验证
训练损失表明预测偏差程度。三 Epoch 的损失曲线显示:
- Mimose的损失逐渐收敛到一个几乎恒定的值
- Mimose和Baseline的损失曲线几乎重合
- 这表明Mimose对计算图的修改不影响收敛性
- 通过保存和恢复RNG状态确保每次迭代的输出与正常前向执行一致
不同任务的收敛曲线
- QA-XLNet: convergence-loss-qa-xlnet.pdf
- QA-Bert: convergence-loss-qa-bert.pdf
- TC-Bert: convergence-loss-tc.pdf
与现有方法对比
| 维度 | Sublinear | DTR | Mimose |
|---|---|---|---|
| 规划时机 | 训练前静态规划 | OOM时动态触发 | 运行时自适应 |
| 对输入动态的利用 | 否(保守处理) | 部分 | 完全 |
| 缓存机制 | 无 | 无 | 有(按输入大小) |
| 预测模型 | 无 | 无 | 二次多项式回归 |
| 规划开销 | 零(但冗余计算多) | 高(重复生成) | <1ms(缓存命中时零开销) |
| 内存碎片 | 低 | 高(达2.5GB) | 低(0.5GB) |
| 总体提升(Baseline) | -35% | -15%~20% | -5%~-17% |
七、相关工作
模型压缩
- 低精度训练(Courbariaux et al., Gupta et al.)
- 量化(Han et al., Hubara et al.)
- 剪枝(Han et al., EIE, AUTO-PRUNE)
Swap方法
- vDNN(层粒度swap)、SwapAdvisor(遗传算法探索)、Sentinel(OS与运行时协同)
检查点方法
- Sublinear(2016):通过计算图活性分析以亚线性内存存储特征图
- Checkmate(MLSys 2020):使用混合整数线性规划(MILP)求解器搜索近优检查点计划
- DTR(ICLR 2021):动态收集张量和算子信息,OOM时贪婪丢弃
混合方法
- Capuchin(TensorFlow-based, 超线程级张量访问模式)
- HOME(粒子群算法+全模型信息)
- MegTaiChi(动态张量级内存管理优化)
关键区别
Mimose的独特之处在于:完全在线操作、无需先验知识(不需要预分析模型结构)、轻量级预测模型(二次多项式回归而非MILP或搜索)、亚毫秒级规划速度。
八、总结
核心贡献
-
提出了首个输入感知的张量检查点规划器:Mimose能够根据动态变化的输入张量大小实时调整检查点计划,而非像现有方法那样使用静态或反应式方案。
-
设计了轻量级在线内存估计器:通过在线采集数据构建二次多项式回归模型,预测精度达千分之一级别,训练和预测延迟均不到2ms。
-
实现了高效的贪心调度算法:提出基于激活大小桶和前置时间戳排序的选择策略,有效减少峰值内存使用。
-
引入了缓存优化策略:避免对重复/相似输入尺寸冗余生成检查点计划。
-
全面评估了四种NLP任务:在MC-Roberta、QA-XLNet、QA-Bert、TC-Bert四个任务上均优于Sublinear(+17.1%)和DTR(+15.0%)。
技术影响
- 使得在有限GPU显存下训练大模型更加高效
- 特别适合需要频繁微调的场景(个性化推荐、元宇宙等),概念漂移问题加剧了输入张量的动态性
- 完全兼容PyTorch生态,可直接集成到现有训练流程中
局限性
- 目标检测模型支持有限:对于Swin Transformer等CV模型中的padding操作带来的阶跃效应影响较小(<5%误差),但对于两阶段目标检测模型(如Faster R-CNN中anchor/proposal数量的不可预测性)的内存波动无法准确预测,留作未来工作。
- 基于层粒度而非张量粒度:受限于PyTorch的检查点API,目前最小重算单位为层/模块级别。
- 仅支持NLP和部分CV模型:对具有复杂动态行为(如可变数量proposal)的模型需要进一步的自适应算法支持。
- 采集阶段的临时开销:前10-30次迭代需要双向前向传播,虽然相对于千次级别的epoch总迭代次数影响可忽略,但在小数据集上可能占比更高。
九、参考资源
- arXiv论文:https://arxiv.org/abs/2209.02478
- PDF下载:https://arxiv.org/pdf/2209.02478
- LaTeX源文件:https://arxiv.org/src/2209.02478
- DOI:https://doi.org/10.48550/arXiv.2209.02478
- 主要参考文献:
- Sublinear: Chen et al., 2016 (arXiv:1604.06174)
- Checkmate: Jain et al., MLSys 2020
- DTR: Kirisame et al., ICLR 2021
- Capuchin: Peng et al., ASPLOS 2020
- HOME: He et al., IEEE TC 2022