TensorIR: An Abstraction for Automatic Tensorized Program Optimization
面向自动张量化程序优化的编译器抽象,通过Block抽象实现硬件张量计算原语的自动利用
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TensorIR: An Abstraction for Automatic Tensorized Program Optimization |
| 作者 | Siyuan Feng, Bohan Hou, Hongyi Jin, Wuwei Lin, Junru Shao, Ruihang Lai, Zihao Ye, Lianmin Zheng, Cody Hao Yu, Yong Yu, Tianqi Chen |
| 机构 | Shanghai Jiao Tong University, Carnegie Mellon University, UC Berkeley, OctoML, Amazon Web Services |
| 论文 | https://arxiv.org/abs/2207.04296 |
| 发布 | 2022-07-09 (v1), 2022-10-27 (v2) |
| 会议 | ASPLOS 2023 |
| 类别 | cs.LG, cs.AI, cs.PL |
二、核心思想
问题定义
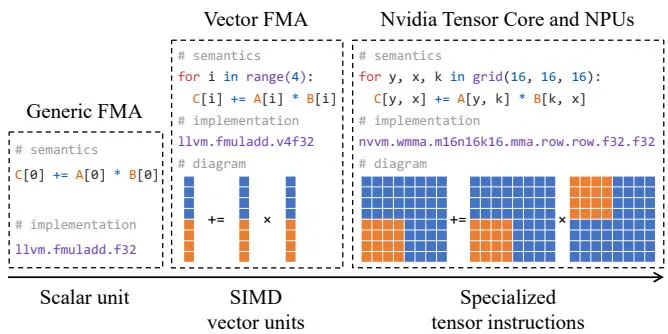
深度学习模型部署到各种设备已成为重要课题。硬件专业化浪潮带来了多样化的多维张量计算加速原语(如NVIDIA Tensor Core、Google TPU等)。这些新的加速原语与新兴机器学习模型一起,带来了巨大的工程挑战。当前大多数张量化程序由领域专家手工优化,需要大量工程努力来支持不断增长的模型和后端集合。
解决方案概述
本文提出TensorIR,一个用于优化包含张量计算原语程序的编译器抽象。TensorIR将现有机器学习编译器中使用的循环嵌套表示推广,使张量计算成为一等公民。核心创新是引入Block抽象,将张量化计算与外部循环嵌套隔离,使得可以独立优化内外两部分。在此基础上,构建了一个端到端的自动优化框架,能够自动将深度学习模型映射到给定硬件的张量计算原语。
三、技术架构
整体框架图
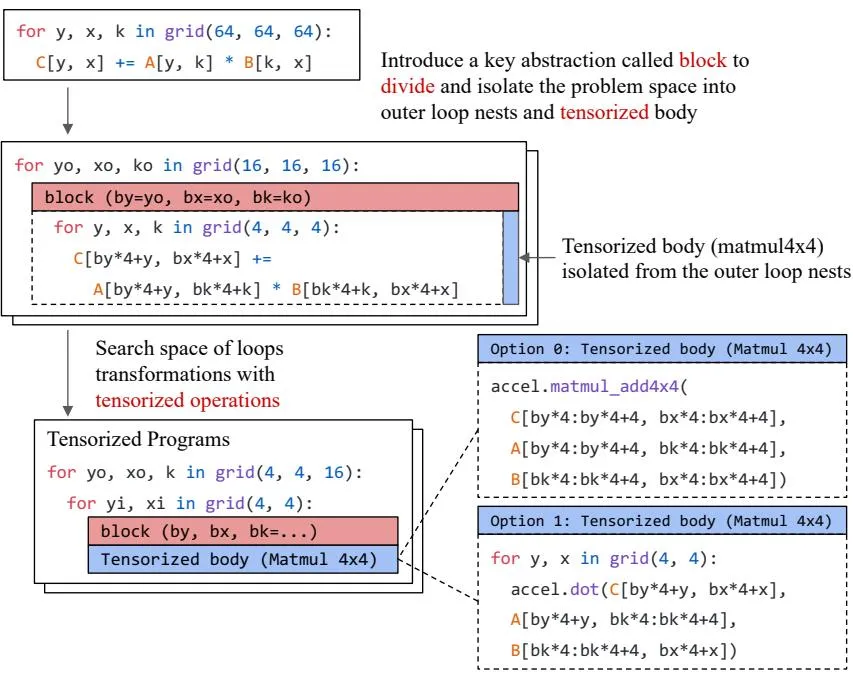
TensorIR采用分治方法:
- 问题分解:将原始程序分解为张量化计算子问题和使用这些子问题的循环嵌套
- 独立优化:分别优化外部循环嵌套和张量化计算体
- 自动调度:通过进化搜索找到最优程序配置
核心抽象:Block
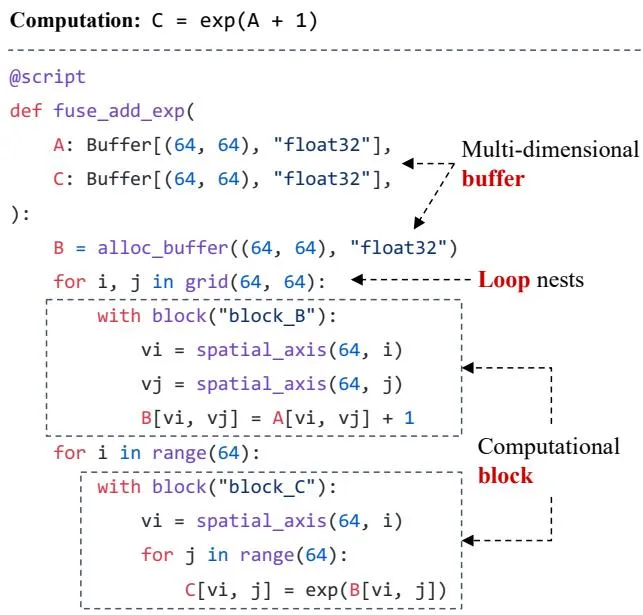
TensorIR程序包含三个主要元素:
- 多维缓冲区(Multi-dimensional Buffers):表示数据的多维访问
- 循环嵌套(Loop Nests):可能包含GPU线程绑定
- 计算块(Blocks):表示张量化计算
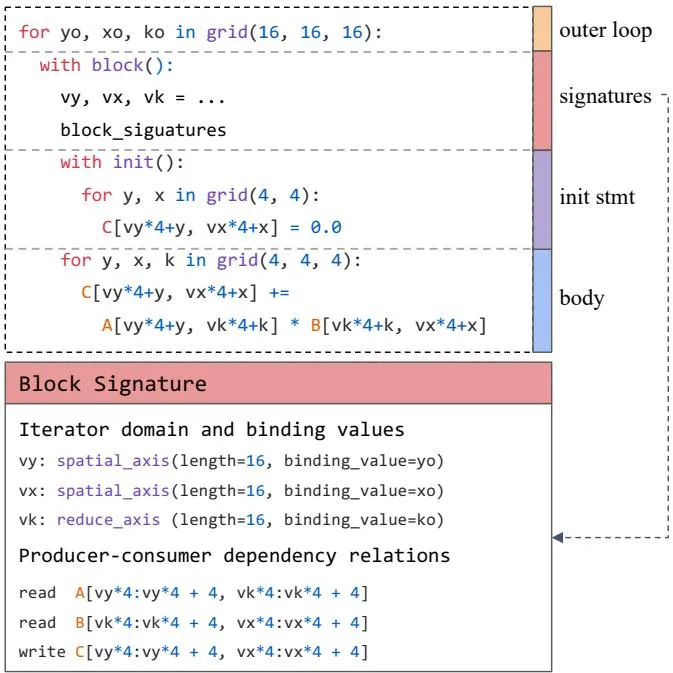
Block的关键设计:
- 隔离性:Block将张量化计算与外部循环嵌套隔离
- 签名信息:包含迭代器域、绑定值、读写依赖关系
- 依赖分析:通过签名信息进行依赖分析,无需查看内部实现
调度变换原语
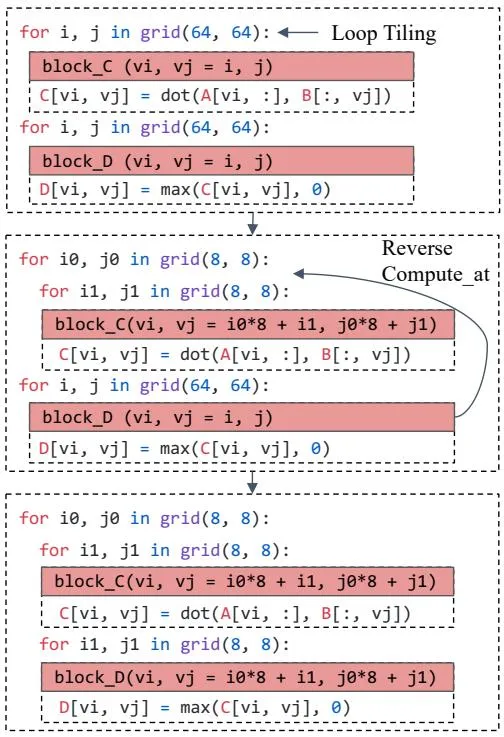
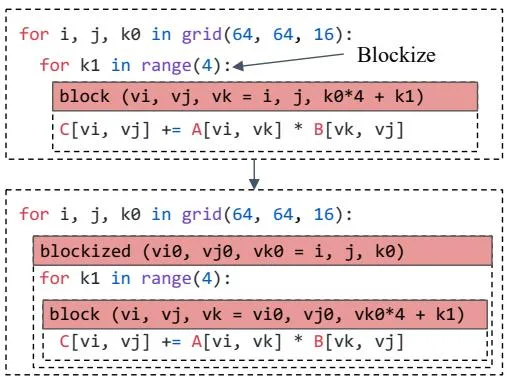
TensorIR提供丰富的调度变换原语:
- 循环变换:Split、Reorder、Compute Location等
- Block化(Blockization):创建新Block隔离子区域计算
- 缓存原语:引入子Block将数据缓存到共享内存
- 归约变换:单归约Block与init-update Block之间的转换
自动调度算法
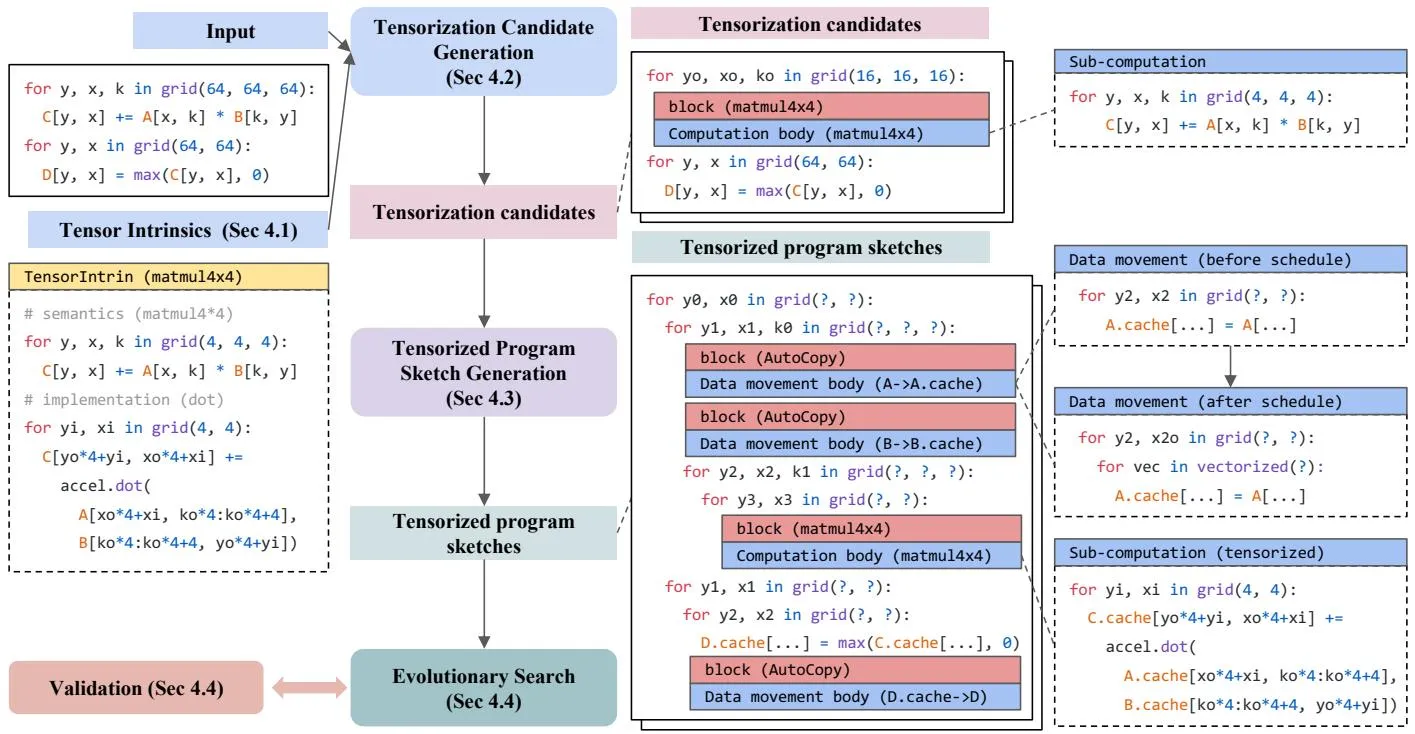
自动调度流程:
- 张量化候选生成:检查计算模式,匹配张量内在函数
- 张量化程序草图生成:构建包含张量化计算的程序搜索空间
- 进化搜索:使用学习成本模型引导搜索,找到最优程序
张量化候选生成
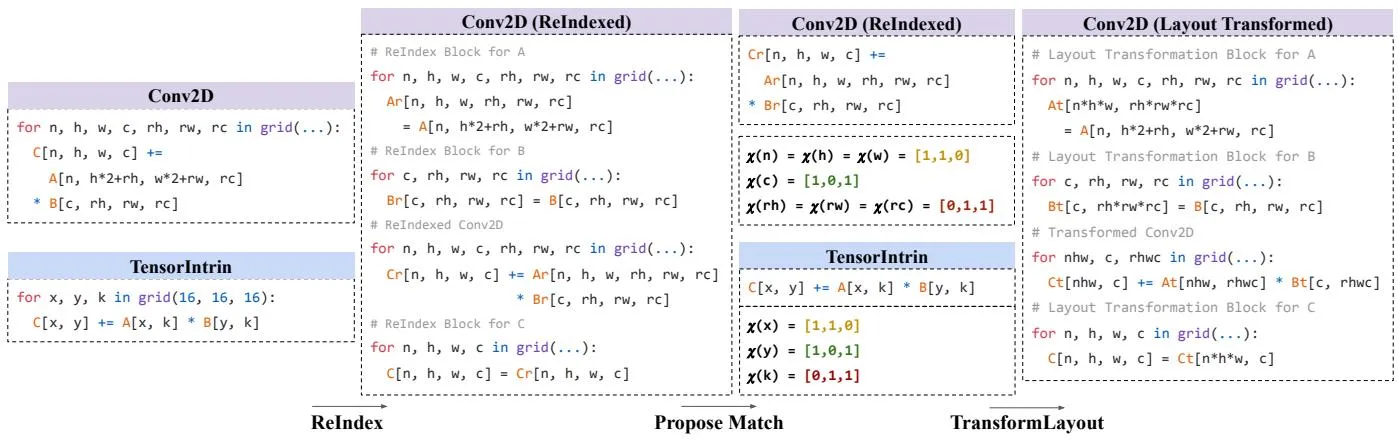
候选生成过程:
- 模式匹配:匹配表达式模式
C[.] += A[.] × B[.] - ReIndex变换:重写缓冲区访问表达式,使用中间迭代器
- 特征向量匹配:通过特征向量 χ(v) 建立迭代器映射
- 循环重组与Block化:填充、分块、隔离张量化计算
核心公式
张量内在函数形式化:
工作负载标量表达式:
ReIndex变换后:
特征向量定义:
其中 [] 是Iverson括号,条件为真返回1,否则返回0。
fuse操作:
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Block抽象 | 将张量化计算与循环变换隔离,提供依赖分析接口 | 支持独立优化内外问题空间 |
| 分治方法 | 覆盖Bottom-Up和Top-Down方法的搜索空间 | 统一现有编译器方法 |
| 数据移动作为一等公民 | 将AutoCopy块插入程序草图,独立调度数据移动 | 解决张量化后数据移动成为瓶颈的问题 |
| 进化搜索与验证 | 使用学习成本模型引导搜索,验证机制过滤无效程序 | 支持数十亿候选程序的高效搜索 |
五、实验结果
单算子评估(NVIDIA RTX 3080)
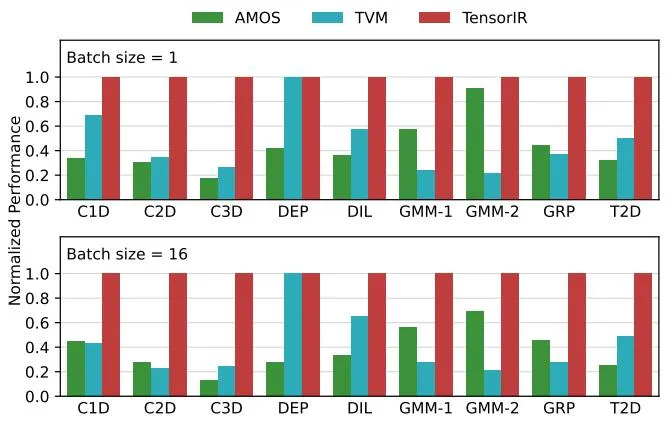
与现有ML编译器比较:
- TensorIR比TVM和AMOS快最多7.5倍
- 改进来自动态利用张量计算原语和相应的数据移动
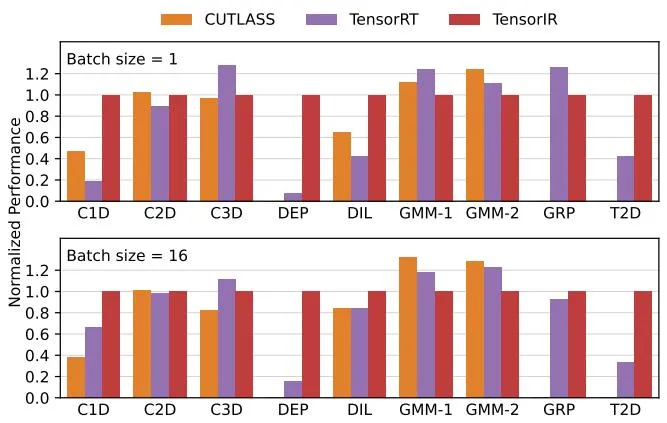
与平台特定库比较:
- 在C1D、C2D、DEP、T2D、DIL上比CUTLASS/TensorRT快最多13.9倍
- 在C3D、GRP、GMM上达到75%以上的吞吐量
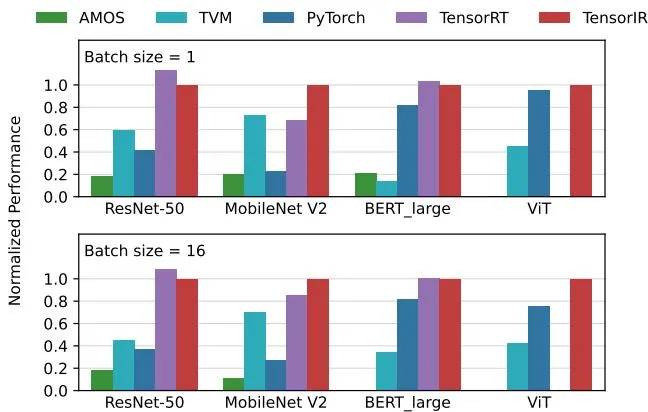
端到端模型评估(NVIDIA GPU)
- 比PyTorch、TVM、AMOS快1.2-8.8倍
- MobileNet V2比TensorRT快30%
- ResNet-50和BERT_large达到88%-100%吞吐量
- 自动支持Vision Transformer(TensorRT尚不支持)
调优时间比较:
| 模型 | TVM (分钟) | TensorIR (分钟) |
|---|---|---|
| ResNet-50 | 308 | 156 |
| MobileNet-v2 | 292 | 261 |
| BERT | 410 | 189 |
| ViT | 247 | 145 |
TensorIR调优速度比TVM快最多2倍。
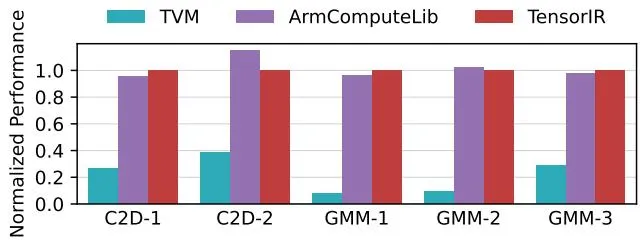
ARM CPU评估
- 比TVM快最多12.5倍(利用原生硬件加速)
- 达到ARMComputeLib的85%-105%吞吐量
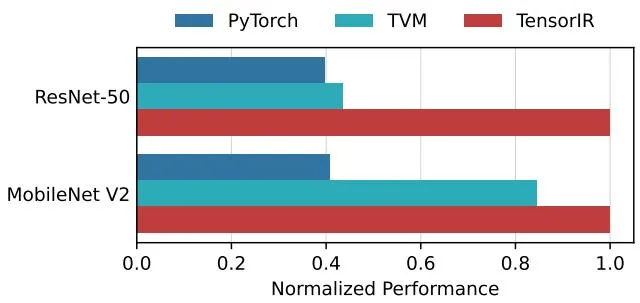
- 端到端模型比PyTorch和TVM快1.2-2.5倍
六、相关工作
| 方向 | 代表工作 | 与TensorIR的关系 |
|---|---|---|
| ML框架 | TensorFlow, PyTorch, MXNet | TensorIR可集成到这些框架中生成优化代码 |
| 张量编译器 | Halide, TVM, Tiramisu, MLIR | TensorIR推广这些表示到张量化程序 |
| 自动调度 | AutoTVM, Ansor, FlexTensor | TensorIR扩展这些方法支持张量化计算 |
| 自动向量化 | 传统编译器研究 | 张量化是向量化的推广 |
| 平台库 | cuDNN, CUTLASS, TensorRT | TensorIR自动生成可比性能的代码 |
七、总结
核心贡献
- 提出Block抽象,将张量化计算与循环变换隔离,提供有效的变换原语
- 构建自动调度算法,联合执行张量化和其他优化
- 实现端到端框架,自动优化深度学习模型以利用硬件张量计算原语
技术影响
- 自动化:减少对领域专家手工优化的依赖
- 可移植性:同一框架支持多种硬件后端(NVIDIA GPU、ARM CPU)
- 性能:自动达到或接近厂商优化库的性能水平
- 扩展性:易于添加新的张量内在函数和硬件后端
局限性
- 搜索空间仍然庞大,需要有效的成本模型和搜索策略
- 某些极端优化场景可能仍需手工调优
- 当前实现基于TVM,推广到其他编译框架需要额外工作
八、参考资源
- 论文:https://arxiv.org/abs/2207.04296
- 项目:Apache TVM (TensorIR已集成)