Training Compute-Optimal Large Language Models (Chinchilla)
Chinchilla论文提出计算最优的LLM缩放定律:模型大小和训练token数应按同等比例缩放(各为C^0.5),发现当前LLM严重欠训练,Chinchilla(70B/1.4T)在相同计算量下显著超越Gopher(280B)/GPT-3(175B)。
Training Compute-Optimal Large Language Models (Chinchilla)
一、论文概述 (Overview)
1.1 基本信息
| 项目 | 内容 |
|---|---|
| 标题 | Training Compute-Optimal Large Language Models |
| arXiv ID | 2203.15556 |
| 作者 | Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, Thomas Hennigan, Eric Noland, Katherine Millar, Tom Michalak, Sanjay Subramanian, Edgar Gould, Toby Pohlen, Zhitao Gong, Chris Johnson, Emily Blais, Laurent Picard, Connor Lyons, Daniel D. Johnson, Anton Sokokov, Erik Akten, Evan Clarkson, Andrew Sheese, Neil Rizzo, Millicent L. Pennington, Kaushik Sadhanala, Timothy Lillicrap, David Silver, Oriol Vinyals, Alfredo Canziani, George Tucker |
| 机构 | Google DeepMind |
| 论文 | https://arxiv.org/abs/2203.15556 |
| 发布日期 | 2022-03-29 |
1.2 摘要
本文研究了在给定计算预算下,训练Transformer语言模型的最优模型大小和token数量的关系。研究发现当前的大语言模型存在严重欠训练的问题,这是由于近期在缩放语言模型时保持训练数据量不变的策略导致的。
通过对400多个语言模型进行训练(模型大小从70M到超过16B参数,训练token数从5B到500B),本文发现对于计算最优训练,模型大小和训练token数应该以同等比例缩放:模型大小每翻倍,训练token数也应翻倍(各约为C^0.5)。
基于此假设,本文训练了一个预测的计算最优模型——Chinchilla(70B参数,1.4T训练token),使用与Gopher相同的计算预算。Chinchilla在大量下游评估任务中一致且显著地超越了Gopher (280B)、GPT-3 (175B)、Jurassic-1 (178B)和Megatron-Turing NLG (530B)。这意味着Chinchilla在微调和推理时使用少得多的计算量,大大促进了下游应用。作为亮点,Chinchilla在MMLU基准测试中达到了**67.5%**的最优平均准确率,比Gopher提升了超过7%。
1.3 核心贡献
- 计算最优缩放定律: 首次系统性地证明模型大小和训练token数应以同等比例缩放(指数≈0.5)
- 发现LLM严重欠训练: 当前主流LLM(Gopher、GPT-3等)在相同计算预算下被严重高估了模型大小
- Chinchilla模型: 训练70B参数模型用于1.4T tokens,性能全面超越280B-530B的现有模型
- 三种独立验证方法: 固定模型大小变化token数、IsoFLOP曲线、参数化损失函数拟合,结果一致
- 广泛的消融实验: 验证缩放定律在不同数据集、优化器、学习率调度下的鲁棒性
二、核心思想 (Core Ideas)
2.1 问题定义
给定计算预算C,如何最优地分配模型参数数量N和训练token数量D?
计算约束: 训练FLOPs与模型大小和token数的关系为:
其中L是transformer层数。
优化目标:
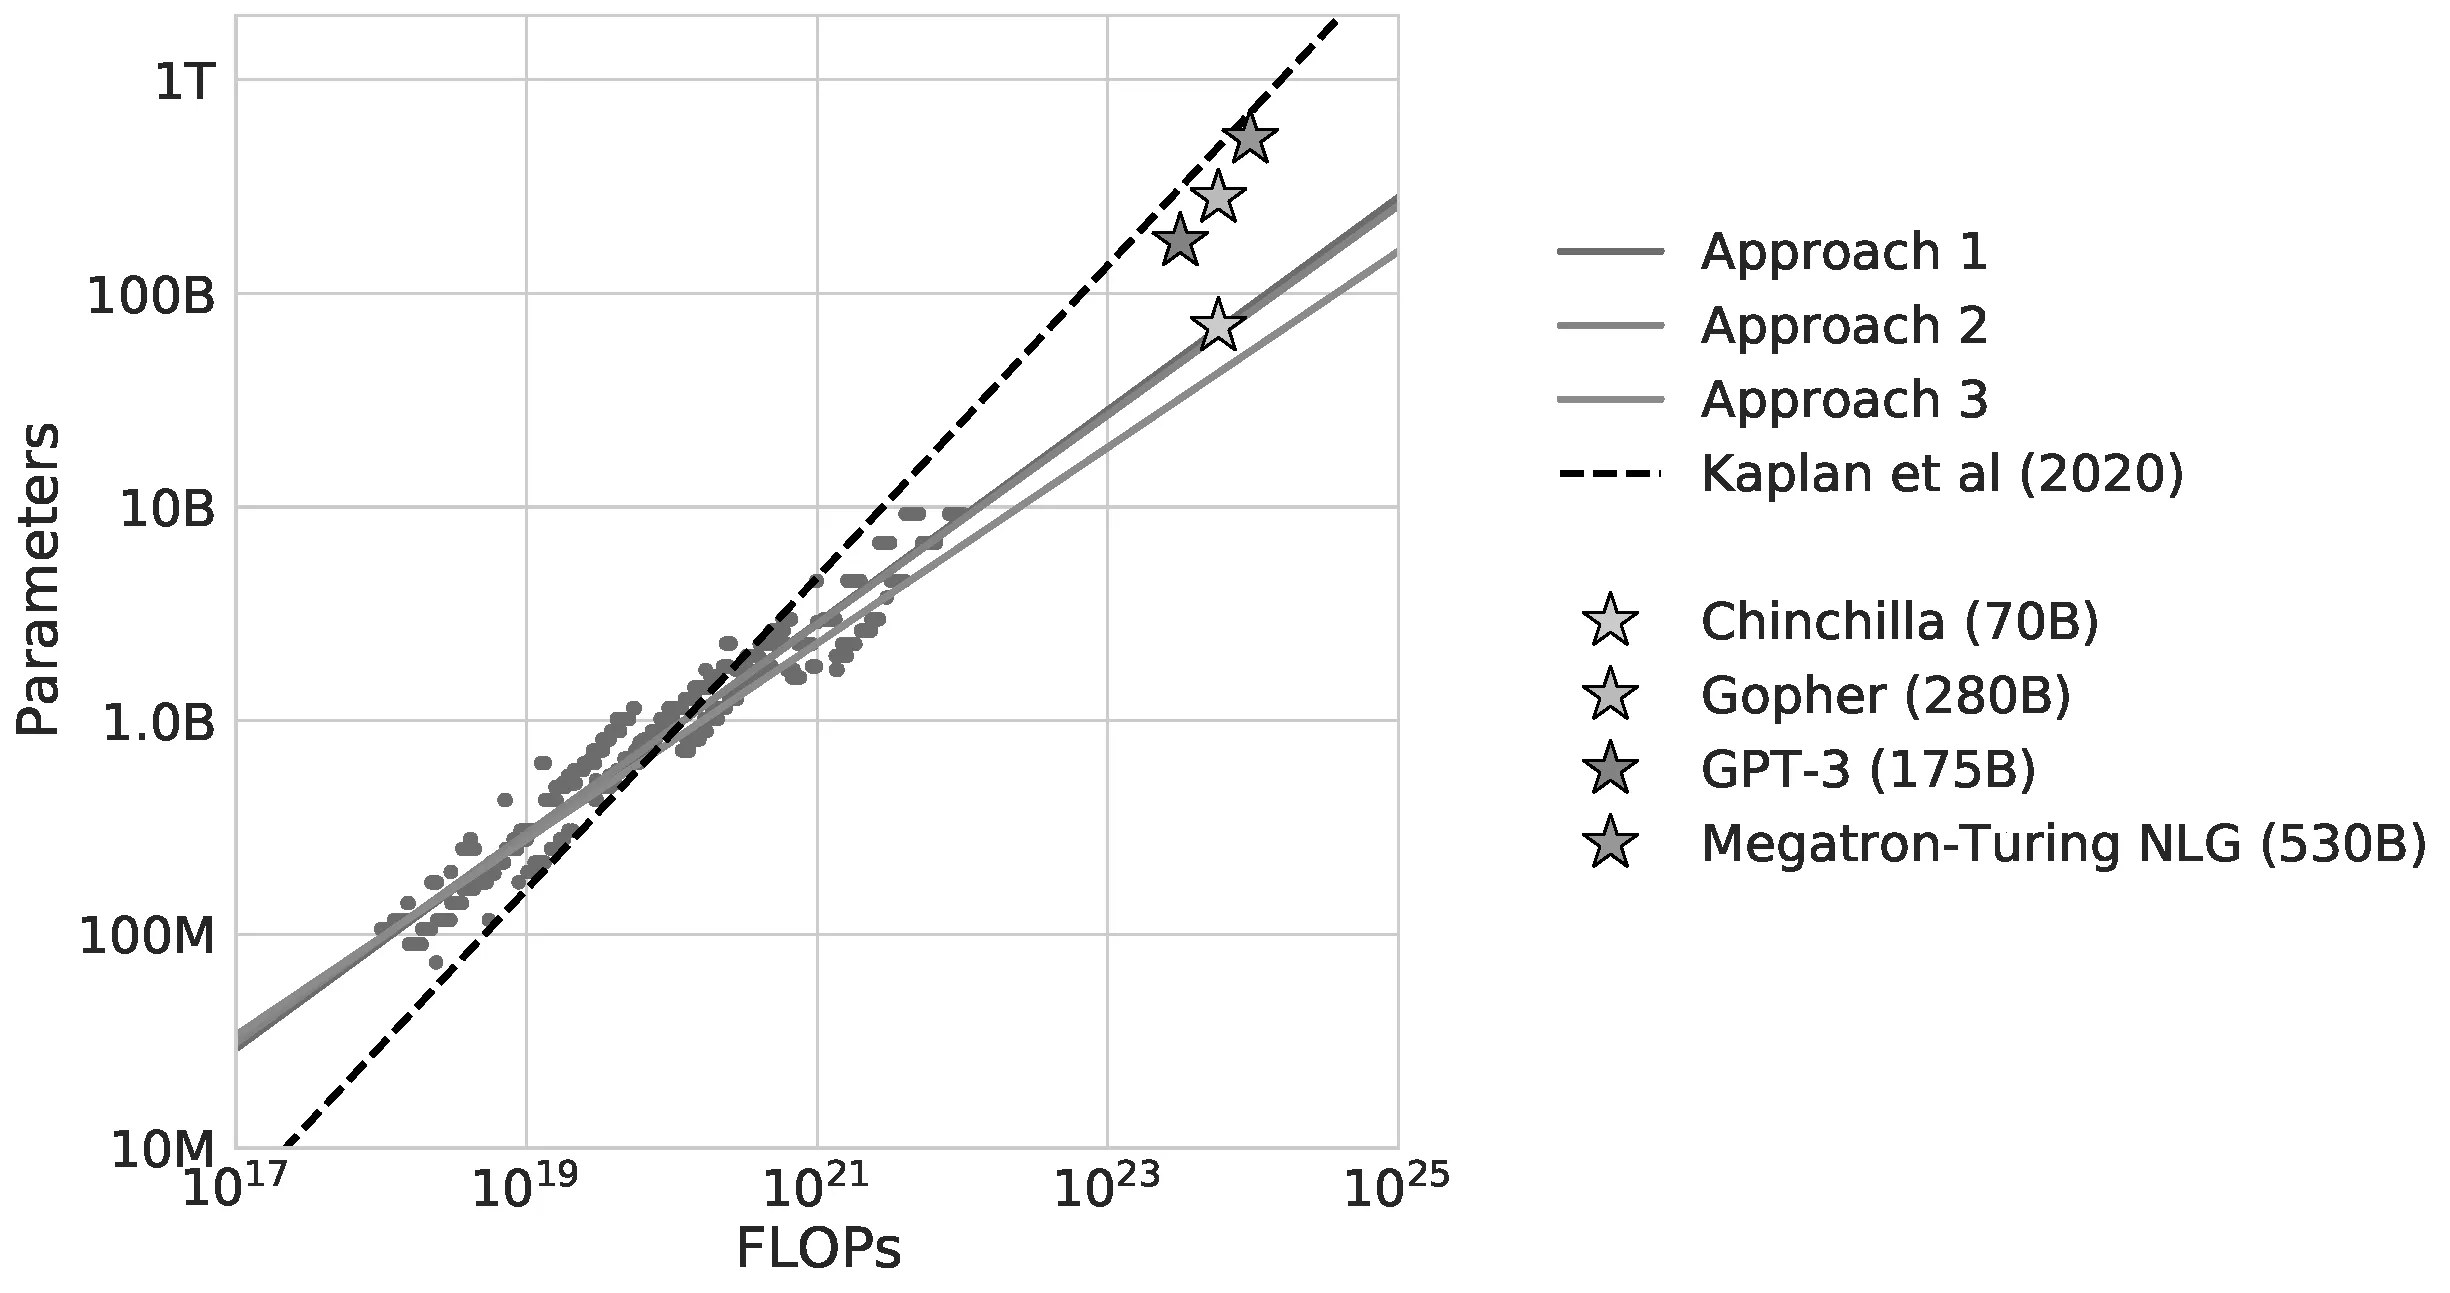
2.2 Kaplan等人工作的局限
Kaplan et al. (2020) 发现语言模型损失与参数数量之间存在幂律关系,推动了”越大越好”的模型缩放策略。但他们指出:
- 给定计算预算增加,模型大小应增加约5.5倍,而token数仅增加1.8倍
本文发现这一估计的token数严重不足,并提出完全不同的缩放比例。
2.3 核心发现
模型大小和训练token数应以相等比例缩放:
即对于计算预算的每次翻倍,模型大小和训练token数都应同样翻倍。这与Kaplan等人的结论形成鲜明对比。
三、技术架构 (Technical Architecture)
3.1 三种估算最优参数/token分配的方法
方法1: 固定模型大小,变化训练token数
对每个参数规模(70M到10B+),训练4个不同token数的模型,通过训练曲线包络线提取最小损失。
关键步骤:
- 训练不同大小的模型族,每个模型在4个不同训练步数下训练
- 平滑并插值训练损失曲线
- 对每个FLOP计数,找到达到最低损失的模型配置
- 拟合幂律:
结果:
方法2: IsoFLOP轮廓
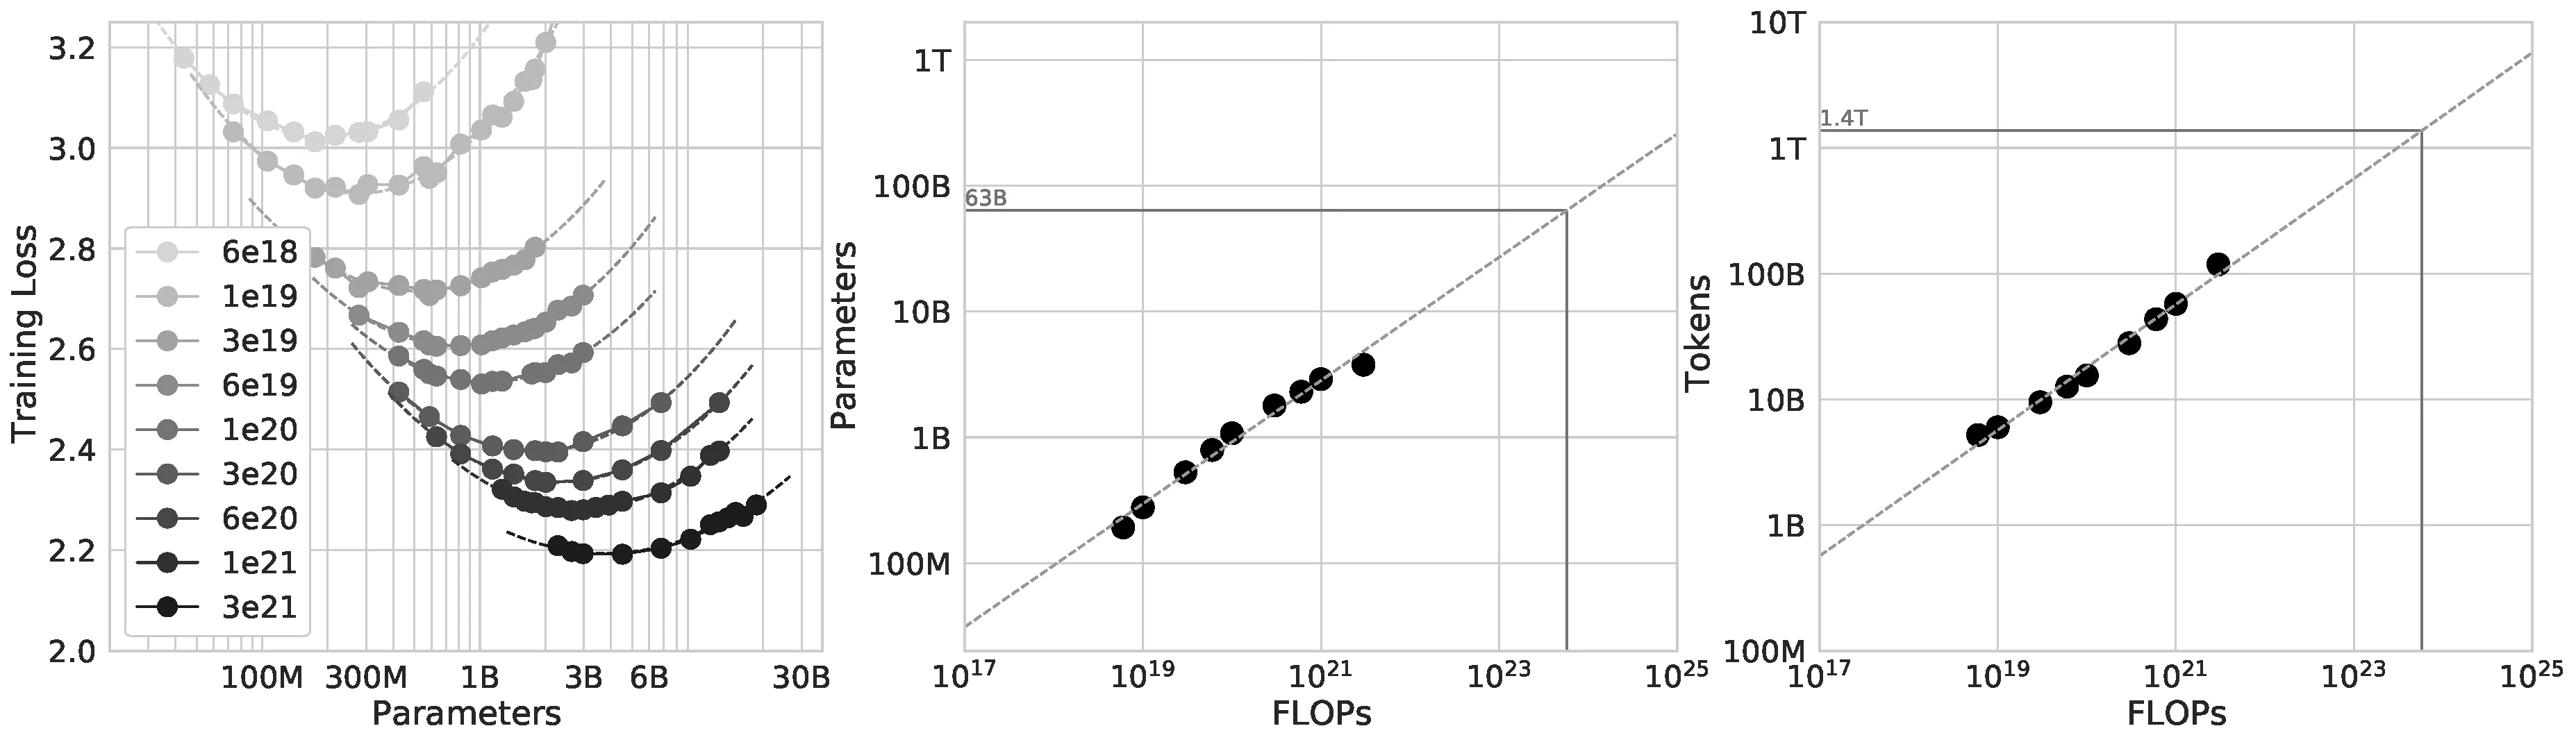
固定FLOP计数,变化模型大小,观察损失变化。
关键步骤:
- 对9个不同的训练FLOP计数(到)
- 对每个FLOP预算,绘制最终损失(平滑后)与参数数量的关系
- 对每个IsoFLOP曲线拟合抛物线,估计最小损失对应的模型大小
- 拟合幂律:
结果:
方法3: 参数化损失函数拟合
将所有最终损失建模为参数数量和token数的函数:
其中:
- : 数据分布的理想生成损失(对应自然文本的熵)
- : 模型容量不足导致的损失
- : 训练不足导致的损失
结果:
3.2 Chinchilla模型配置
| 参数 | Gopher (280B) | Chinchilla (70B) |
|---|---|---|
| 层数 | 80 | 80 |
| 键/值大小 | 128 | 64 |
| 瓶颈激活大小 | 128 | 128 |
| 最大学习率 | ||
| 训练批次大小 | 3M-6M tokens | 1.5M-3M tokens |
| 训练token数 | 300B | 1.4T |
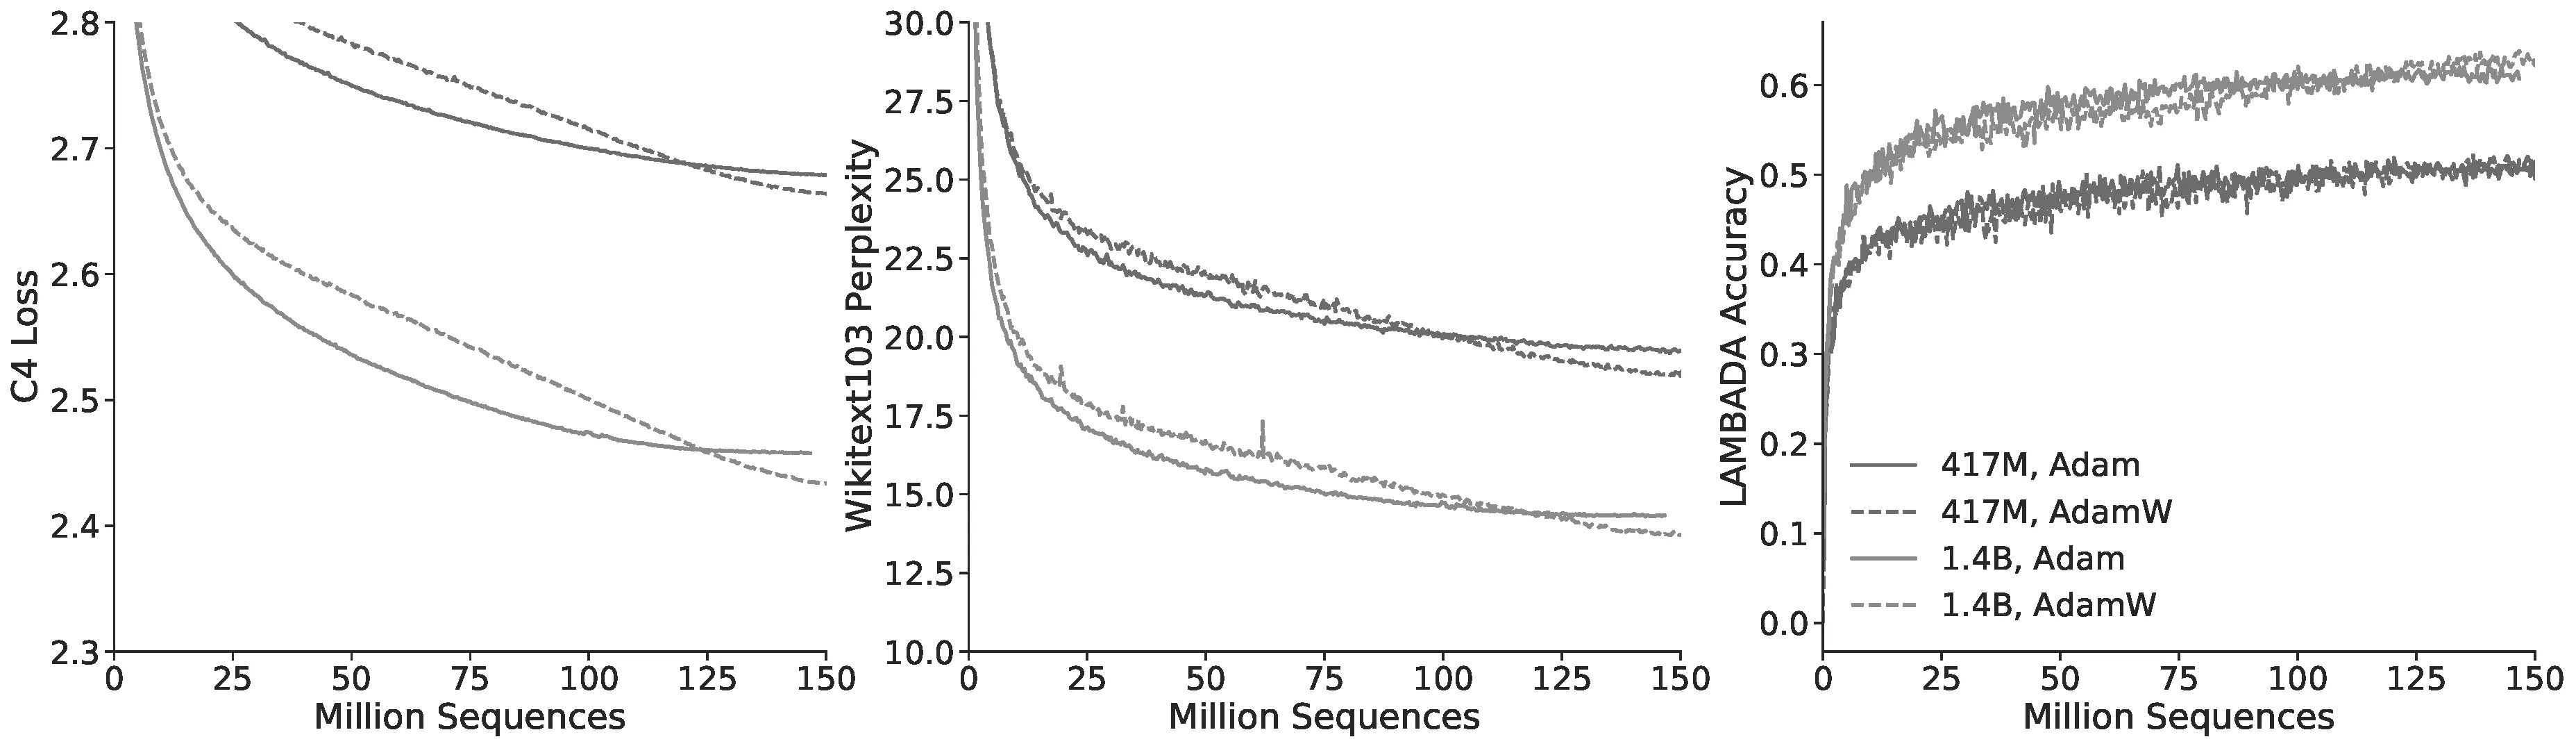
| 优化器 | Adam | AdamW |
关键差异:
- 使用AdamW而非Adam,改进了语言建模损失和微调后下游任务性能
- 使用略微修改的SentencePiece tokenizer(不应用NFKC规范化)
- 前向和反向传播在FP16中进行,但分布式优化器状态中存储FP32权重副本
3.3 训练细节
- 硬件: TPUv3/TPUv4 with JAX and Haiku
- 数据集: C4 (与Gopher相同)
- 评估: 与Gopher相同的评估协议
四、核心创新 (Key Innovations)
| 创新点 | 说明 | 影响 |
|---|---|---|
| 等比例缩放定律 | 模型大小和token数均以C^0.5比例缩放 | 推翻Kaplan等人结论,指导未来模型设计 |
| 三种独立验证 | 固定模型变化token、IsoFLOP、参数化拟合 | 结果高度一致,增强结论可信度 |
| Chinchilla实践 | 70B参数 + 1.4T tokens = 超越530B模型 | 证明”更小更多数据”策略的有效性 |
| 参数化损失函数 | 提供理论框架理解缩放行为 | |
| 广泛的消融实验 | 验证缩放定律在不同条件下的鲁棒性 | 确认发现的普适性 |
五、实验结果 (Experimental Results)
5.1 Chinchilla vs Gopher性能对比
MMLU基准测试结果:
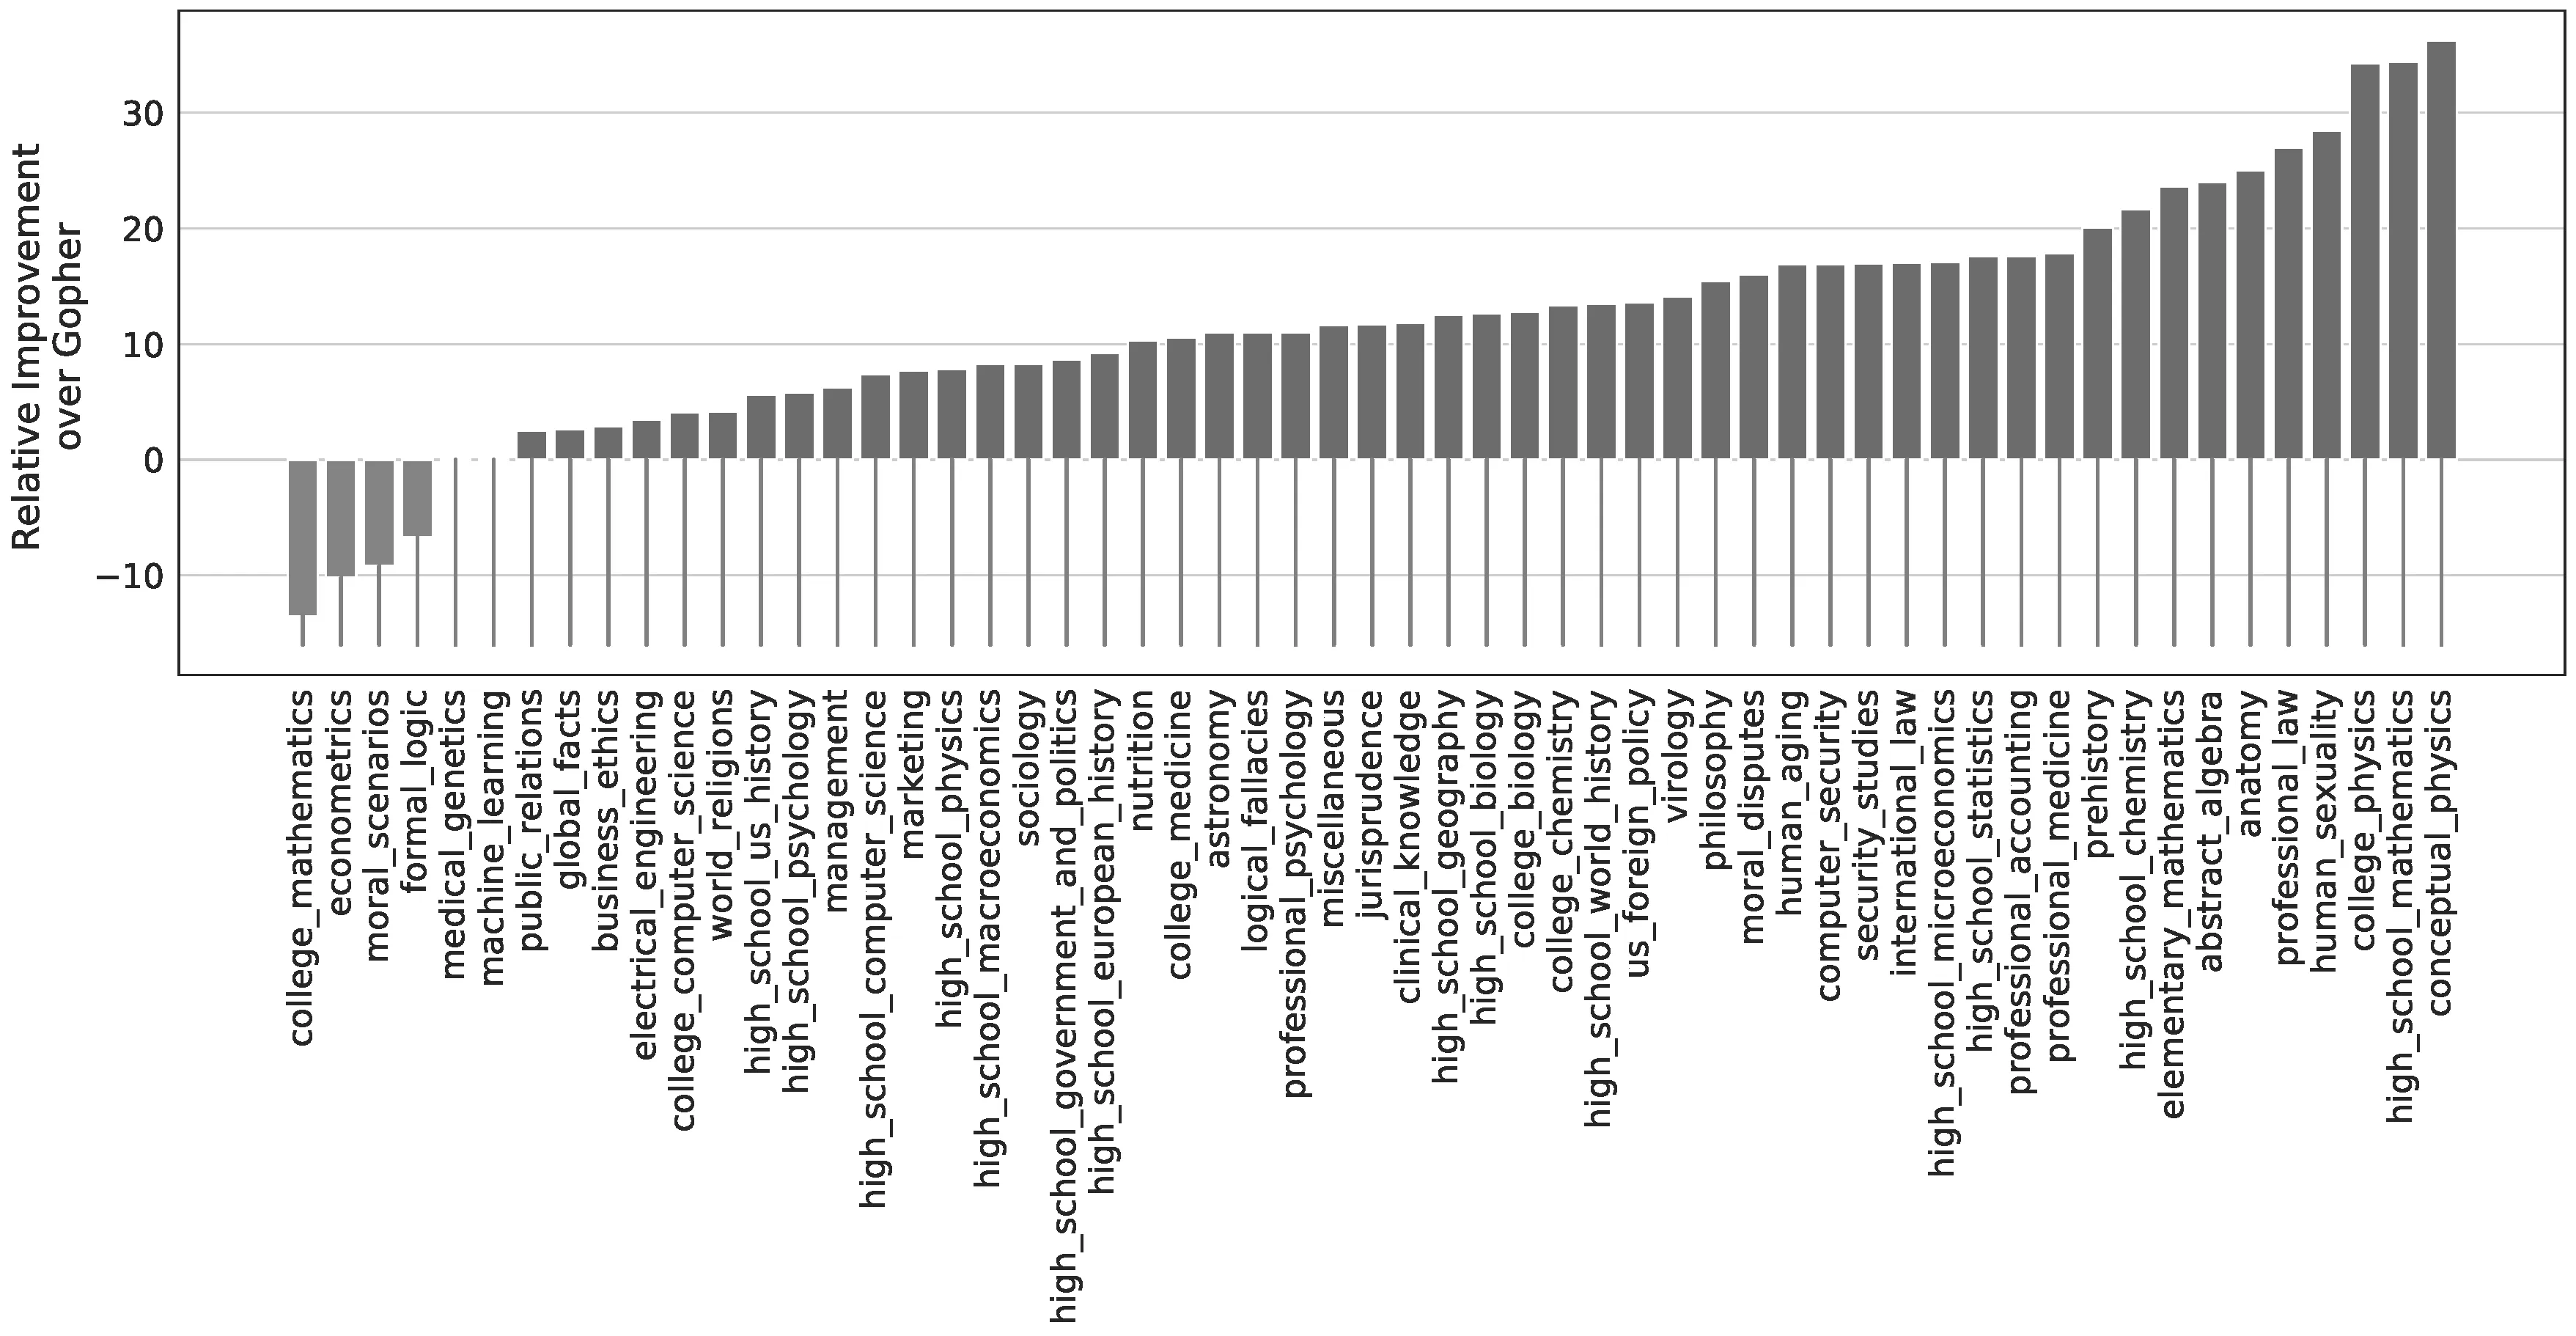
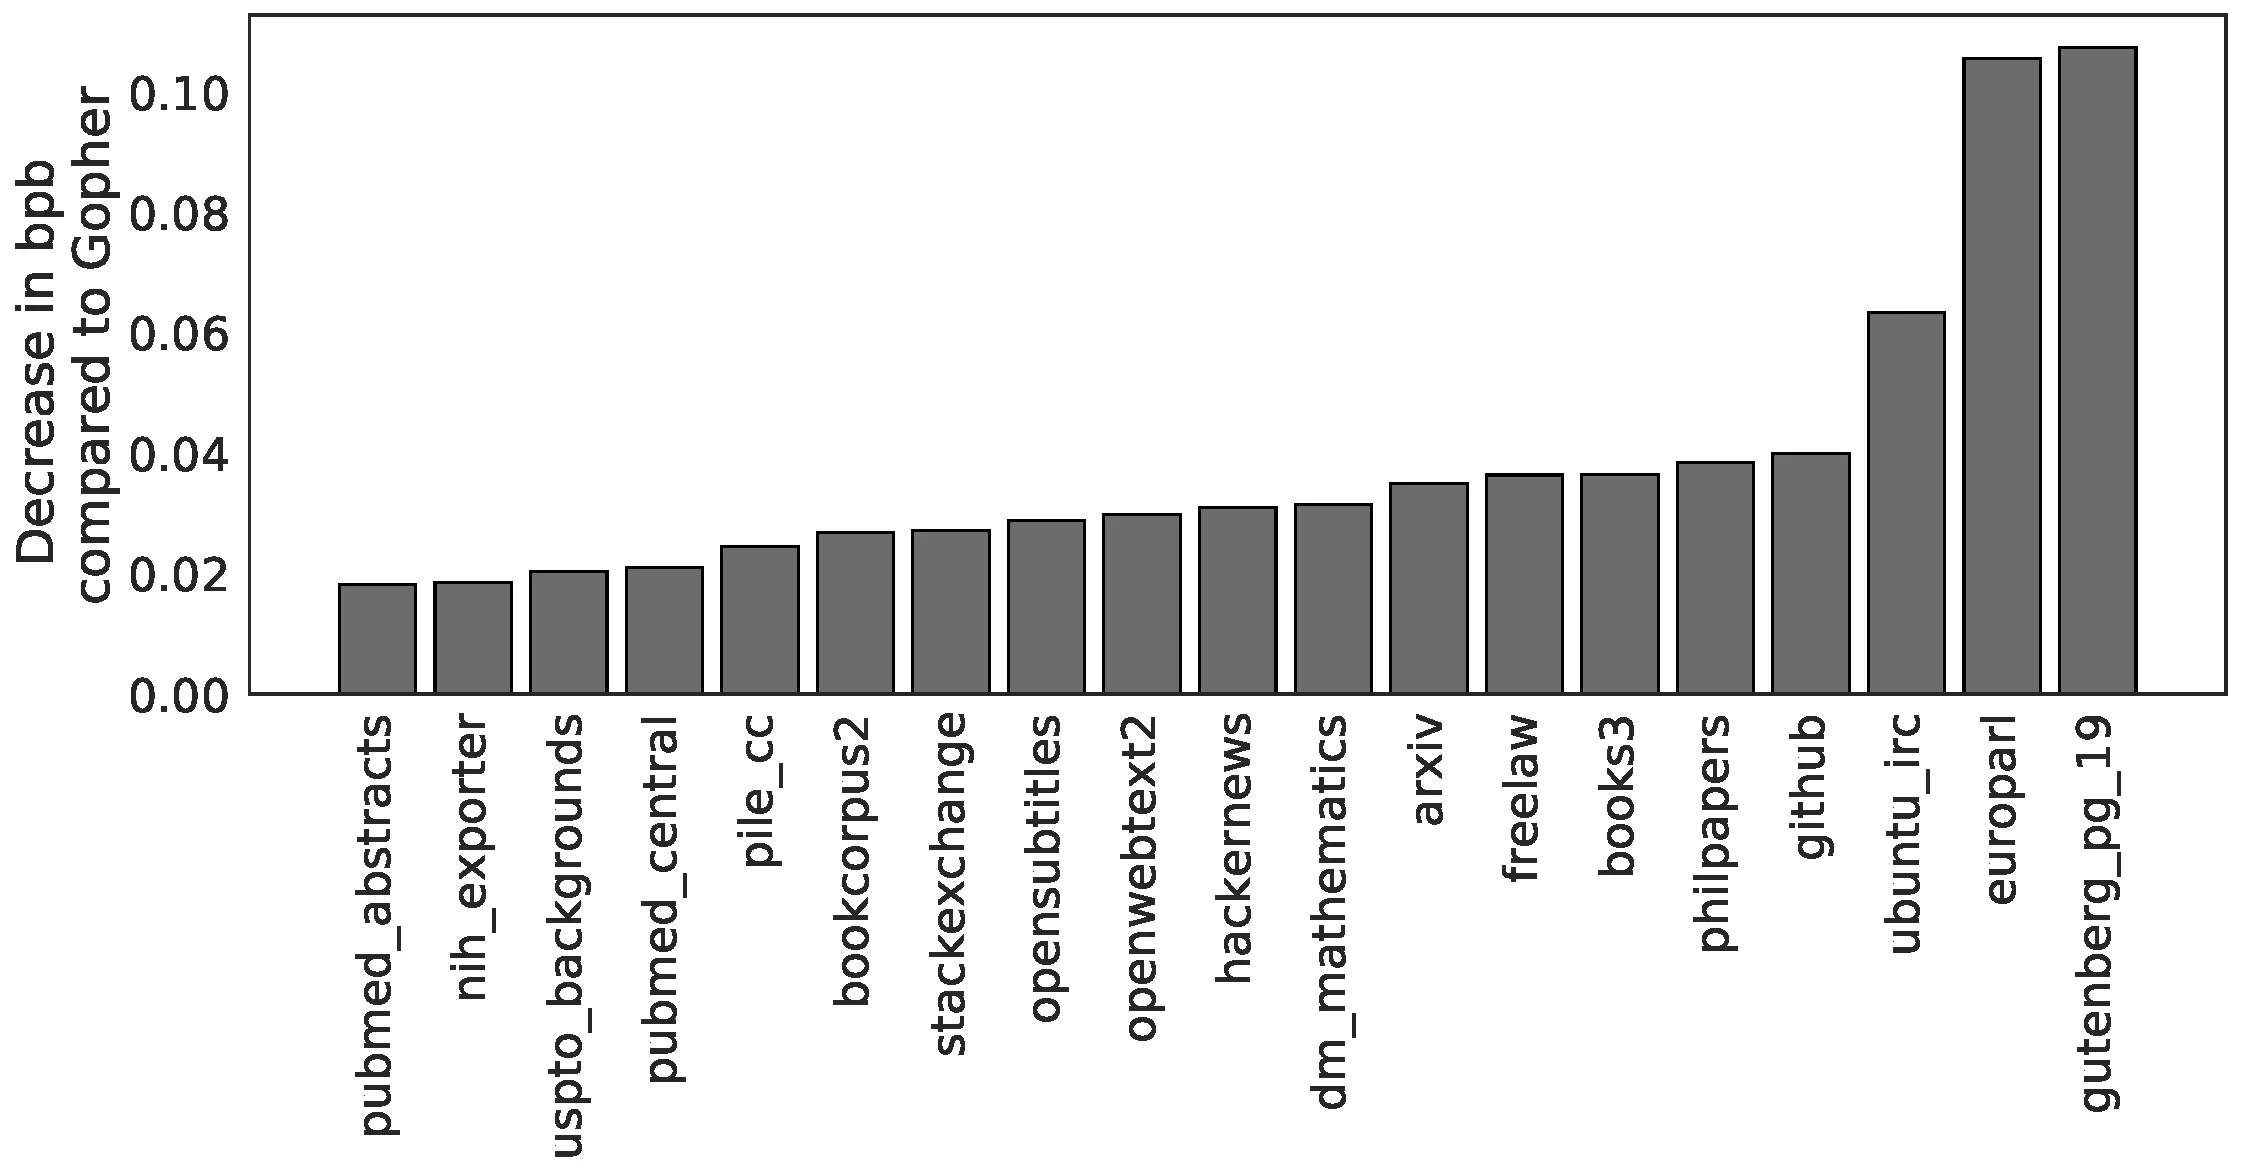
Chinchilla在MMLU上达到67.5%的平均准确率,比Gopher (280B)提升超过7%,显著超越GPT-3 (175B)、Jurassic-1 (178B)和Megatron-Turing NLG (530B)。
BigBench结果:
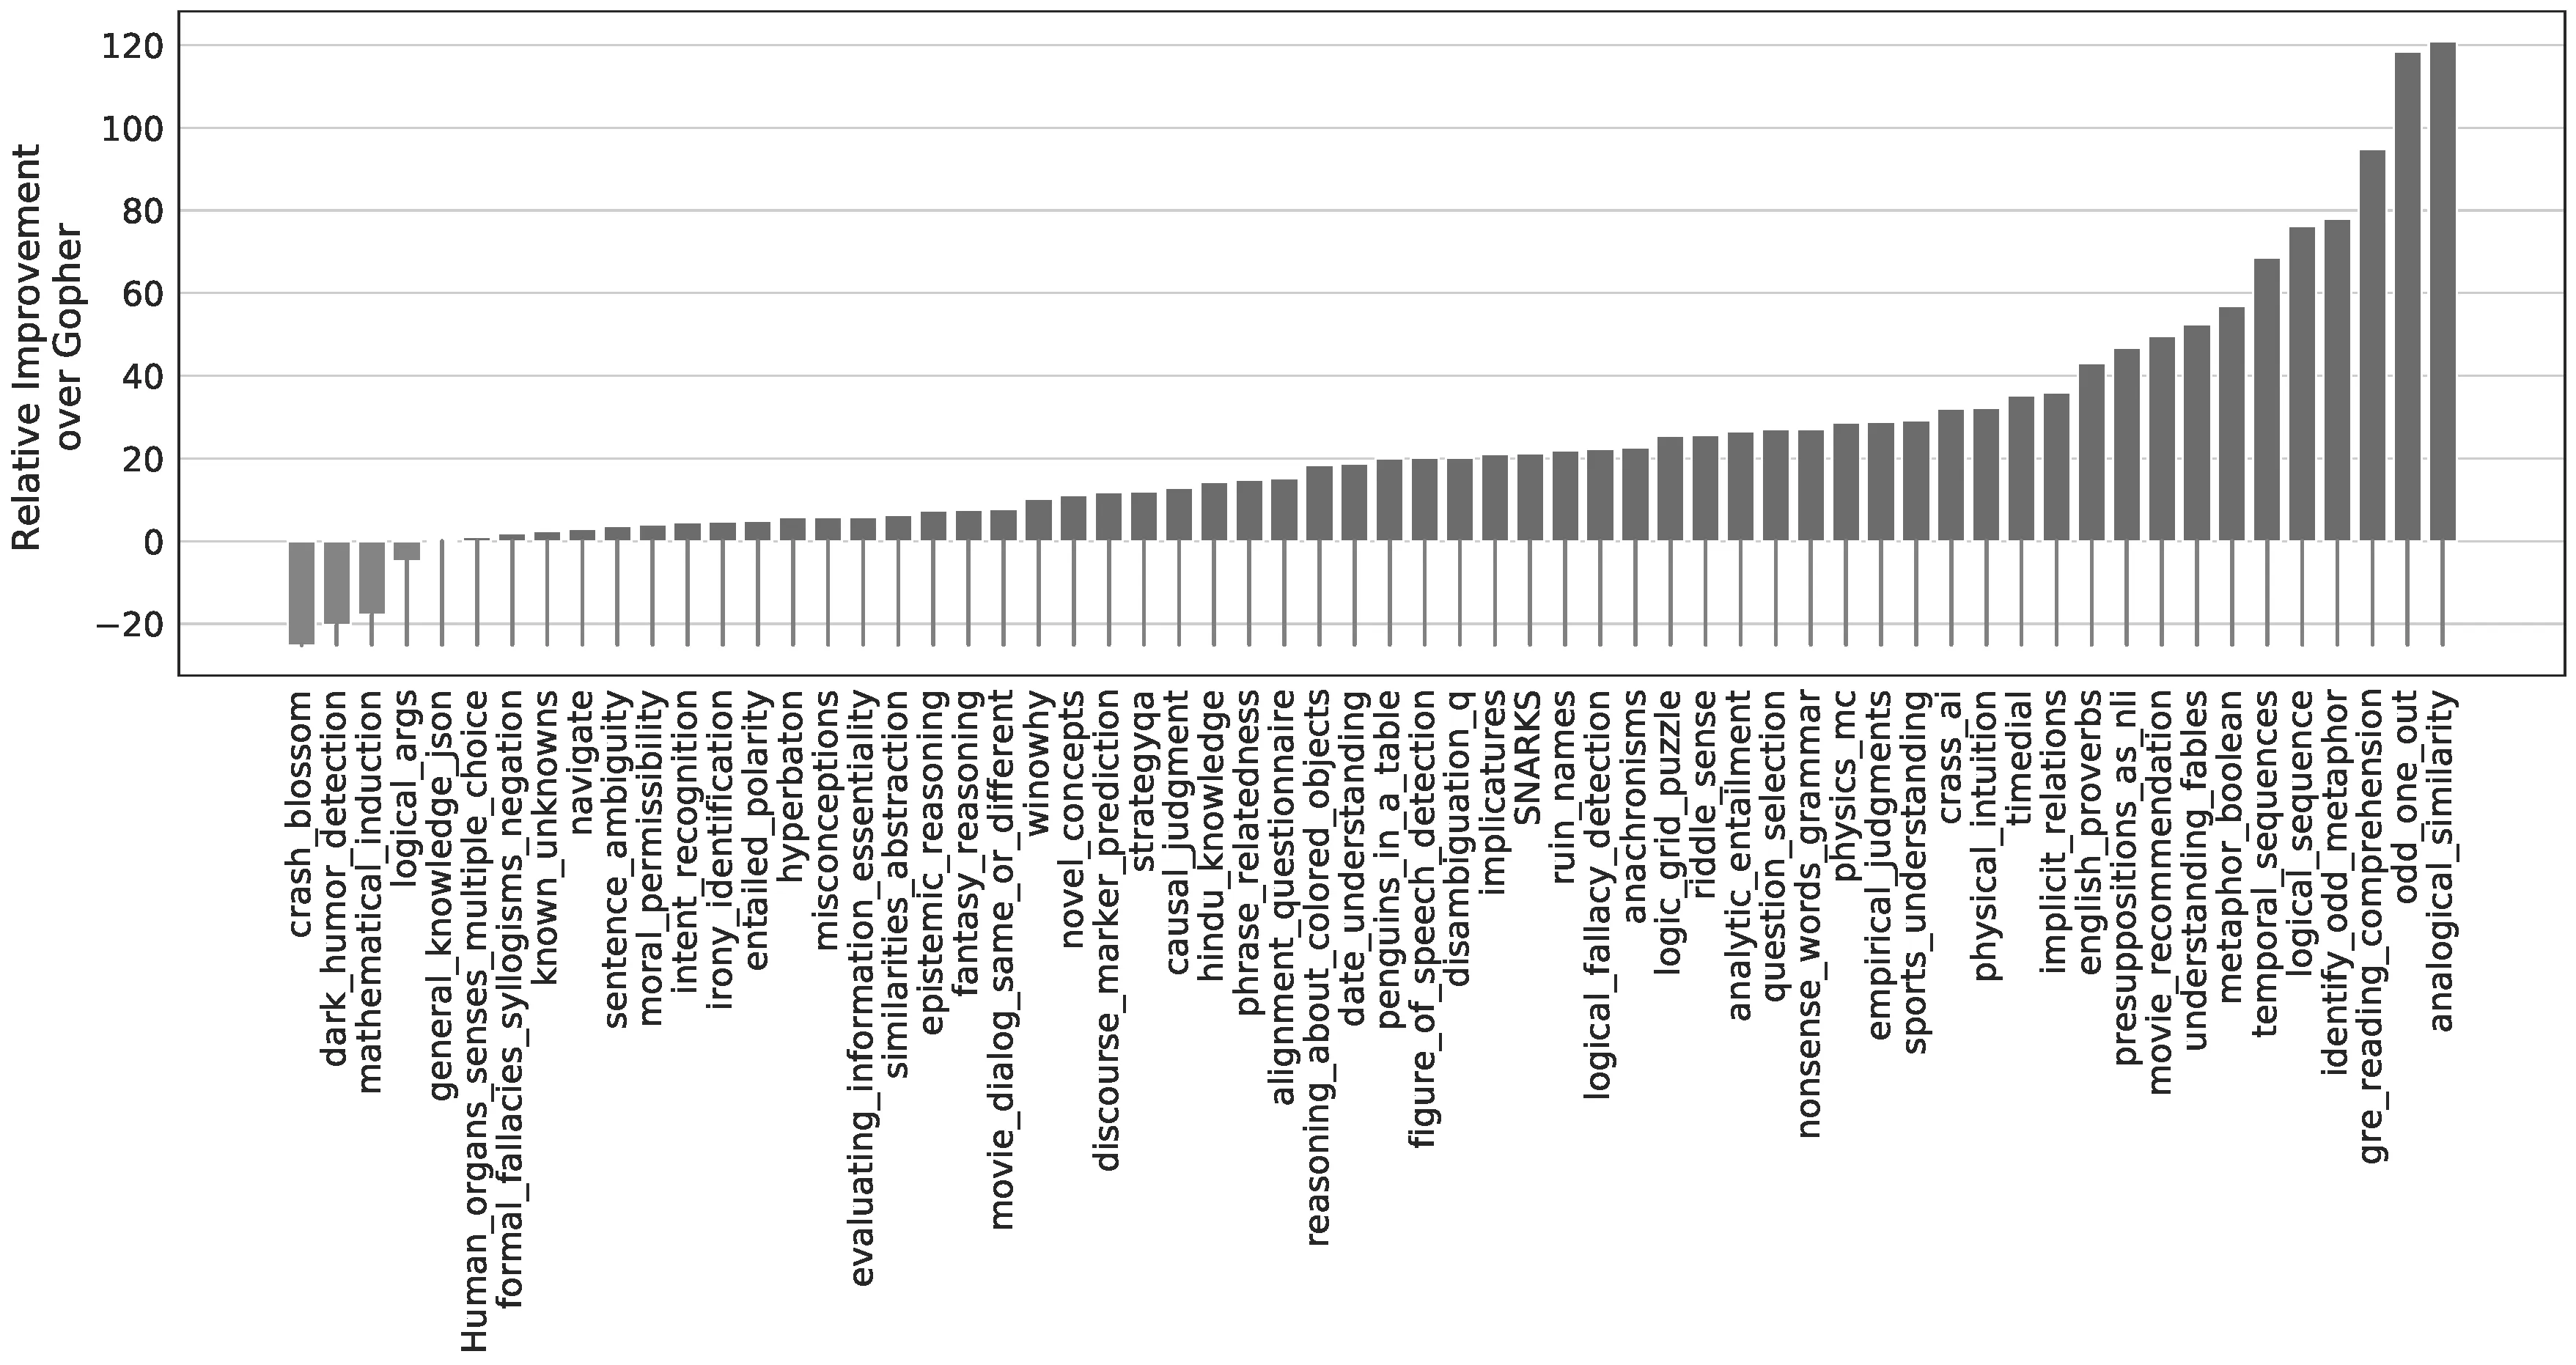
Chinchilla在BigBench任务上全面超越所有对比模型。
5.2 缩放定律验证
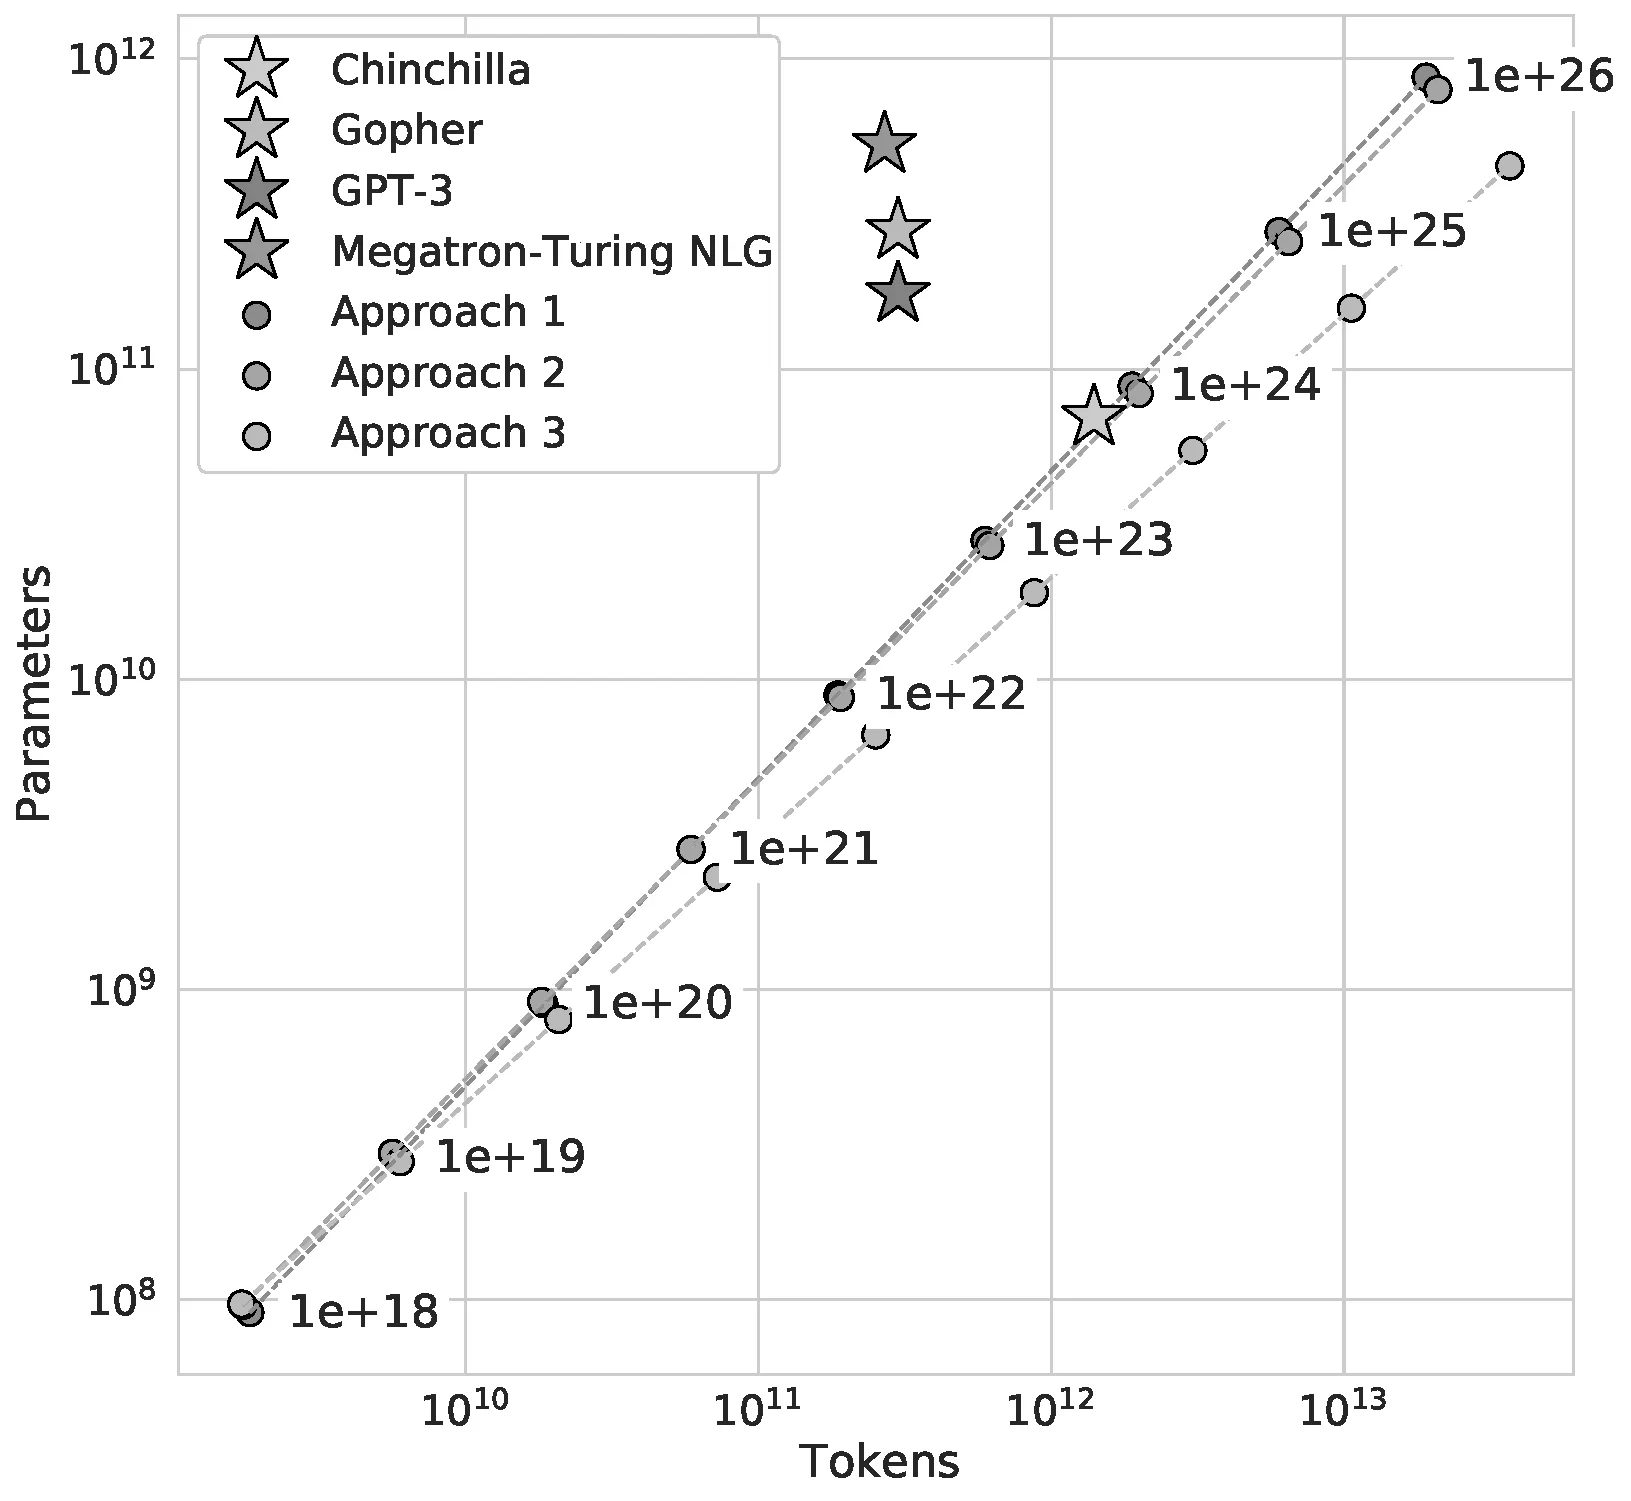
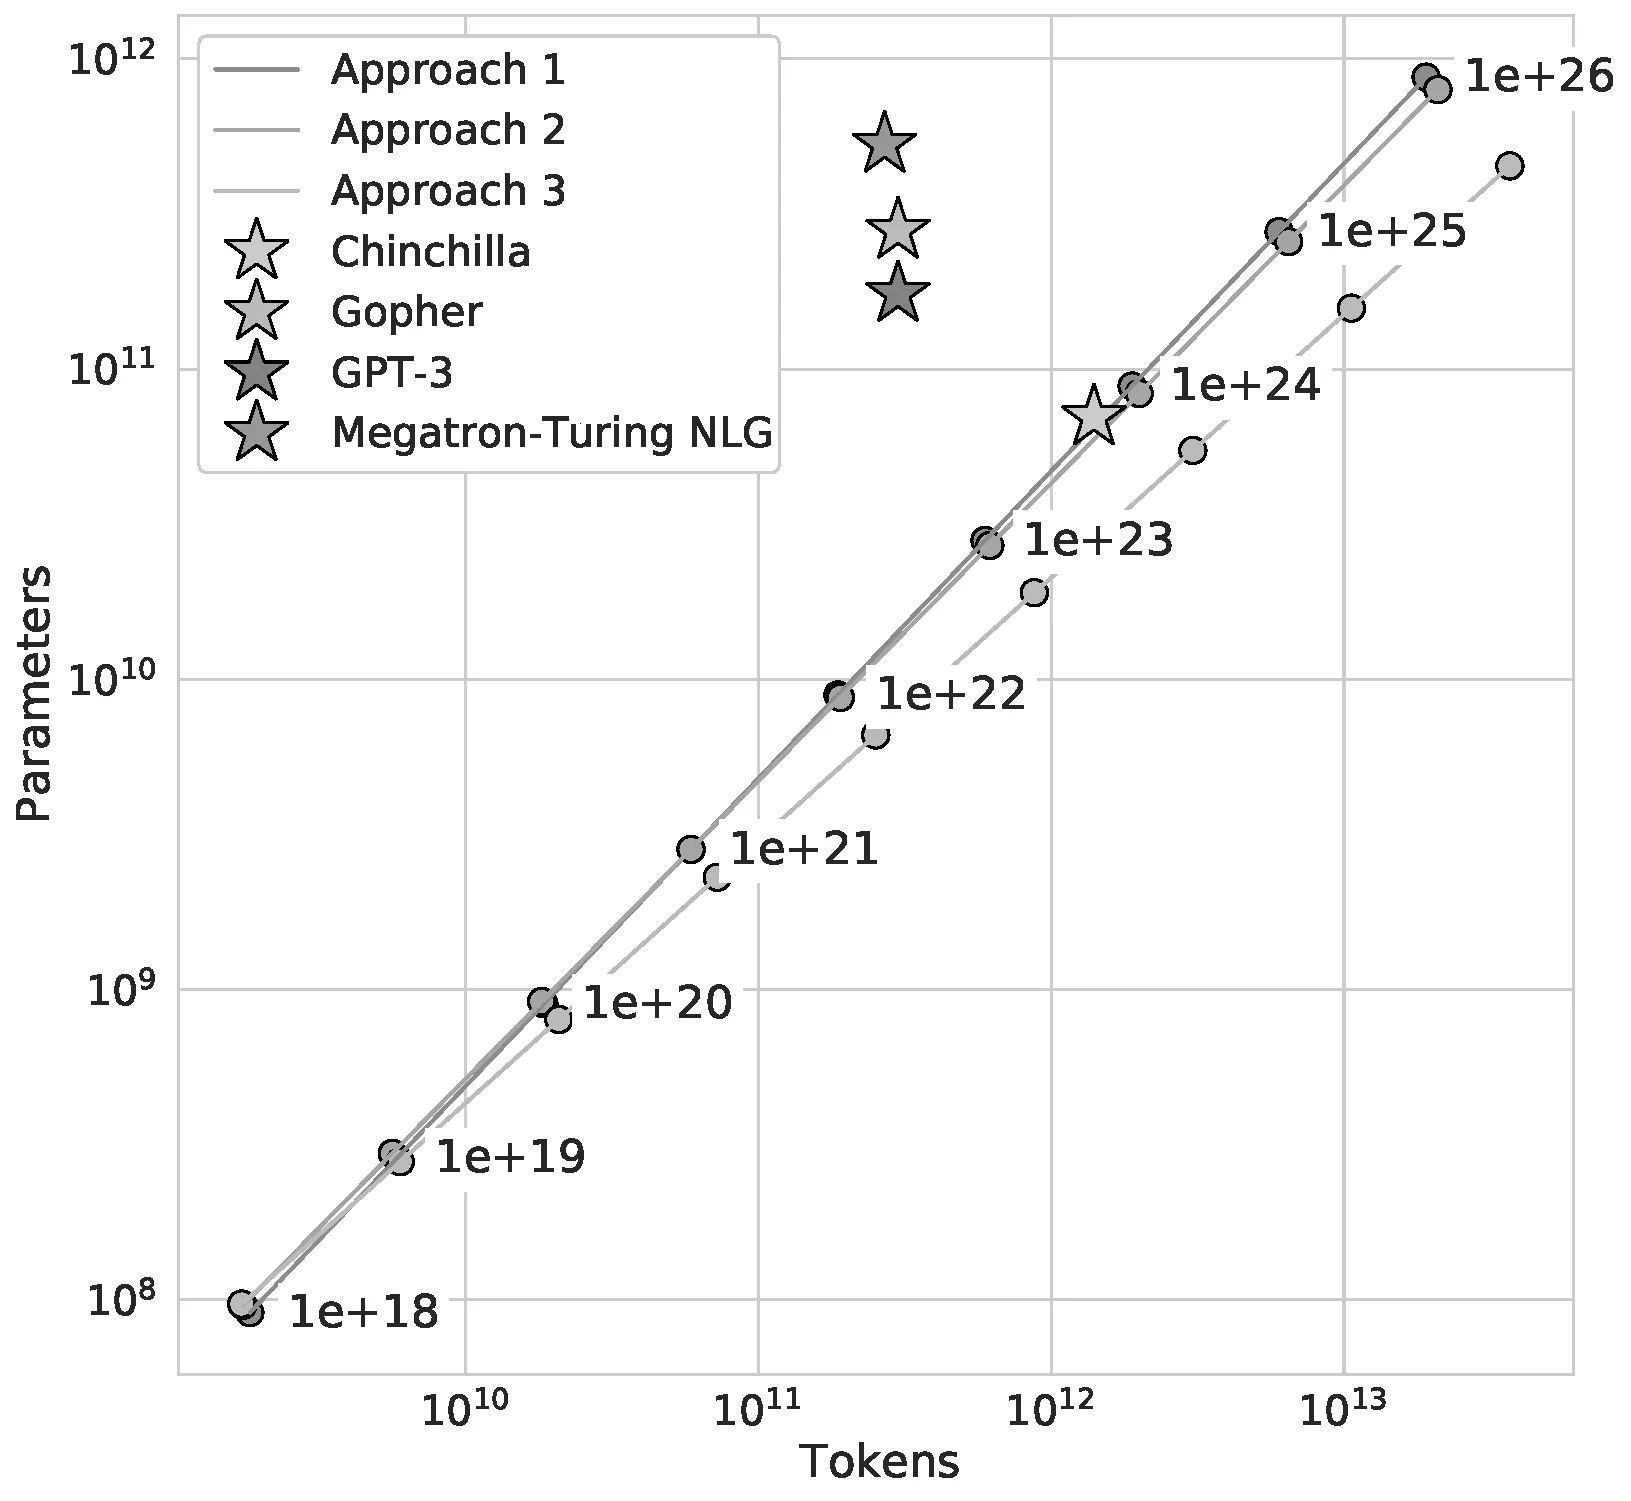
三种方法得到的最优缩放曲线高度一致,验证了和的结论。
5.3 消融实验
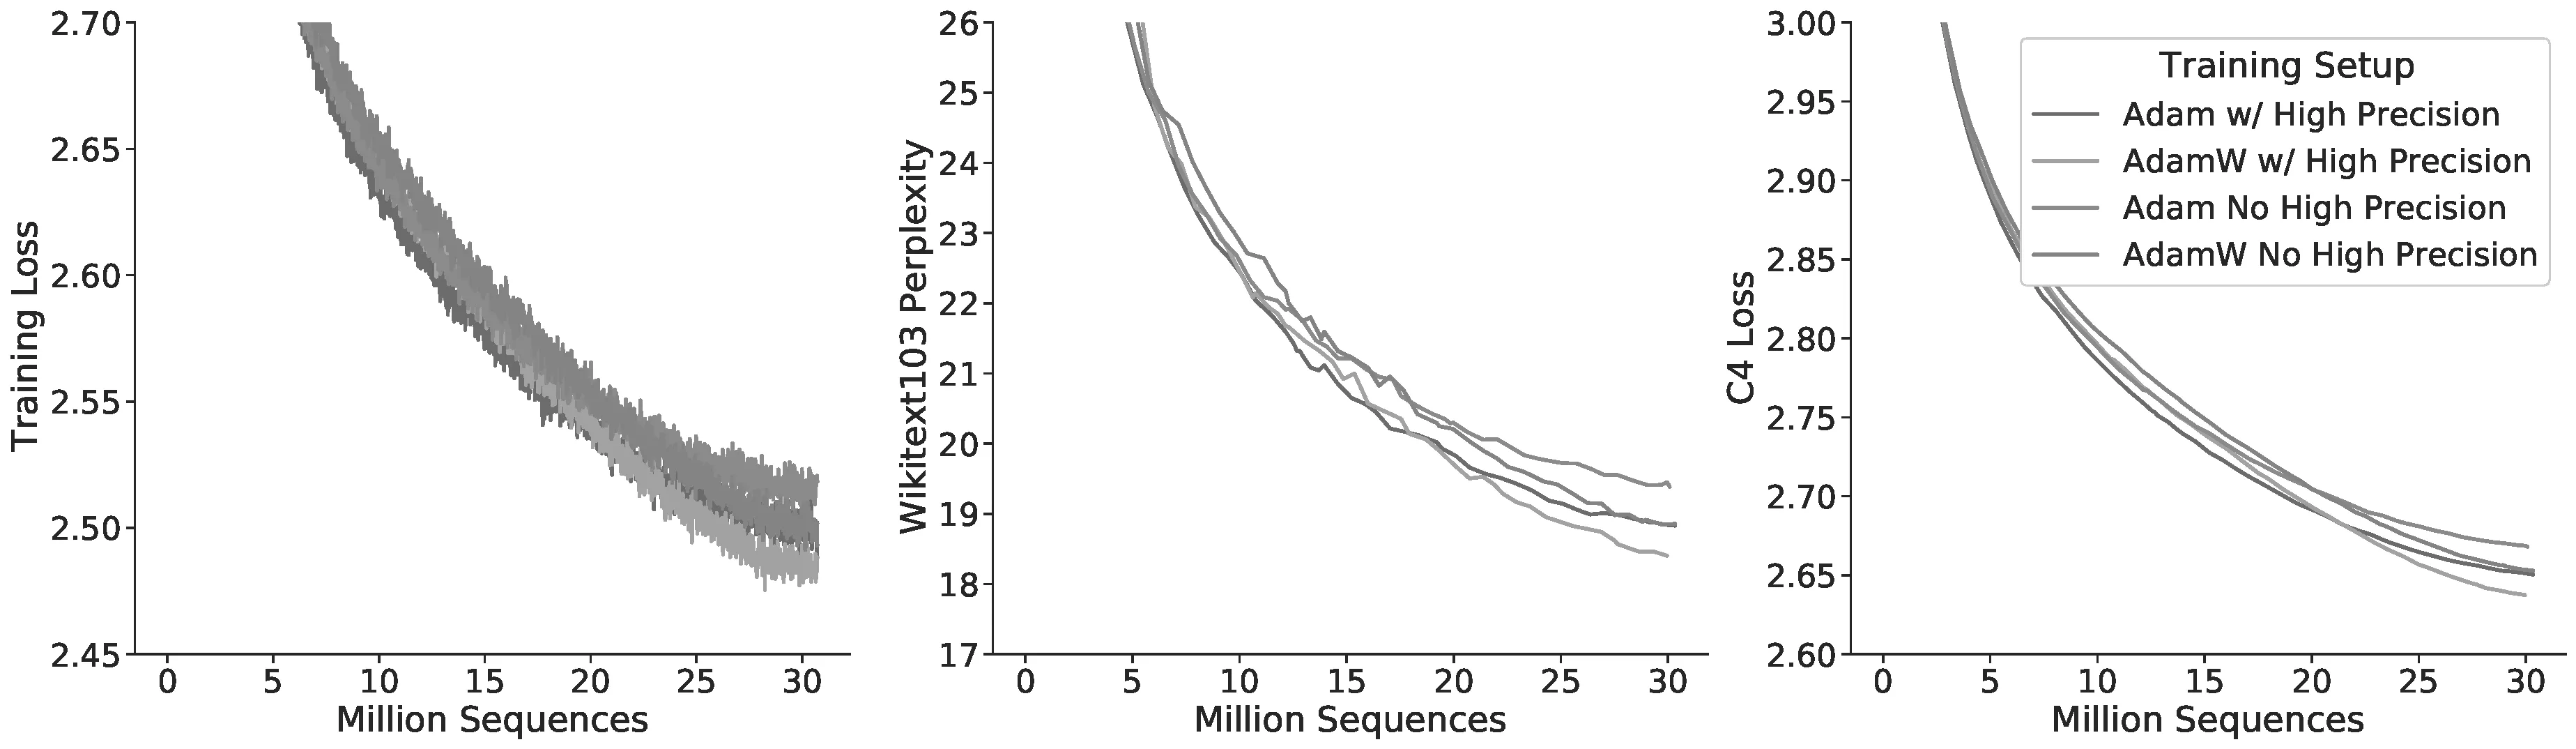
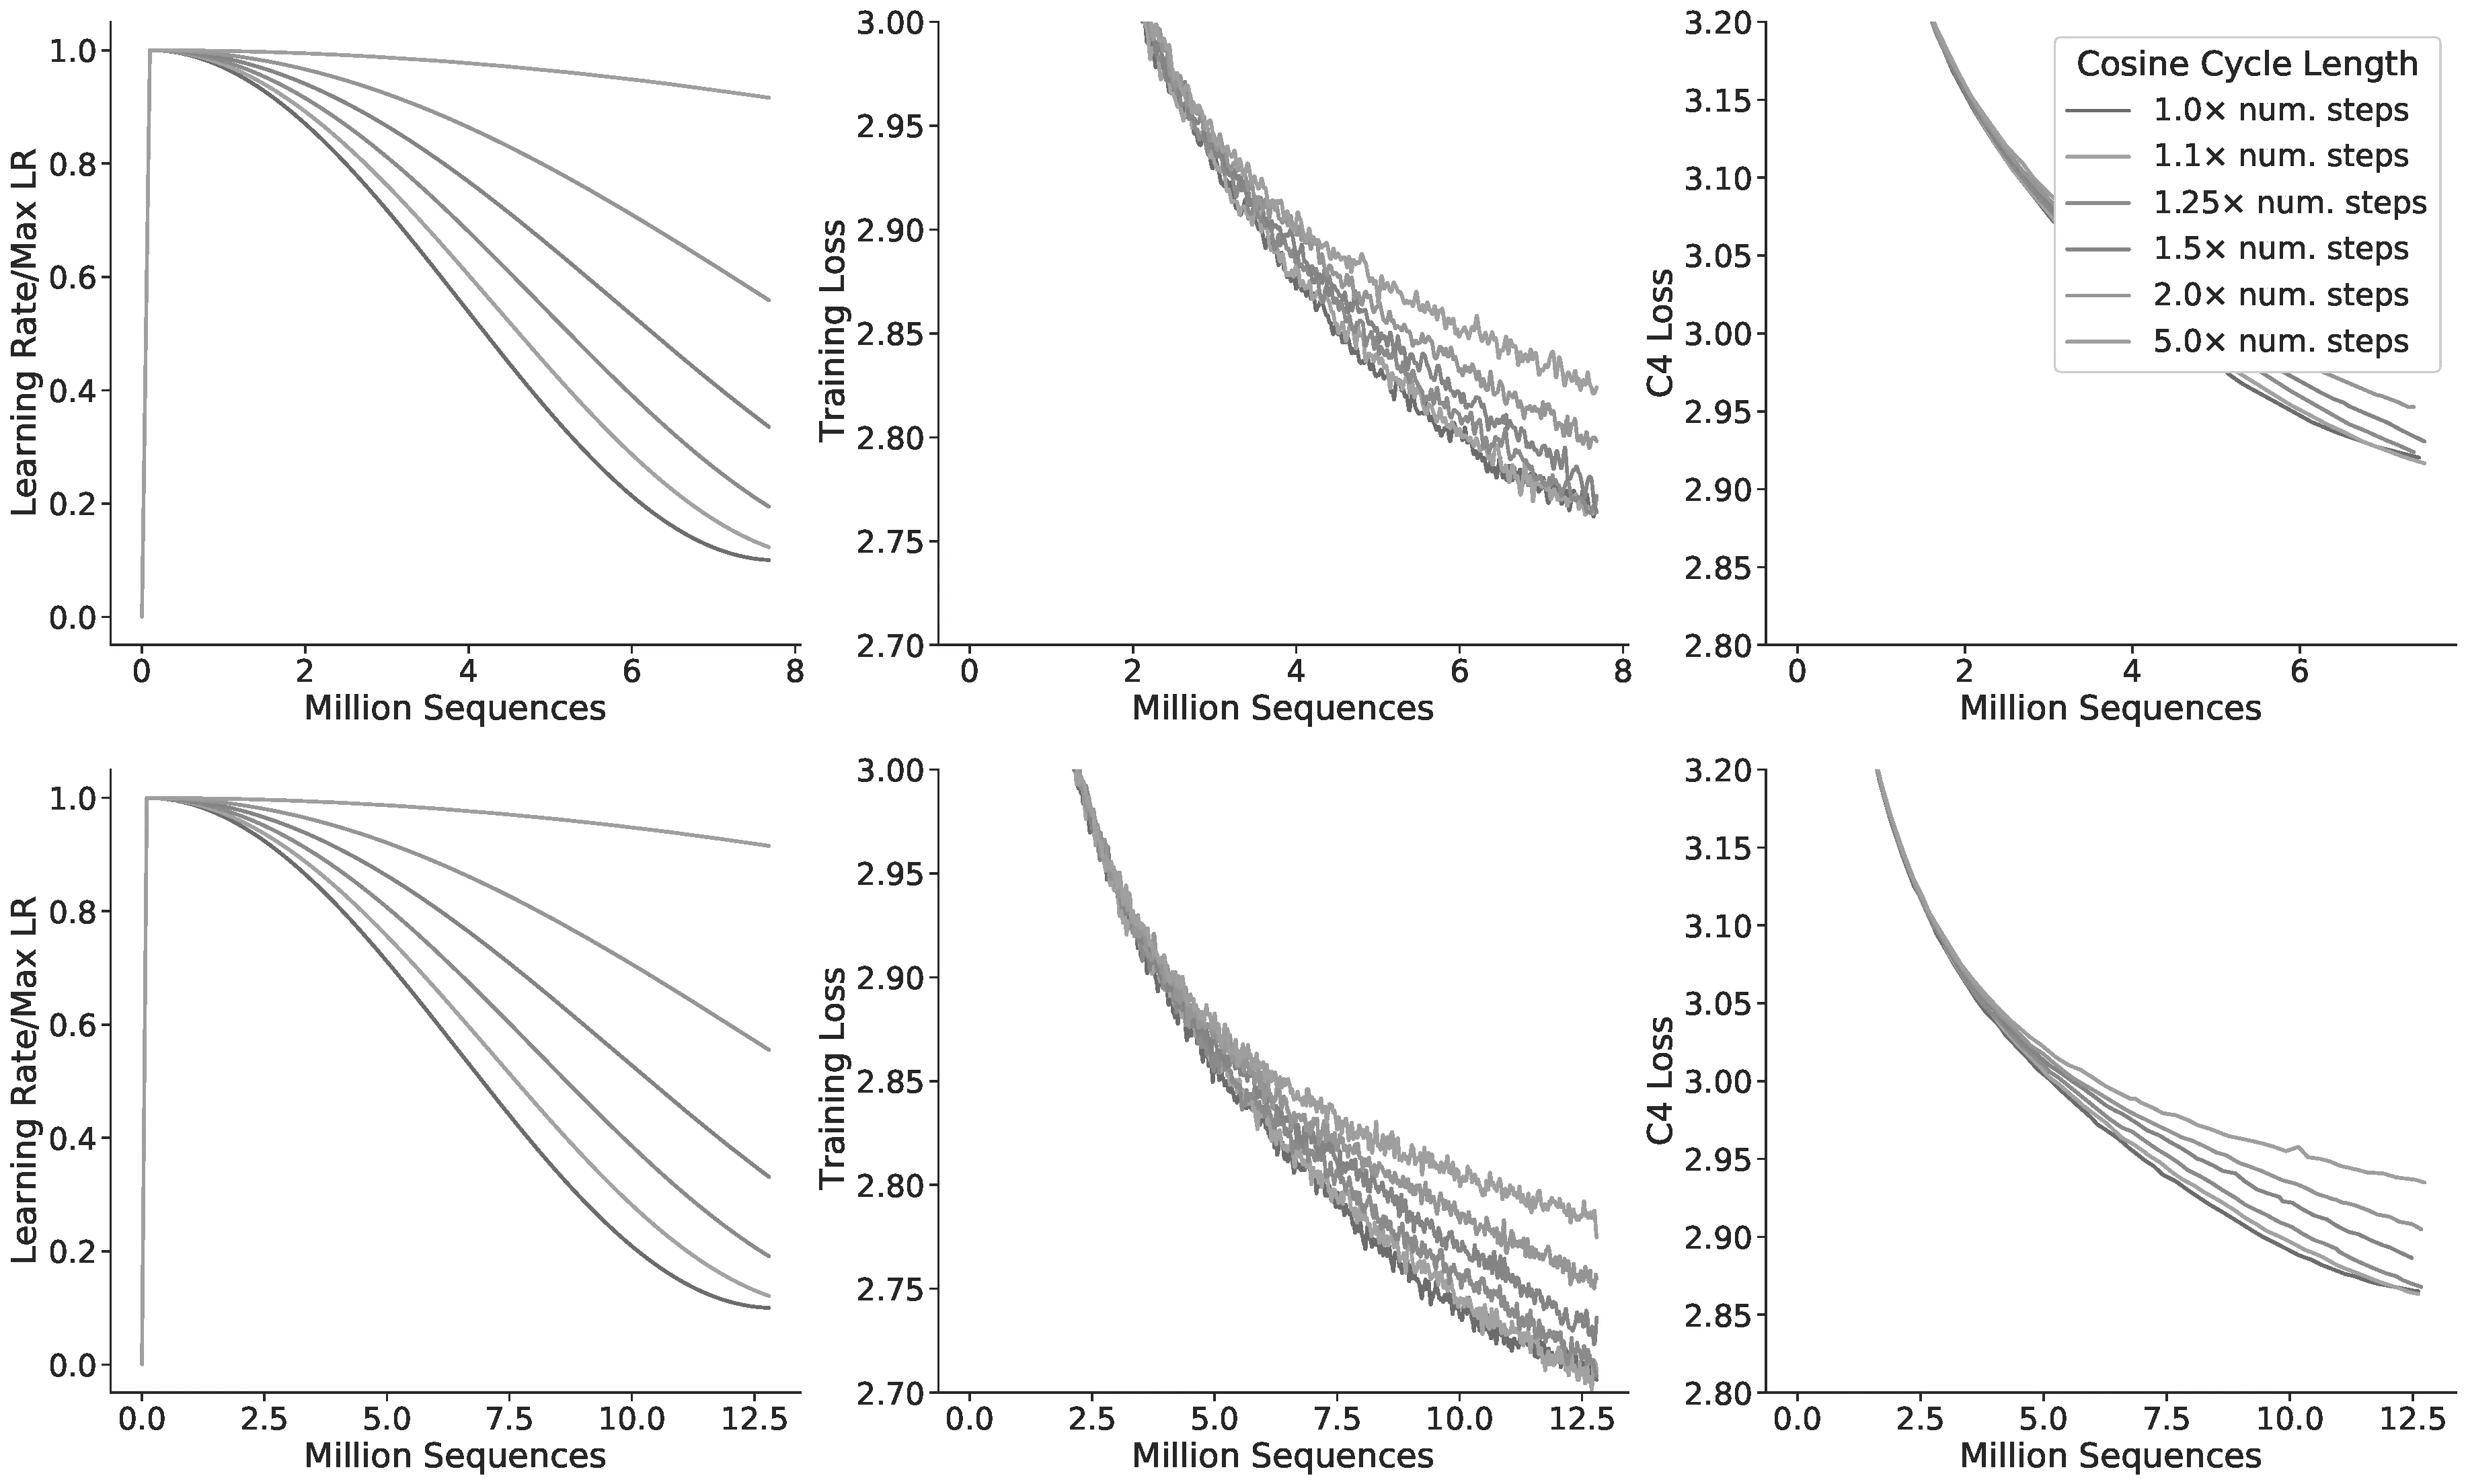
验证了缩放定律在不同数据集(The Pile)、优化器(Adam vs AdamW)、学习率调度(Cosine vs 其他)下的鲁棒性。
5.4 损失曲面曲率
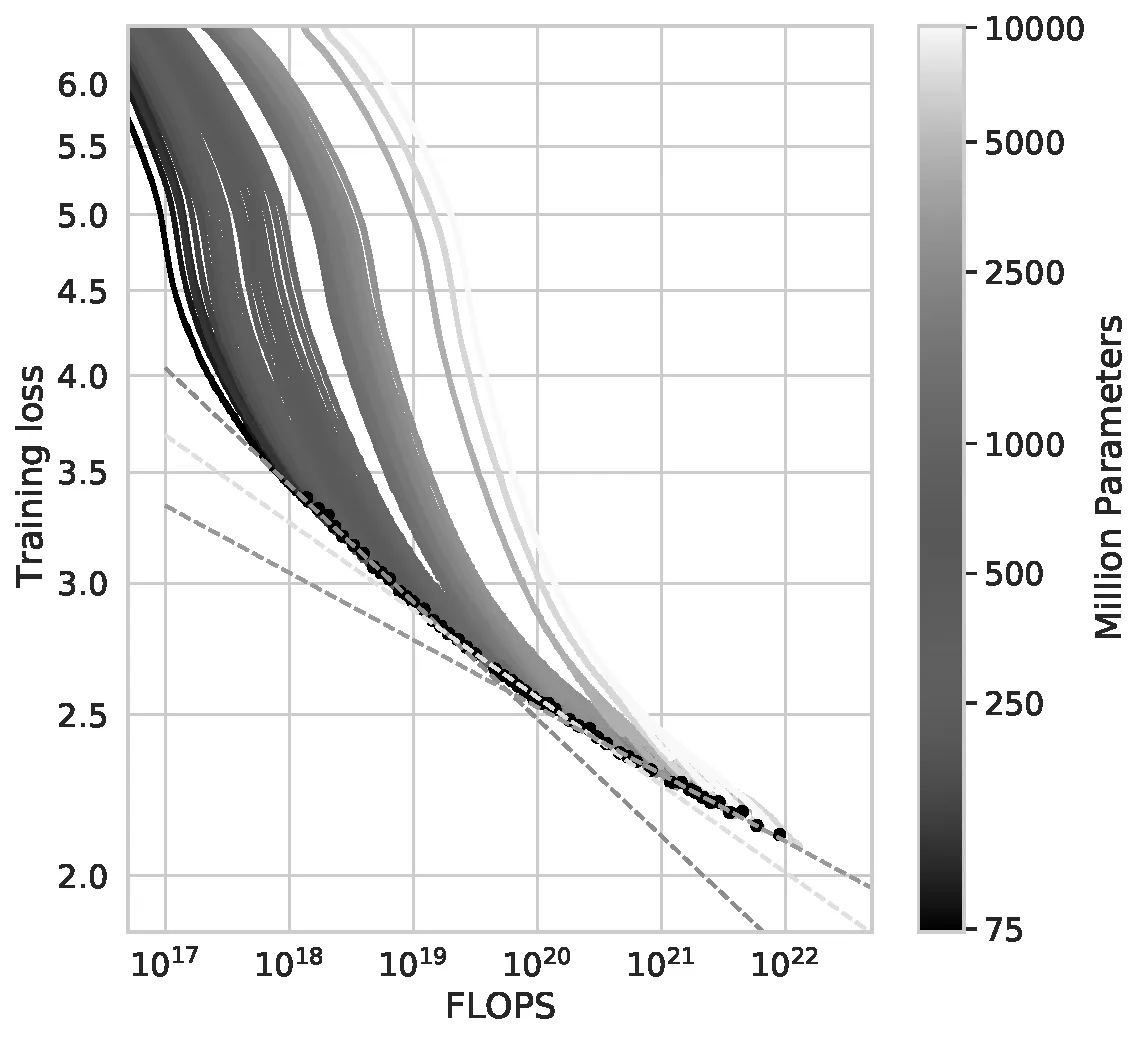
分析了FLOP-损失前沿的曲率,确认了幂律关系的适用性和局限性。
六、相关工作 (Related Work)
Kaplan et al. (2020)
- 首次发现语言模型损失与参数数量的幂律关系
- 建议给定计算预算增加时,模型大小应增加约5.5倍,token数仅增加1.8倍
- 本文反驳: 发现模型大小和token数应以相等比例缩放
其他相关工作
- PaLM: 540B参数模型,训练2T tokens,但未系统研究最优缩放
- Gopher: 280B参数,300B tokens,是本文主要对比基线
- GPT-3: 175B参数,300B tokens,广泛使用的基线模型
七、总结 (Conclusion)
7.1 核心成就
- 重新定义LLM缩放定律: 证明模型大小和训练token数应以同等比例(各约C^0.5)缩放,而非Kaplan等人提出的不同比例
- 发现LLM严重欠训练: 当前主流模型(Gopher、GPT-3等)在相同计算预算下被严重高估了模型大小
- Chinchilla的实践验证: 70B参数模型训练1.4T tokens,性能全面超越280B-530B的现有模型
- 三种独立方法的一致性: 固定模型变化token、IsoFLOP曲线、参数化损失拟合,结果高度一致
- 广泛的消融实验: 验证缩放定律在不同数据集、优化器、学习率调度下的鲁棒性
7.2 技术影响
- 指导未来模型设计: 在给定计算预算下,应优先考虑增加训练token数而非盲目扩大模型大小
- 降低部署成本: Chinchilla比Gopher小4倍,意味着更少的内存占用和推理成本
- 促进开源社区: 为开源LLM发展提供了明确的缩放方向
7.3 局限性
- 实验主要集中在C4数据集,需要验证在其他数据集上的普适性
- 未考虑MoE等稀疏架构的缩放行为
- 幂律关系在大模型尺寸下可能存在曲率,需要更多研究
- 训练token数的上限受限于数据集质量和多样性
八、参考资源 (References)
论文链接
关键参考文献
| 编号 | 论文 | 关键贡献 |
|---|---|---|
| [Kaplan] | Kaplan et al. (2020) | 首次发现LLM损失-参数幂律关系 |
| [Gopher] | Rae et al. (2021) | 280B参数模型,本文主要对比基线 |
| [GPT-3] | Brown et al. (2020) | 175B参数模型,广泛使用的基线 |
| [PaLM] | Chowdhery et al. (2022) | 540B参数模型 |
| [Jurassic-1] | Stormfront et al. (2021) | 178B参数模型 |
| [MT-NLG] | Shoeybi et al. (2020) | 530B参数模型 |
图表索引
| 图号 | 描述 | 文件名 |
|---|---|---|
| Figure 1 | 三种方法预测对比 | figure-1-combined-predictions.png |
| Figure 2 | IsoFLOP轮廓 | figure-2-isoflop-profiles.png |
| Figure 3 | 缩放定律 | figure-3-scaling-laws.png |
| Figure 4 | Token vs FLOPs | figure-4-tokens-vs-flops.png |
| Figure 5 | Token vs 参数 | figure-5-tokens-vs-params.png |
| Figure 6 | MMLU结果 | figure-6-mmlu-results.png |
| Figure 7 | BigBench结果 | figure-7-bigbench-results.png |
| Figure 8 | Chinchilla在The Pile上 | figure-8-chinchilla-on-pile.png |
| Figure 9 | 消融实验 | figure-9-ablation.png |
| Figure 10 | 曲率分析 | figure-10-curvature.png |
| Figure 11 | Cosine调度长度 | figure-11-cosine-schedule.png |
| Figure 12 | Adam vs AdamW | figure-12-adam-vs-adamw.png |
分析日期: 2026-07-07 分析师: AI Paper Analyzer