Communication-Efficient TeraByte-Scale Model Training Framework for Online Advertising
硬件感知的TB级CTR模型训练框架,通过k步模型合并和拓扑感知通信优化实现4倍加速
Communication-Efficient TeraByte-Scale Model Training Framework for Online Advertising
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Communication-Efficient TeraByte-Scale Model Training Framework for Online Advertising |
| 作者 | Weijie Zhao, Xuewu Jiao, Mingqing Hu, Xiaoyun Li, Xiangyu Zhang, Ping Li |
| 机构 | Baidu Research (Cognitive Computing Lab), Baidu Search Ads (Phoenix Nest) |
| 论文 | arXiv:2201.05500 |
| 代码 | PaddlePaddle深度学习平台 (www.paddlepaddle.org.cn) |
| 发布 | 2022年1月5日 |
| 许可 | arXiv非独家分发许可 |
二、核心思想
问题定义
在线广告系统中的点击率(CTR)预测是决定广告收入的关键组件。现代CTR模型面临两个核心挑战:
- 超大规模参数:模型需要处理100-1000亿维的稀疏输入特征(查询关键词、用户画像等),需要TB级参数进行嵌入
- 分布式训练瓶颈:传统的分布式参数服务器在多节点训练时面临严重的通信开销
两大挑战:
- 节点内通信:GPU、CPU、SSD之间频繁通信,硬件拓扑的非均匀性导致标准集合通信性能不佳
- 节点间通信:不同计算节点的GPU频繁同步参数,网络通信成为扩展性瓶颈
解决方案概述
论文提出硬件感知训练框架,将硬件拓扑融入算法设计,通过以下创新解决上述挑战:
- 核心绑定与SSD直连I/O:优化数据传输路径,减少NUMA跨socket通信
- 两阶段GPU通信算法:针对非均匀拓扑设计的高效GPU间通信
- k步模型合并算法:减少节点间同步频率,首次将k步自适应优化应用于工业级CTR训练
- GPUDirect RDMA:实现GPU直接跨节点通信,避免CPU介入
三、技术架构
整体框架图
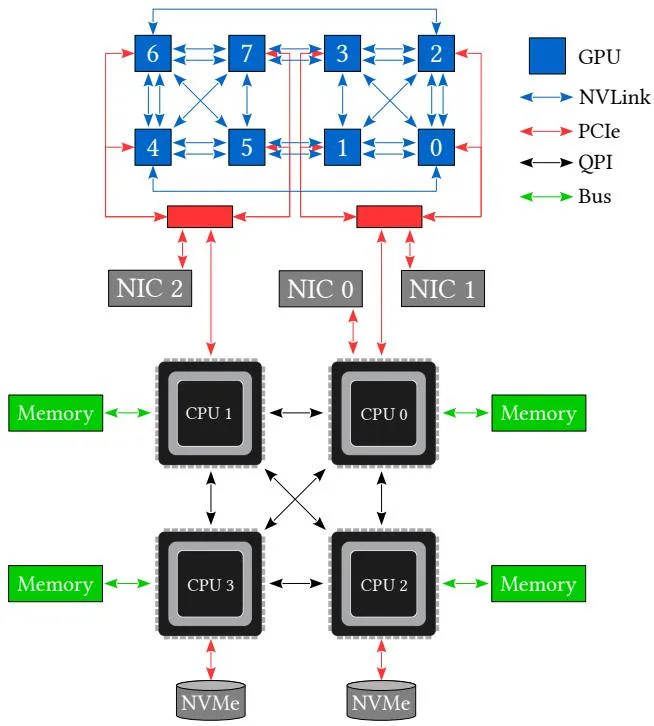
Figure 1: GPU节点硬件拓扑示例 - 显示NVLink、PCIe、QPI连接的非均匀带宽
┌─────────────────────────────────────────────────────────────┐
│                    硬件感知训练框架                            │
├─────────────────────────────────────────────────────────────┤
│                                                             │
│  输入: 稀疏特征 (100-1000亿维)                                │
│         ↓                                                   │
│  ┌─────────────────────────────────────────────┐            │
│  │           层次化GPU参数服务器                  │            │
│  │  ┌─────────────────────────────────────┐    │            │
│  │  │ GPU HBM: 热点参数缓存                │    │            │
│  │  │ CPU Memory: 温数据存储               │    │            │
│  │  │ SSD: 冷数据存储 (直连I/O)            │    │            │
│  │  └─────────────────────────────────────┘    │            │
│  └─────────────────────────────────────────────┘            │
│         ↓                                                   │
│  ┌─────────────────────────────────────────────┐            │
│  │           核心绑定优化                        │            │
│  │  - I/O核心绑定到设备所在NUMA节点             │            │
│  │  - 减少跨socket数据传输                      │            │
│  │  - SSD直连I/O绕过页面缓存                    │            │
│  └─────────────────────────────────────────────┘            │
│         ↓                                                   │
│  ┌─────────────────────────────────────────────┐            │
│  │           两阶段GPU通信                      │            │
│  │  Phase 1: 同socket GPU先聚合 (高带宽)       │            │
│  │  Phase 2: 跨socket GPU再聚合 (低带宽)       │            │
│  └─────────────────────────────────────────────┘            │
│         ↓                                                   │
│  ┌─────────────────────────────────────────────┐            │
│  │           k步模型合并                        │            │
│  │  - 每k步合并一次Adam状态                    │            │
│  │  - 减少节点间同步频率                        │            │
│  │  - 收敛性保证 (非凸优化)                     │            │
│  └─────────────────────────────────────────────┘            │
│         ↓                                                   │
│  输出: CTR预测模型                                           │
│                                                             │
└─────────────────────────────────────────────────────────────┘
CTR预测模型结构
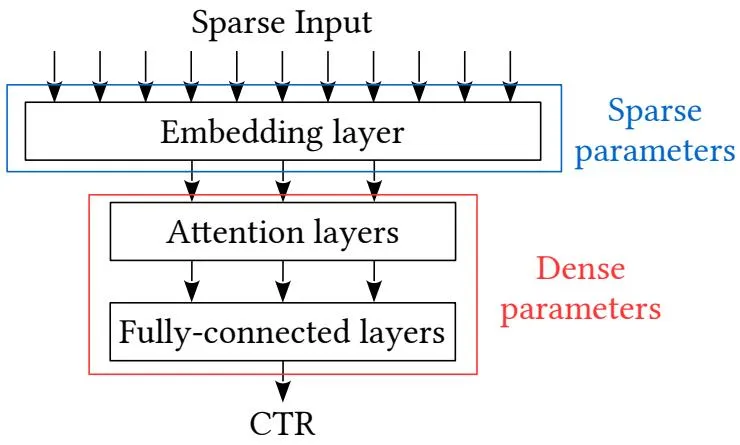
Figure 2: CTR预测模型结构 - 包含嵌入层、注意力组件和多层感知机
模型采用典型的工业级CTR架构:
- 嵌入层:将高维稀疏输入映射到低维稠密表示(~100维)
- 注意力组件:捕捉特征交互
- 多层感知机:非线性变换
- 输出层:sigmoid预测点击概率
核心公式
1. k步Adam优化器状态合并:
\theta_{t+k} = \theta_t - \eta \cdot \frac{\sqrt{v_{t+k} - v_t} + \epsilon}{\sqrt{m_{t+k} - m_t} + \epsilon} \cdot (m_{t+k} - m_t) \tag{1}
其中:
- :模型参数
- :一阶矩估计(动量)
- :二阶矩估计(自适应学习率)
- :学习率
- :数值稳定性项
2. 收敛性定理(Theorem 1):
对于非凸优化问题,k步Adam的收敛率为:
\frac{1}{T} \sum_{t=1}^{T} \mathbb{E}[\|\nabla f(\theta_t)\|^2] \leq O\left(\frac{1}{\sqrt{T}} + \frac{\sigma}{\sqrt{k}}\right) \tag{2}
3. 推论(Corollary 1):
当时,收敛率与标准Adam相同:
\frac{1}{T} \sum_{t=1}^{T} \mathbb{E}[\|\nabla f(\theta_t)\|^2] \leq O\left(\frac{1}{\sqrt{T}}\right) \tag{3}
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 嵌入层 | 处理100-1000亿维稀疏特征 | TB级参数,存储在GPU HBM/CPU/SSD |
| 注意力组件 | 捕捉特征间交互关系 | 多头注意力机制 |
| MLP | 非线性特征变换 | 多层全连接网络 |
| 输出层 | sigmoid预测CTR | 二分类输出 |
训练流程
-
数据预处理:
- 百度搜索广告生产系统真实数据
- 稀疏特征编码:查询关键词、用户画像等
- 特征维度:100-1000亿维
-
模型配置:
- 嵌入维度:~100维
- 参数规模:10+ TB
- 优化器:Adam (k步合并版本)
-
分布式架构:
- 层次化GPU参数服务器
- 1-8个计算节点
- 每节点8个GPU (NVIDIA V100)
- NVLink + PCIe + QPI连接
-
优化策略:
- 核心绑定:I/O核心绑定到设备NUMA节点
- SSD直连I/O:绕过页面缓存,直接读写
- 两阶段GPU通信:拓扑感知的集合通信
- GPUDirect RDMA:GPU直接跨节点通信
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 硬件感知训练 | 将硬件拓扑融入算法设计,优化数据传输路径 | 论文首次提出,实验验证有效 |
| 核心绑定 | I/O核心绑定到设备所在NUMA节点,减少跨socket通信 | 拉取阶段加速15% |
| SSD直连I/O | 绕过页面缓存,直接读写SSD | 减少CPU开销,提升I/O效率 |
| 两阶段GPU通信 | 先同socket聚合,再跨socket聚合,适应非均匀拓扑 | 节点内GPU通信减少90% |
| GPUDirect RDMA | GPU直接跨节点通信,避免CPU介入 | 2节点减少87%通信,4节点减少84% |
| k步模型合并 | 每k步合并一次Adam状态,减少同步频率 | 首次应用于工业级CTR训练 |
| 收敛性保证 | 理论证明k步Adam在非凸优化中的收敛率 | Theorem 1 & Corollary 1 |
五、代码实现分析
系统架构
论文基于百度PaddlePaddle深度学习平台实现,部署在百度搜索广告生产系统。
关键优化实现
-
核心绑定:
// 将I/O线程绑定到设备所在NUMA节点 cpu_set_t cpuset; CPU_ZERO(&cpuset); CPU_SET(device_num * threads_per_device + i, &cpuset); pthread_setaffinity_np(thread, sizeof(cpu_set_t), &cpuset); -
两阶段GPU通信:
// Phase 1: 同socket GPU聚合 for (int socket = 0; socket < num_sockets; socket++) { intra_socket_allreduce(gpu_in_socket[socket]); } // Phase 2: 跨socket聚合 inter_socket_allreduce(gpu_leaders); -
k步模型合并:
# 每k步合并一次Adam状态
for step in range(total_steps):
    local_update(model, batch)
    if step % k == 0:
        # 合并所有worker的Adam状态
        merged_m = all_reduce(local_m)
        merged_v = all_reduce(local_v)
        # 应用合并后的更新
        apply_adam_update(model, merged_m, merged_v)
六、实验结果
基准测试
实验环境:
- 硬件:NVIDIA V100 GPU (32GB HBM)
- 节点数:1-8个计算节点
- 每节点:8个GPU
- 网络:100Gbps RDMA
- 数据:百度搜索广告生产系统真实数据
核心绑定与SSD I/O
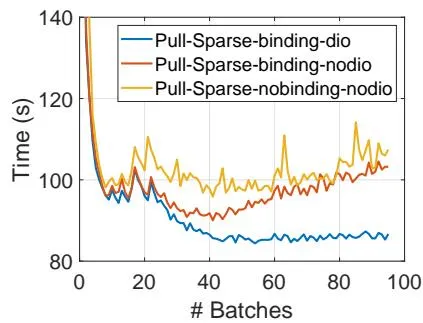
Figure 5: 左:所有优化后的时间分布;右:核心绑定与SSD直连I/O的加速效果
关键发现:
- 核心绑定优化拉取稀疏参数阶段约15%
- SSD直连I/O减少页面缓存开销
- 整体I/O效率提升显著
GPU通信优化
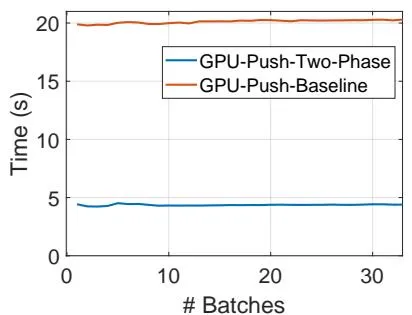
Figure 6: 两阶段GPU通信的拉取/推送操作时间
节点内GPU通信:
- 两阶段通信算法减少约90% GPU通信时间
- 适应NVLink非均匀带宽拓扑
- 同socket内高带宽聚合,跨socket低带宽聚合
GPUDirect RDMA
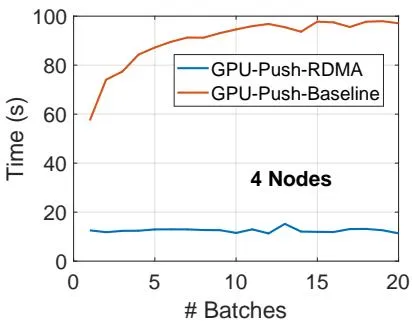
Figure 7: 有/无RDMA的推送操作时间
节点间通信:
- 2节点设置:减少87%通信
- 4节点设置:减少84%通信
- GPU直接通信,避免CPU介入
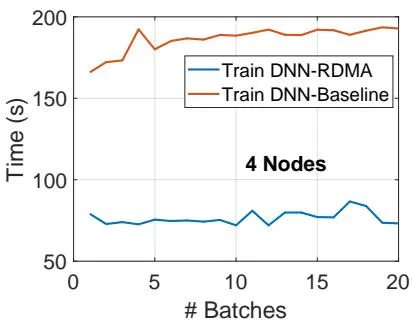
Figure 8: 有/无RDMA的整体DNN训练时间
整体加速:
- 2节点:训练时间减少54%
- 4节点:训练时间进一步减少
- 扩展性显著提升
k步模型合并
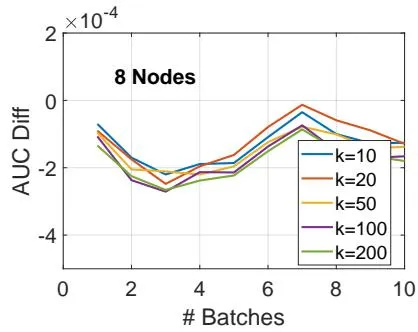
Figure 9: k步通信高效训练 - 左:AUC vs训练批次;右:AUC差异
精度验证:
- k从10到200变化时,AUC几乎无差异
- AUC差异在0.0002%范围内波动
- 统计上可忽略不计的精度损失
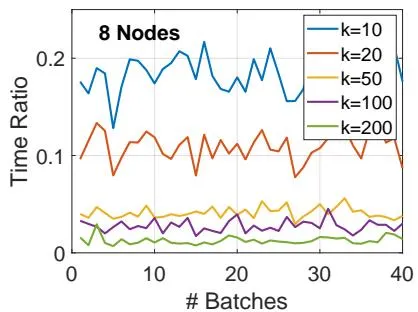
Figure 10: 左:k步训练时间;右:通信时间比例
执行时间:
- k=200时减少25%执行时间
- 通信时间近似线性减少
- k=10: 18.1%, k=20: 10.8%, k=50: 6.4%, k=100: 2.8%, k=200: 1.2%
消融实验
| 优化技术 | 加速效果 | 说明 |
|---|---|---|
| 核心绑定 | 15% | 拉取稀疏参数阶段 |
| 两阶段GPU通信 | 90% | 节点内GPU通信 |
| GPUDirect RDMA (2节点) | 87% | 节点间通信 |
| GPUDirect RDMA (4节点) | 84% | 节点间通信 |
| k步合并 (k=200) | 25% | 整体执行时间 |
| 综合优化 | 4倍+ | 整体训练加速 |
定性分析
硬件拓扑感知:
- 标准集合通信不感知拓扑,性能次优
- 两阶段通信适应NVLink非均匀带宽
- 核心绑定减少NUMA跨socket通信
k步合并的实用性:
- 工业级CTR训练首次应用
- 保持Adam自适应学习率优势
- 理论收敛性保证
七、相关工作
前序工作
- 参数服务器(Valiant, 1990; Ho et al., 2013):分布式机器学习基础架构
- GPU参数服务器(Zhao et al., 2020):层次化GPU参数服务器,处理GPU内存不足
- Adam优化器(Kingma & Ba, 2015):自适应学习率方法
- 本地SGD(McMahan et al., 2017):减少通信频率的经典方法
同期工作
- FlexPS(Huang et al., 2018):灵活并行度控制
- Parameter Hub(Luo et al., 2018):机架级参数服务器
- GPUs(Cui et al., 2016):可利用有界陈旧性加速分析
后续影响
- 大规模CTR训练:为工业级广告系统提供高效训练方案
- 硬件感知算法:启发更多拓扑感知的分布式训练研究
- k步自适应优化:扩展到其他自适应优化器(AdaGrad, RMSProp等)
八、总结
核心贡献
- 硬件感知训练框架:首次将硬件拓扑融入算法设计,实现TB级模型高效训练
- k步Adam合并算法:首次应用于工业级CTR训练,提供非凸优化收敛性保证
- 两阶段GPU通信:针对NVLink非均匀拓扑设计,减少90%节点内通信
- GPUDirect RDMA优化:实现GPU直接跨节点通信,减少84-87%节点间通信
- 核心绑定与SSD直连I/O:优化数据传输路径,提升I/O效率
- 综合加速4倍+:在保持精度的前提下显著提升训练速度
技术影响
- 工业应用:已部署在百度搜索广告生产系统,取得良好效果
- 学术贡献:为大规模分布式训练提供硬件感知优化范式
- 开源生态:基于PaddlePaddle平台,促进社区发展
- 方法论:证明硬件拓扑感知对分布式训练的重要性
局限性
- 硬件依赖:优化针对特定GPU拓扑(NVLink + PCIe + QPI),其他硬件可能需要重新设计
- 超参数敏感:k值选择需要权衡通信减少与收敛速度
- 数据依赖:实验基于百度广告数据,其他场景可能有不同表现
- 扩展性:虽然展示了1-8节点的扩展性,但更大规模(100+节点)的验证有限
- 理论简化:收敛性分析假设了理想的通信模型,实际系统可能有更多复杂性