Scaling Laws for Neural Language Models
神经语言模型的缩放定律:模型大小、数据集大小和计算量与损失之间的幂律关系
Scaling Laws for Neural Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Scaling Laws for Neural Language Models |
| 作者 | Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, Dario Amodei |
| 机构 | Johns Hopkins University, OpenAI |
| 论文 | arXiv:2001.08361 |
| 发布 | 2020年1月23日 |
| 主题 | Machine Learning (cs.LG); Machine Learning (stat.ML) |
| 页数 | 19页,15张图 |
二、核心思想
问题定义
语言模型的性能如何随模型大小、数据集大小和训练计算量变化?是否存在可预测的定量规律,能够指导大规模模型的训练资源分配?
解决方案概述
本文通过大规模实证研究,发现语言模型的交叉熵损失与模型参数量 N、数据集大小 D、训练计算量 C 之间存在幂律关系(power-law),这些趋势跨越超过七个数量级。基于这些缩放定律,论文推导出在固定计算预算下的最优资源分配策略。
关键发现总结
- 性能强烈依赖规模,弱依赖模型形状: 参数量 N、数据集 D、计算量 C 是决定性能的三个核心因素,网络宽度/深度等架构细节影响极小
- 平滑幂律: 损失与 N、D、C 各自呈幂律关系,跨越六个数量级无偏离
- 过拟合的普适性: N 和 D 同步增长时性能可预测提升,过拟合惩罚取决于 N^{0.74}/D
- 训练的普适性: 训练曲线遵循可预测的幂律,参数大致独立于模型大小
- 大模型更高效: 大模型在样本效率上显著优于小模型
- 收敛是低效的: 最优计算效率训练需要训练非常大的模型并在收敛前停止
三、核心技术
计算量估计
对于 Transformer 模型,每个训练 token 的非嵌入计算量:
其中 B 是批大小,S 是训练步数。因子 6 来自前向传播(2N)+ 反向传播(4N)。
参数量公式(标准配置 d_attn = d_ff/4 = d_model):
核心缩放定律
定律 1: 损失 vs 模型大小 L(N)
当模型在足够大的数据集上训练至收敛:
| 参数 | 值 | 说明 |
|---|---|---|
| 0.076 | 幂律指数 | |
| 非嵌入参数 |
定律 2: 损失 vs 数据集大小 L(D)
大模型在有限数据集上早停训练:
| 参数 | 值 | 说明 |
|---|---|---|
| 0.095 | 幂律指数 | |
| tokens |
定律 3: 损失 vs 计算量 L(C_min)
最优分配计算预算:
| 参数 | 值 | 说明 |
|---|---|---|
| 0.050 | 幂律指数 | |
| PF-days |
组合缩放方程
L(N, D) 方程(核心方程):
L(N, S) 方程:
其中 ,。
临界批大小
| 参数 | 值 | 说明 |
|---|---|---|
| tokens | ||
| 0.21 | 幂律指数 |
临界批大小每损失降低约 13% 翻倍。
过拟合控制
为避免过拟合(训练在收敛的 0.02 以内):
关键含义: 每次模型大小增加 8x,数据只需增加约 5x 即可避免过拟合。数据集大小可以亚线性增长。
最优计算分配
在固定计算预算 C 下的最优分配:
关键含义: 随着计算预算增加,应主要增大模型大小 N,批大小 B 也相应增大,而串行训练步数 S 几乎不变。
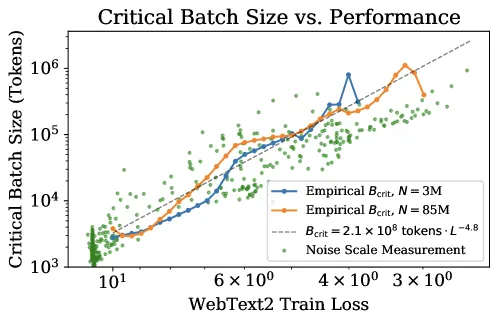
Figure 14: 最优模型大小和串行步数 vs 计算预算
关键交汇点
论文预测了一个关键交汇点:
这可能代表 Transformer 语言模型达到最大性能的点,也提供了自然语言每 token 熵的粗略估计。
四、实验设置
模型架构
- 架构: Decoder-only Transformer
- 上下文长度: n_ctx = 1024 tokens
- 词表大小: 50,257(BPE)
- 模型大小范围: 768 到 15 亿非嵌入参数
训练配置
| 配置 | 值 |
|---|---|
| 优化器 | Adam(小模型)/ Adafactor(>1B 参数) |
| 训练步数 | 250,000 步 |
| 批大小 | 512 序列 × 1024 tokens |
| 学习率调度 | 3000 步线性预热 + 余弦衰减至零 |
数据集
- WebText2: Reddit 出站链接(2018年10月前,最低 3 karma)
- 2030 万文档,96 GB 文本
- 词, tokens
- tokens 用于测试集
五、核心实验结果
缩放定律总结
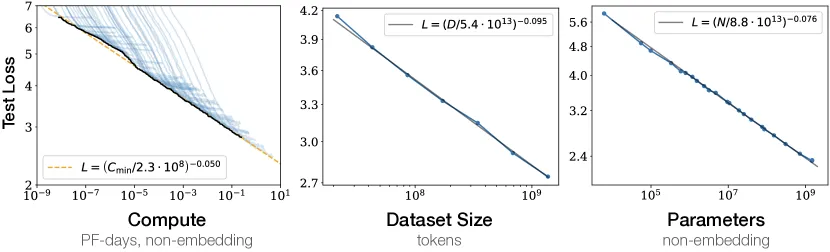
Figure 1: 简单幂律总结——损失 vs 模型大小、数据集大小和计算量
模型形状无关性
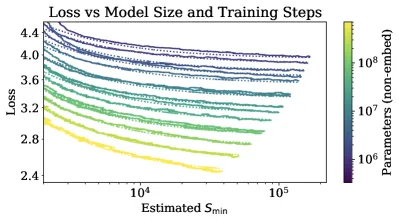
Figure 5: 性能对超参数调优的弱依赖(纵横比变化 40 倍)
关键发现: 当总参数量 N 固定时,Transformer 性能对 n_layer、n_heads、d_ff 等形状参数的依赖非常微弱。纵横比变化 40 倍仅轻微影响性能;(6, 4288) 配置的损失仅比 GPT-2 使用的 (48, 1600) 高 3%。
训练曲线
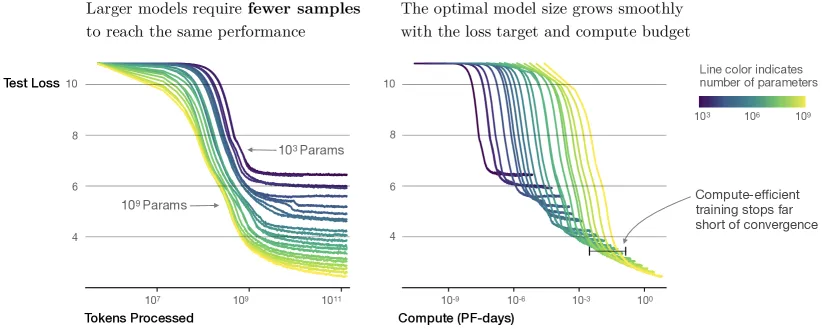
Figure 2: 语言模型训练运行序列,模型从 到 参数
过拟合的普适性
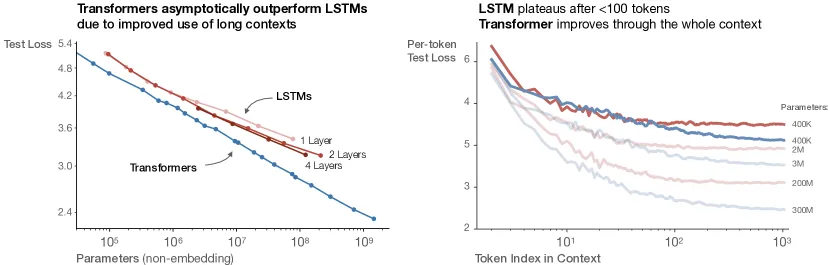
Figure 9: L(N,D) 可预测地依赖于数据集和模型大小
计算量 vs 性能
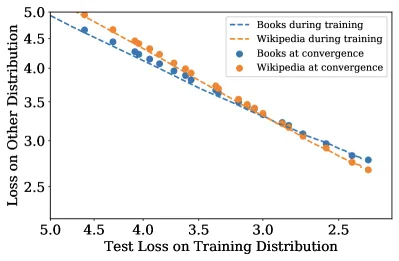
Figure 11: 性能 vs 计算预算或参数更新次数
计算量与数据趋势的矛盾
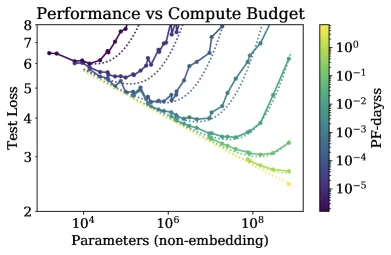
Figure 15: 计算趋势和数据趋势之间的矛盾
关键矛盾: 计算效率最优训练的数据需求()增长远慢于避免过拟合所需的数据增长(),意味着计算效率最优训练最终会面临过拟合问题。
临界批大小
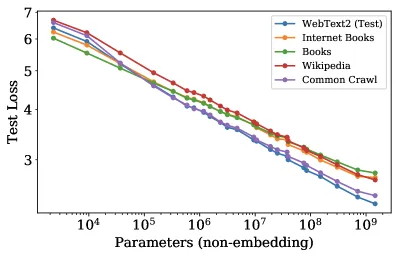
Figure 10: 临界批大小 遵循损失的幂律
六、计算效率最优训练
与训练至收敛的对比
- 计算效率最优训练使用 7.7x 更少的参数更新
- 使用 2.7x 更多的参数
- 使用 65% 更少的计算量
- 达到相同损失水平
最优模型大小的灵活性
- 模型大小在最优值的 0.6x 到 2.2x 范围内,仅增加 20% 计算预算
- 2.2x 更大的模型需要 45% 更少的步数,代价是 20% 更多的训练计算
学习率规则
在 参数时失效。
七、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 幂律缩放定律 | 损失与 N、D、C 呈幂律关系 | 跨越 7 个数量级的实证验证 |
| L(N,D) 组合方程 | 统一模型大小和数据集大小的影响 | 精确拟合,可预测过拟合 |
| 计算效率最优分配 | , | 指导大规模训练资源分配 |
| 临界批大小定律 | 批大小与损失的幂律关系 | |
| 形状无关性 | 性能弱依赖架构细节 | 纵横比变化 40 倍仅 3% 影响 |
| 大模型样本效率 | 大模型更高效 | 相同性能用更少数据和步数 |
八、已知局限性
- 缺乏理论理解: 没有对任何缩放定律的坚实理论解释
- B_crit 外推不确定: 对探索范围外的值不太自信
- 小数据 regime: 未深入研究(D 减少 1024x 时拟合不佳)
- 未实验正则化和数据增强: 可能影响缩放行为
- 计算估计: C ~ 6NBS 未包含与 n_ctx 成比例的贡献
- 可能遗漏某些超参数: 如初始化 scale 或 momentum
- 学习率敏感性: 最优学习率对目标损失敏感,未实验短训练的更大学习率
九、历史影响
这篇论文是 LLM 时代最具影响力的论文之一:
- 直接催生了 GPT-3: 基于这些缩放定律,OpenAI 训练了 175B 参数的 GPT-3
- Chinchilla 定律: Hoffmann et al. (2022) 后续修正了最优数据-模型比例
- 计算预算分配范式: 成为所有大规模 LLM 训练的标准参考
- “大力出奇迹” 理论基础: 为 scale 提供了科学依据
十、总结
核心贡献
- 发现语言模型损失与 N、D、C 之间的幂律缩放定律,跨越七个数量级
- 推导出 L(N,D) 和 L(N,S) 组合方程,可精确预测过拟合和训练动态
- 给出计算效率最优的资源分配策略:,
- 证明大模型比小模型更样本高效,收敛训练是低效的
- 预测临界交汇点: 参数, nats/token
技术影响
- 为整个 LLM 扩展运动提供了理论基础
- 改变了 AI 研究社区对模型规模和数据规模的认知
- 直接指导了 GPT-3、PaLM、LLaMA 等后续大模型的训练策略
- 启发了 Chinchilla 定律等后续研究
适用场景
- 大规模语言模型训练的资源规划
- 计算预算分配优化
- 模型大小 vs 数据量的权衡决策
- 预测更大规模模型的性能
十一、参考资源
- 论文: arXiv:2001.08361
- 主题: cs.LG, stat.ML
- 关键引用: GPT-2 (Radford et al., 2019), Chinchilla (Hoffmann et al., 2022)