Attention Is All You Need
Transformer 架构的开创性工作 - 纯注意力机制的序列转导模型
Attention Is All You Need
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Attention Is All You Need |
| 作者 | Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, Illia Polosukhin |
| 机构 | Google Brain, Google Research, University of Toronto |
| 论文 | arXiv:1706.03762 |
| 发布 | 2017年6月12日 |
| 代码 | tensor2tensor |
二、核心思想
问题定义
主流的序列转导模型基于复杂的循环神经网络(RNN)或卷积神经网络(CNN),包含编码器和解码器。这些模型存在关键瓶颈:
- 循环结构的顺序计算限制:RNN 按时间步顺序计算,无法并行化,训练效率低
- 长距离依赖学习困难:信号需要经过 步才能传播到任意位置
- 计算效率低:循环层的计算复杂度为
解决方案概述
本文提出 Transformer 架构,完全基于注意力机制,摒弃循环和卷积:
- 纯注意力机制:使用自注意力(Self-Attention)替代循环层
- 高度并行化:所有位置可并行计算,显著提升训练速度
- 常数路径长度:任意两个位置之间的路径长度为 ,便于学习长距离依赖
核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 多头自注意力 | 并行的注意力头,每个关注不同表示子空间 | 捕获多维度依赖关系 |
| 位置编码 | 正弦/余弦函数注入位置信息 | 无需循环即可感知序列顺序 |
| 缩放点积注意力 | 防止梯度消失 | 稳定训练 |
| 残差连接 + 层归一化 | 每个子层的输出为 LayerNorm(x + Sublayer(x)) | 稳定深层网络训练 |
三、技术架构
模型架构
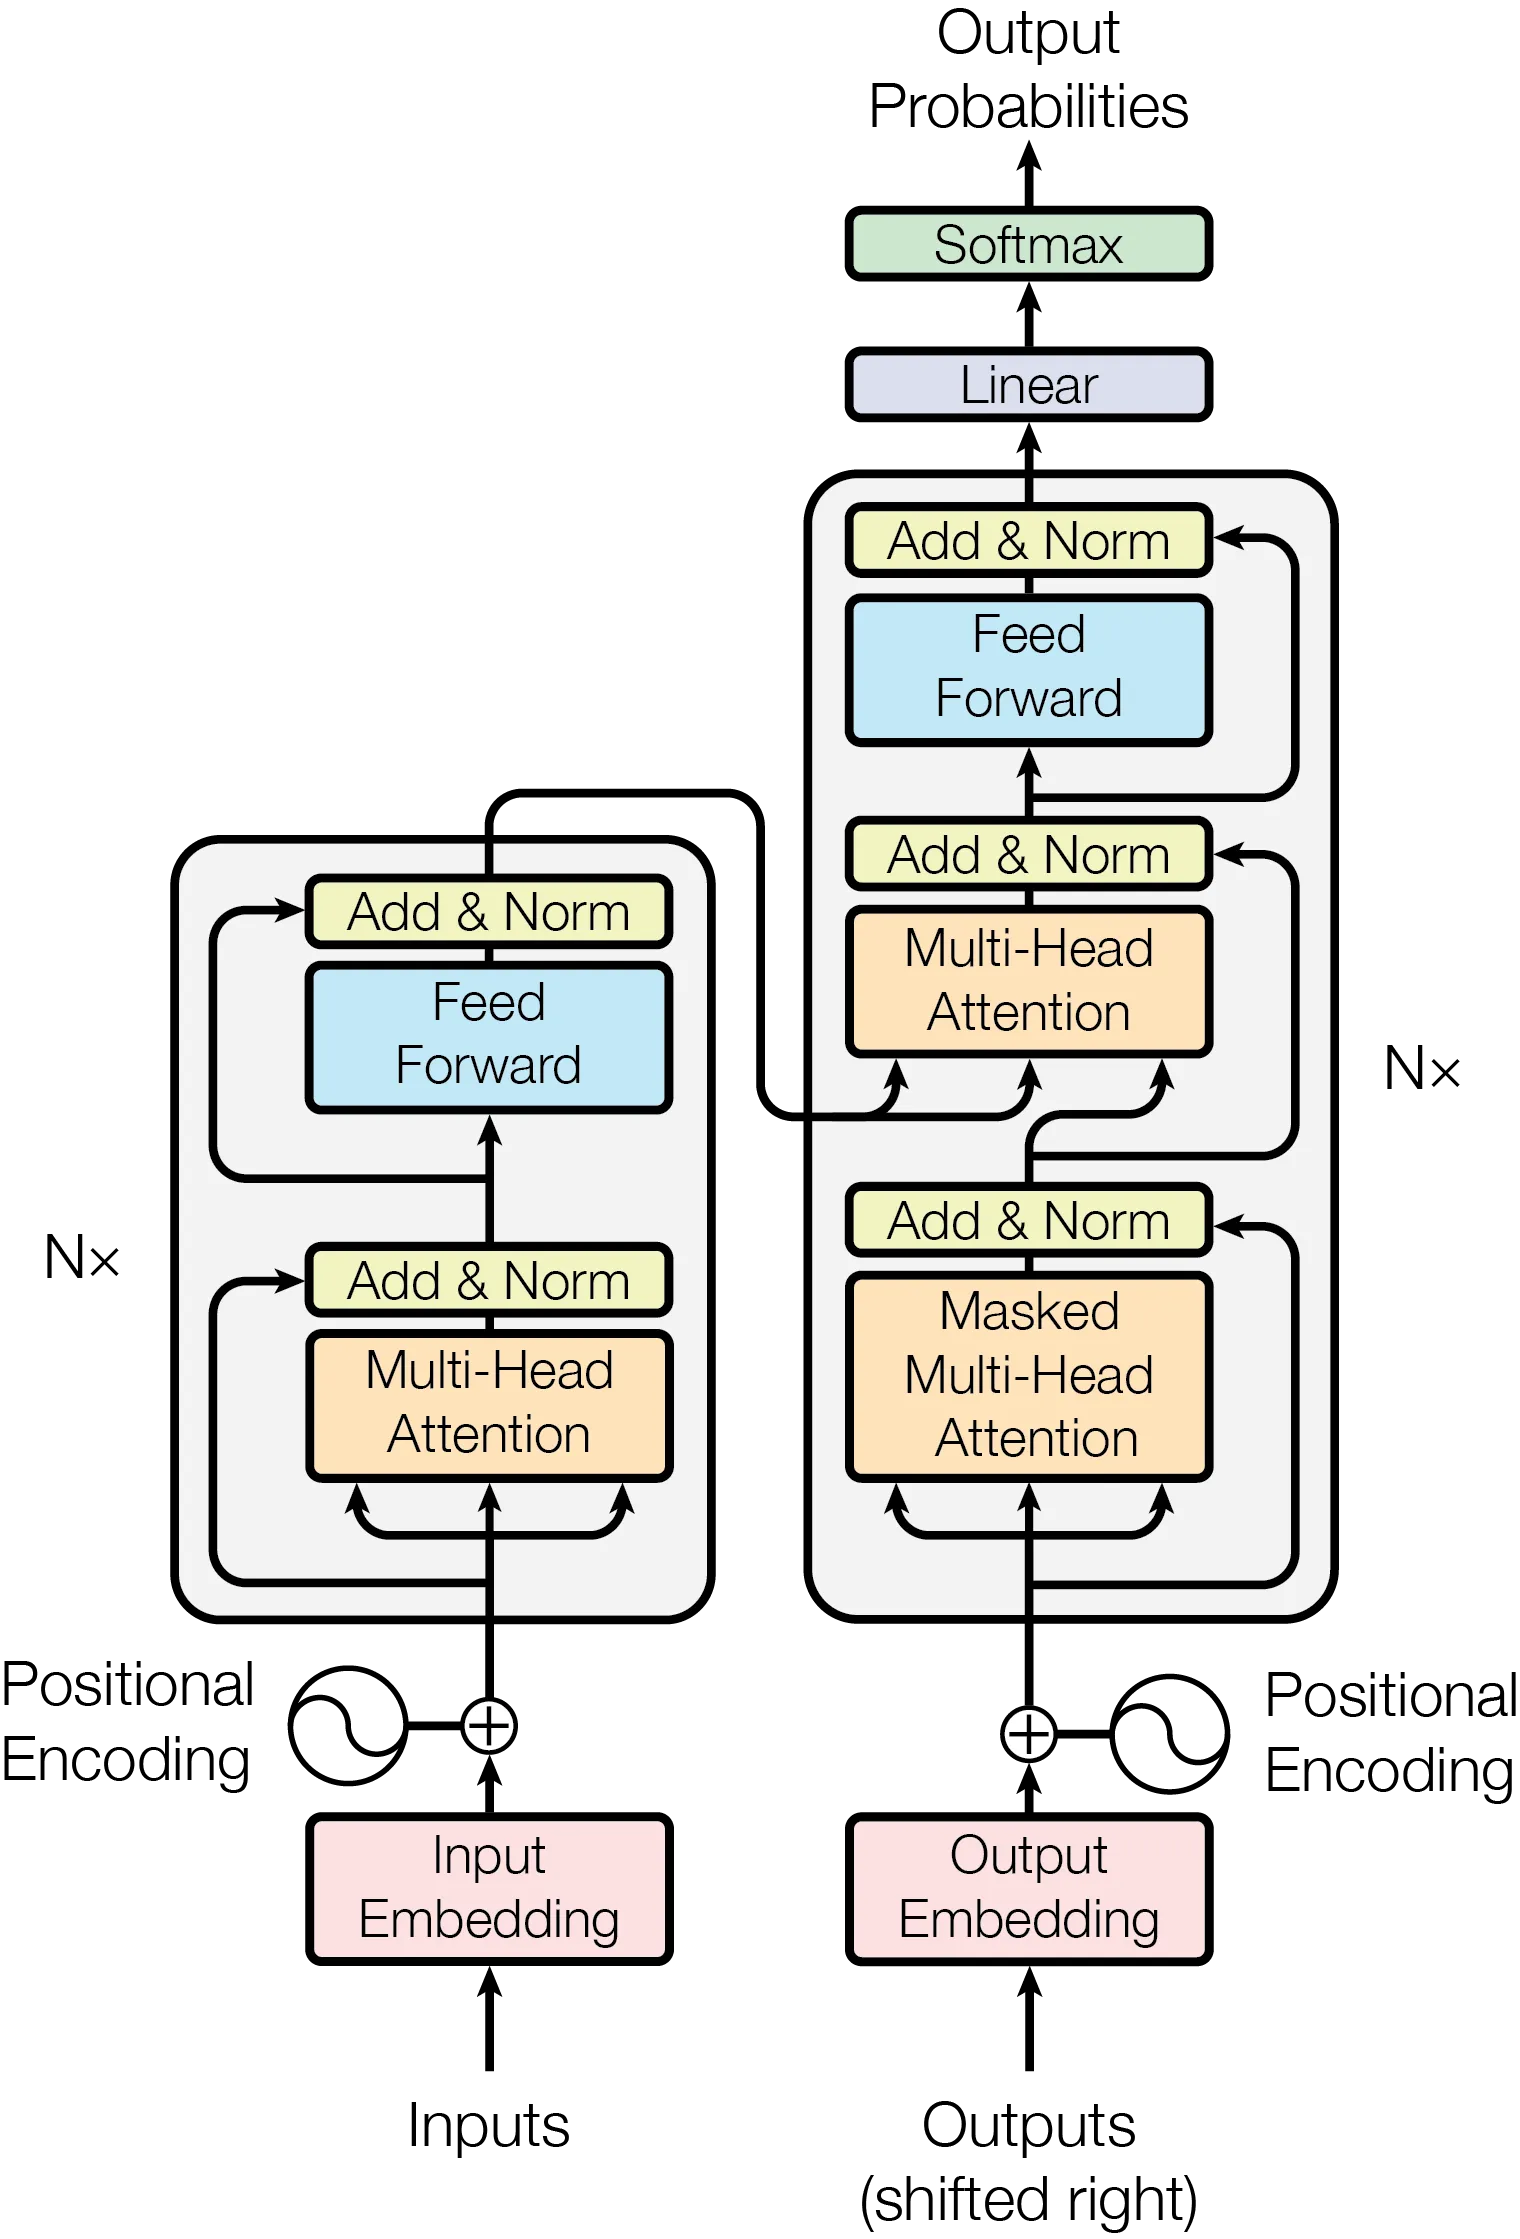
整体框架:
- 编码器: 层堆叠,每层包含多头自注意力 + 位置前馈网络
- 解码器: 层堆叠,每层包含掩码多头自注意力 + 编码器-解码器注意力 + 位置前馈网络
- 所有子层:输出维度
注意力机制图解
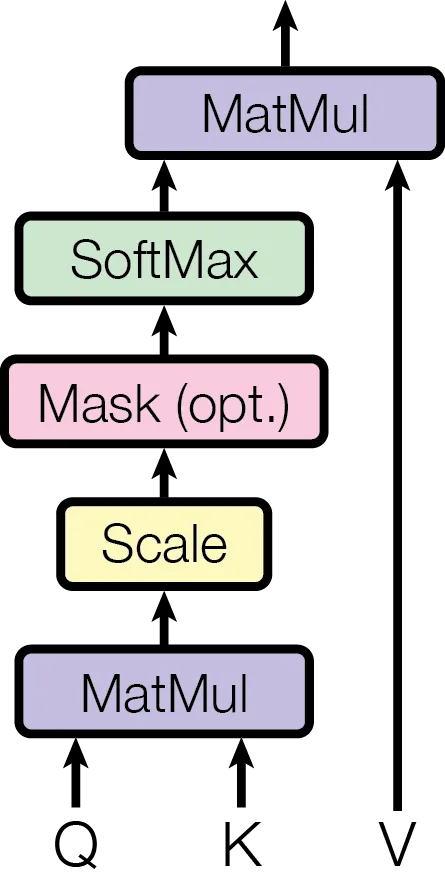
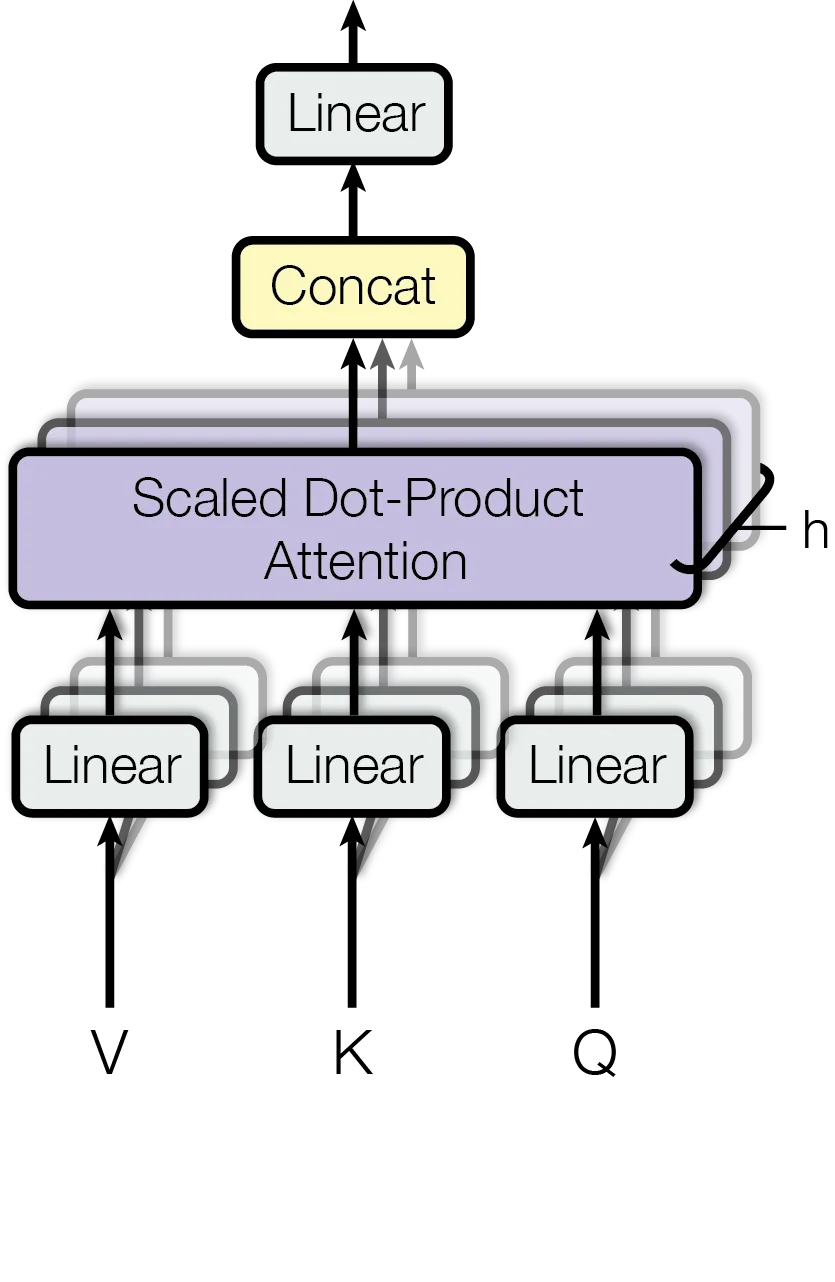
核心公式
1. 缩放点积注意力(Scaled Dot-Product Attention):
- 缩放因子 防止点积过大导致 softmax 梯度消失
- 比加法注意力更快、更节省空间(可利用高效矩阵乘法)
2. 多头注意力(Multi-Head Attention):
- 使用 个并行注意力头
- 每个头的维度
- 允许模型同时关注不同表示子空间的信息
3. 位置前馈网络(Position-wise FFN):
- 输入/输出维度:
- 内层维度:
- 等价于两个核大小为 1 的卷积
4. 位置编码(Positional Encoding):
- 波长从 到 的几何级数
- 对任意固定偏移 , 可表示为 的线性函数
- 允许模型外推到比训练时更长的序列
5. 学习率调度(Warmup + Inverse Square Root):
- 前 步线性增加学习率
- 之后按步数的平方根倒数递减
注意力机制的三种应用
| 类型 | 查询来源 | 键/值来源 | 作用 |
|---|---|---|---|
| 编码器自注意力 | 编码器前一层输出 | 编码器前一层输出 | 捕获输入序列内部依赖 |
| 解码器掩码自注意力 | 解码器前一层输出 | 解码器前一层输出(掩码未来位置) | 保持自回归特性 |
| 编码器-解码器注意力 | 解码器前一层输出 | 编码器输出 | 关注输入序列相关信息 |
模型配置
| 参数 | 基础模型 | 大模型 |
|---|---|---|
| 层数 N | 6 | 6 |
| 512 | 1024 | |
| 2048 | 4096 | |
| 注意力头数 h | 8 | 16 |
| 64 | 64 | |
| Dropout | 0.1 | 0.3 |
| 标签平滑 | 0.1 | 0.1 |
| 参数量 | 65M | 213M |
| 训练步数 | 100K | 300K |
| 训练时间 | 12 小时 | 3.5 天 |
四、自注意力 vs 循环 vs 卷积
| 特性 | 自注意力 | 循环 | 卷积 |
|---|---|---|---|
| 每层复杂度 | |||
| 顺序操作数 | |||
| 最大路径长度 |
关键优势:
- 当 时(通常成立),自注意力比循环层更快
- 路径长度为常数,最利于学习长距离依赖
- 完全并行化,训练效率最高
五、实验结果
WMT’14 机器翻译任务
数据集:
- English-to-German:450 万句对,37K BPE 词汇
- English-to-French:3600 万句对,32K word-piece 词汇
训练硬件:8 × NVIDIA P100 GPUs
BLEU 分数对比
| 模型 | EN-DE | EN-FR | 训练成本 (FLOPs) |
|---|---|---|---|
| ByteNet | 23.75 | - | - |
| Deep-Att + PosUnk | - | 39.2 | |
| GNMT + RL | 24.6 | 39.92 | |
| ConvS2S | 25.16 | 40.46 | |
| MoE | 26.03 | 40.56 | |
| GNMT + RL Ensemble | 26.30 | 41.16 | |
| ConvS2S Ensemble | 26.36 | 41.29 | |
| Transformer (base) | 27.3 | 38.1 | |
| Transformer (big) | 28.4 | 41.8 |
关键发现:
- Transformer (big) 在 EN-DE 上超越所有集成模型 2+ BLEU
- 训练成本仅为最佳竞争模型的 1/4 ~ 1/10
- 基础模型 12 小时即可超越所有已发表模型
模型变体实验
| 变体 | 变化 | PPL | BLEU |
|---|---|---|---|
| (A) 头数 | h=1, | 5.29 | 24.9 |
| h=4, | 5.00 | 25.5 | |
| h=8, (base) | 4.92 | 25.8 | |
| h=16, | 4.91 | 25.8 | |
| h=32, | 5.01 | 25.4 | |
| (B) 键维度 | 5.16 | 25.1 | |
| 5.01 | 25.4 | ||
| (C) 模型大小 | N=2 | 6.11 | 23.7 |
| N=4 | 5.19 | 25.3 | |
| 4.66 | 26.0 | ||
| 4.75 | 26.2 | ||
| (D) Dropout | 5.77 | 24.6 | |
| 4.95 | 25.5 | ||
| (E) 位置编码 | 学习的位置嵌入 | 4.92 | 25.7 |
关键发现:
- 单头注意力比最佳设置差 0.9 BLEU
- 减小 损害性能,说明兼容性计算不简单
- 更大的模型更好,Dropout 对防止过拟合至关重要
- 正弦位置编码与学习的位置嵌入效果几乎相同
英语成分句法分析
| 解析器 | 训练数据 | WSJ 23 F1 |
|---|---|---|
| Petrov et al. (2006) | WSJ only | 90.4 |
| Dyer et al. (2016) | WSJ only | 91.7 |
| Transformer (4 layers) | WSJ only | 91.3 |
| Transformer (4 layers) | semi-supervised | 92.7 |
| Dyer et al. (2016) | generative | 93.3 |
关键发现:
- Transformer 良好泛化到句法分析任务
- 仅用 WSJ 40K 句子训练即超越 Berkeley-Parser
- 无需任务特定调优即可获得竞争力结果
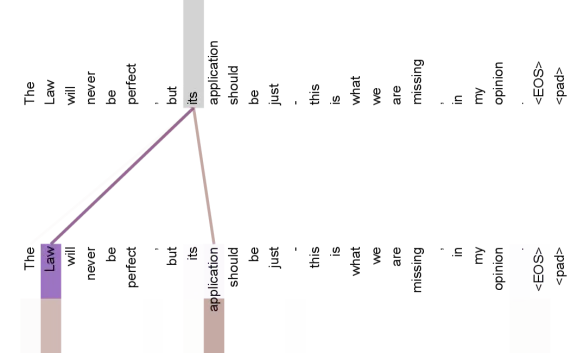
注意力可视化
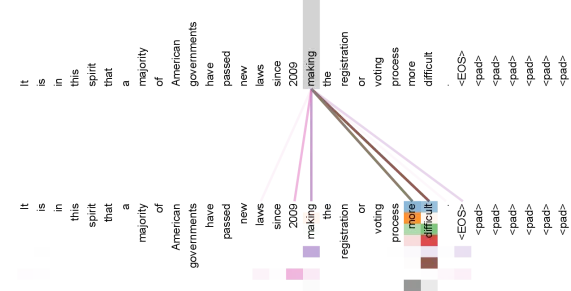
观察:注意力头学会了追踪动词 “making” 的长距离依赖,完成 “making…more difficult” 短语。
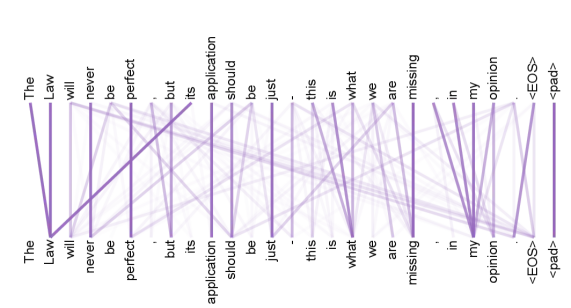
观察:注意力头5专门用于指代消解,如 “its” 的注意力非常尖锐地指向正确的先行词。
观察:注意力头6同样显示出指代消解行为,在不同结构中追踪名词性成分的关系。
句法结构可视化
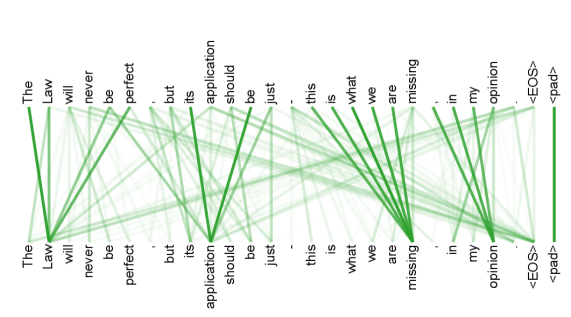
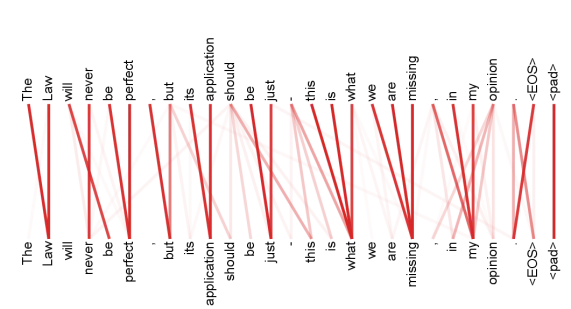
观察:多个注意力头表现出与句子结构相关的行为,不同头学习执行不同的句法任务,如依存关系和短语边界检测。
六、与前序工作的对比
| 方法 | 架构 | 关键限制 | Transformer 如何解决 |
|---|---|---|---|
| Seq2Seq (Sutskever 2014) | LSTM 编码器-解码器 | 固定向量瓶颈 | 自注意力直接连接所有位置 |
| Bahdanau Attention (2014) | RNN + 注意力 | 仍有循环结构 | 完全消除循环 |
| ConvS2S (2017) | CNN 编码器-解码器 | 路径长度 | 路径长度 |
| ByteNet (2017) | 膨胀 CNN | 路径长度 | 路径长度 |
| Extended Neural GPU (2016) | 循环 + 注意力 | 复杂架构 | 简单统一的注意力架构 |
七、总结
核心贡献
- Transformer 架构:首个完全基于注意力的序列转导模型,摒弃循环和卷积
- 多头自注意力:并行关注不同表示子空间,捕获多维度依赖
- 位置编码:正弦/余弦函数优雅地注入位置信息
- 训练效率:12 小时(基础模型)/ 3.5 天(大模型)即可达到 SOTA
- 泛化能力:在机器翻译和句法分析任务上均表现出色
技术影响
- 现代 NLP 基础:BERT、GPT、T5 等所有大语言模型的基础架构
- 跨领域扩展:Vision Transformer (ViT)、音频 Transformer、多模态 Transformer
- 注意力机制标准化:自注意力成为深度学习的核心组件
- 并行化范式:改变了深度学习模型的训练方式
局限性
- 自注意力复杂度为 ,对超长序列计算量大
- 缺乏显式的序列建模归纳偏置(如 RNN 的顺序性)
- 位置编码的外推能力有限
- 论文未探索超过几千 token 的序列长度
八、参考资源
- 论文: arXiv:1706.03762
- 代码: tensor2tensor
- 关键引用:
- 注意力机制 [Bahdanau et al., 2014]
- LSTM [Hochreiter & Schmidhuber, 1997]
- 残差网络 [He et al., 2016]
- 层归一化 [Ba et al., 2016]
- Adam 优化器 [Kingma & Ba, 2015]---
分析日期: 2026-07-03