Sequence to Sequence Learning with Neural Networks
端到端序列到序列学习的开创性工作
Sequence to Sequence Learning with Neural Networks
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Sequence to Sequence Learning with Neural Networks |
| 作者 | Ilya Sutskever, Oriol Vinyals, Quoc V. Le |
| 机构 | |
| 论文 | arXiv:1409.3215 |
| 发布 | 2014年9月10日 |
二、核心思想
问题定义
深度神经网络(DNNs)在许多任务上表现出色,但无法直接处理输入和输出序列长度不同的问题。许多重要问题(如语音识别、机器翻译、问答系统)本质上是序列到序列的映射,需要一种通用的方法来处理变长序列。
解决方案概述
本文提出一种通用的端到端序列学习方法:
- 编码器(Encoder):使用多层 LSTM 将输入序列读取为固定维度的向量
- 解码器(Decoder):使用另一个深层 LSTM 从该向量解码出目标序列
- 关键技巧:反转输入句子顺序,显著提升性能
核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 端到端 Seq2Seq 架构 | 编码器-解码器框架,最小化对序列结构的假设 | 通用序列学习 |
| 深层 LSTM | 4 层 LSTM,每层 1000 个单元 | 显著优于浅层 |
| 反转输入句子 | 源句子反转,目标句子不变 | BLEU 从 25.9 提升到 30.6 |
| 8 GPU 并行化 | 每层 LSTM 分配到不同 GPU | 训练速度 6300 词/秒 |
三、技术架构
模型架构
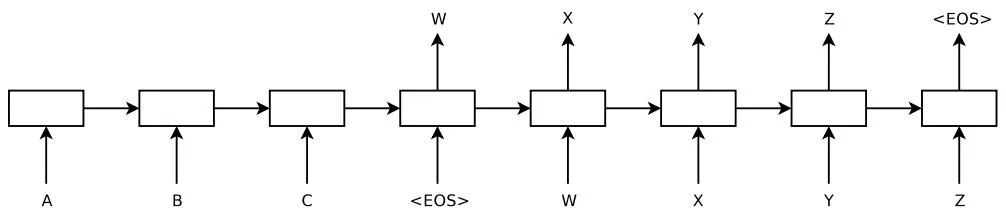
核心思想:
- 编码器 LSTM 逐时间步读取输入序列,最终隐藏状态作为句子表示
- 解码器 LSTM 以该表示为初始状态,生成目标序列
- 每个句子以
<EOS>结尾,使模型能处理任意长度序列
核心公式
条件概率建模:
其中 是编码器 LSTM 最后一个隐藏状态,即输入序列的固定维度表示。
标准 RNN 方程:
模型配置
| 参数 | 值 |
|---|---|
| LSTM 层数 | 4 层 |
| 每层单元数 | 1000 |
| 词嵌入维度 | 1000 |
| 输入词汇量 | 160,000 |
| 输出词汇量 | 80,000 |
| 句子表示维度 | 8000 |
| 总参数量 | 384M |
| 循环连接参数 | 64M(编码器 32M + 解码器 32M) |
训练细节
| 参数 | 值 |
|---|---|
| 优化器 | SGD(无动量) |
| 初始学习率 | 0.7 |
| 学习率调度 | 5 个 epoch 后每半个 epoch 减半 |
| 总训练轮数 | 7.5 epochs |
| 批次大小 | 128 |
| 梯度裁剪 | 阈值 5.0 |
| 参数初始化 | 均匀分布 [-0.08, 0.08] |
反转输入句子的原理
关键发现:反转源句子后,测试困惑度从 5.8 降到 4.7,BLEU 从 25.9 提升到 30.6。
原理分析:
- 正常情况下,源句子的每个词距离对应的目标词很远(大时间滞后)
- 反转后,源句子开头的词与目标句子开头的词距离很近
- 引入大量短期依赖,使优化问题更容易
- SGD 更容易建立源和目标之间的”通信”
四、实验结果
WMT’14 English-to-French 翻译任务
数据集:
- 训练集:12M 句子对(348M 法语词 + 304M 英语词)
- 来源:WMT’14 数据集的”selected”子集
直接翻译结果
| 方法 | BLEU 分数 |
|---|---|
| Bahdanau et al. [2] | 28.45 |
| 基线 SMT 系统 [29] | 33.30 |
| 单个正向 LSTM,beam=12 | 26.17 |
| 单个反转 LSTM,beam=12 | 30.59 |
| 5 个反转 LSTM 集成,beam=1 | 33.00 |
| 2 个反转 LSTM 集成,beam=12 | 33.27 |
| 5 个反转 LSTM 集成,beam=2 | 34.50 |
| 5 个反转 LSTM 集成,beam=12 | 34.81 |
重评分结果
| 方法 | BLEU 分数 |
|---|---|
| 基线 SMT 系统 | 33.30 |
| Cho et al. [5] | 34.54 |
| 最佳 WMT’14 结果 [9] | 37.0 |
| 单个正向 LSTM 重评分 | 35.61 |
| 单个反转 LSTM 重评分 | 35.85 |
| 5 个反转 LSTM 集成重评分 | 36.5 |
长句子性能
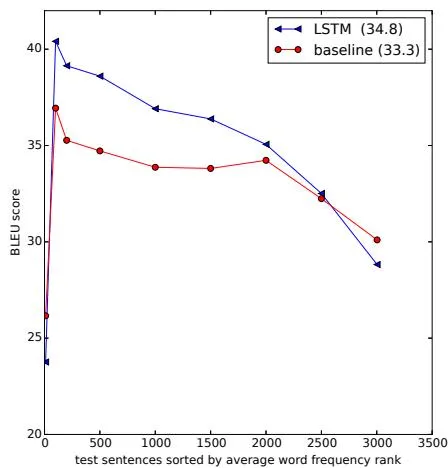
关键发现:LSTM 在长句子上表现良好,这与之前研究者的经验不同。反转输入句子使 LSTM 能更好地处理长句子。
句子表示分析
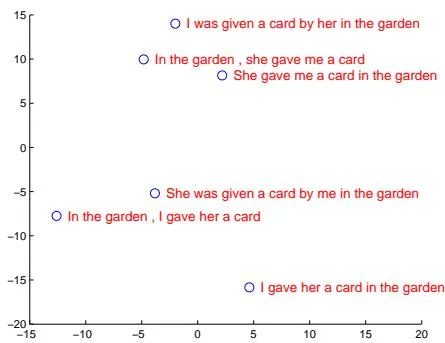
观察结果:
- LSTM 学到的句子表示对词序敏感
- 对主动/被动语态相对不变
- 语义相似的句子在向量空间中聚集
- 二维 PCA 投影显示清晰的语义聚类
五、并行化策略
8 GPU 并行化方案
- 层间并行:每个 LSTM 层分配到不同 GPU(共 4 层)
- softmax 并行:剩余 4 个 GPU 用于并行化 softmax 计算
- 通信:激活值在层间即时传递
- 性能:6300 词/秒(英语和法语),训练约 10 天
六、相关工作
| 方法 | 与本文关系 |
|---|---|
| Kalchbrenner & Blunsom [18] | 首次将整个输入句子映射到向量 |
| Cho et al. [5] | 相关工作,但仅用于重评分 |
| Graves [10] | 引入可微分注意力机制 |
| Bahdanau et al. [2] | 注意力机制在机器翻译中的应用 |
| CTC [11] | 假设输入输出单调对齐 |
七、总结
核心贡献
- 端到端 Seq2Seq 架构:首个成功应用于大规模机器翻译的端到端神经网络系统
- 反转输入句子技巧:简单但有效的数据变换,显著提升性能
- 超越 SMT 基线:首次证明纯神经翻译系统能大幅超越基于短语的 SMT 系统
- 句子表示学习:LSTM 学到有意义的句子表示,对词序敏感,对语态不变
- 并行化训练:8 GPU 并行化方案,使大规模 LSTM 训练可行
技术影响
- 开创性工作:奠定了编码器-解码器架构的基础,影响了后续所有 Seq2Seq 模型
- 注意力机制的铺垫:为 Bahdanau 等人的注意力机制工作提供了基础
- NLP 革命的起点:开启了神经机器翻译的新时代
- 通用框架:不仅适用于翻译,还可用于任何序列到序列任务
局限性
- 无法处理词汇表外(OOV)单词
- 固定维度向量成为信息瓶颈(后续被注意力机制解决)
- 训练计算量大(需要 8 GPU 训练 10 天)
- 仅在英语-法语翻译任务上验证
八、参考资源
- 论文: arXiv:1409.3215
- 关键引用:
- LSTM [Hochreiter & Schmidhuber, 1997]
- 注意力机制 [Bahdanau et al., 2014]
- 神经语言模型 [Bengio et al., 2003]---
分析日期: 2026-06-07