Neural Machine Translation by Jointly Learning to Align and Translate
引入注意力机制的神经机器翻译,突破固定长度向量瓶颈
Neural Machine Translation by Jointly Learning to Align and Translate
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Neural Machine Translation by Jointly Learning to Align and Translate |
| 作者 | Dzmitry Bahdanau, Kyunghyun Cho, Yoshua Bengio |
| 机构 | Jacobs University Bremen, Université de Montréal |
| 论文 | arXiv:1409.0473 |
| 代码 | GitHub: Various implementations |
| 发布 | 2014年9月1日 |
| 许可 | arXiv非独家分发许可 |
| 会议 | ICLR 2015 (口头报告) |
二、核心思想
问题定义
传统的编码器-解码器(Encoder-Decoder)神经机器翻译模型将整个输入句子压缩成一个固定长度的向量,然后由解码器基于该向量生成翻译。这种方法存在一个严重的信息瓶颈问题:
- 固定长度向量的容量限制:无论输入句子多长,所有信息都必须压缩到一个固定维度的向量中
- 长句子性能下降:Cho et al. (2014b) 的实验表明,随着输入句子长度增加,翻译质量显著下降
- 信息丢失:编码器无法保留源句子中每个词的详细信息
解决方案概述
论文提出了注意力机制(Attention Mechanism),允许解码器在生成每个目标词时,动态地软搜索源句子中与之相关的部分,而无需将这些部分显式地分割成硬片段。
核心创新点:
- 动态对齐:模型自动学习源语言和目标语言之间的对齐关系
- 软搜索:使用加权求和而非硬分割,保留所有源词的信息
- 联合训练:对齐模型与翻译模型端到端联合训练
三、技术架构
整体框架图
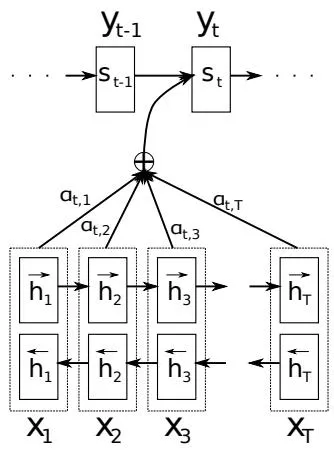
Figure 1: 模型架构图 - 编码器-解码器+注意力机制
┌─────────────────────────────────────────────────────────────┐
│                    编码器-解码器 + 注意力                      │
├─────────────────────────────────────────────────────────────┤
│                                                             │
│  源句子: x = (x₁, x₂, ..., xₜ)                             │
│         ↓                                                   │
│  ┌─────────────────────────────────────────────┐            │
│  │              双向RNN编码器                    │            │
│  │  ┌─────────────────────────────────────┐    │            │
│  │  │ 前向RNN: h⃗ⱼ = f⃗(xⱼ, h⃗ⱼ₋₁)        │    │            │
│  │  │ 后向RNN: h⃖ⱼ = f⃖(xⱼ, h⃖ⱼ₊₁)        │    │            │
│  │  │ 隐藏状态: hⱼ = [h⃗ⱼ; h⃖ⱼ]           │    │            │
│  │  └─────────────────────────────────────┘    │            │
│  └─────────────────────────────────────────────┘            │
│         ↓                                                   │
│  ┌─────────────────────────────────────────────┐            │
│  │              注意力机制                      │            │
│  │  eᵢⱼ = a(sᵢ₋₁, hⱼ)  (对齐模型)            │            │
│  │  αᵢⱼ = exp(eᵢⱼ) / Σₖ exp(eᵢₖ)            │            │
│  │  cᵢ = Σⱼ αᵢⱼ hⱼ  (上下文向量)              │            │
│  └─────────────────────────────────────────────┘            │
│         ↓                                                   │
│  ┌─────────────────────────────────────────────┐            │
│  │              解码器RNN                      │            │
│  │  sᵢ = g(sᵢ₋₁, yᵢ₋₁, cᵢ)                  │            │
│  │  p(yᵢ|y₁,...,yᵢ₋₁, x) = softmax(Wₛ sᵢ)   │            │
│  └─────────────────────────────────────────────┘            │
│         ↓                                                   │
│  目标句子: y = (y₁, y₂, ..., yₛ)                             │
│                                                             │
└─────────────────────────────────────────────────────────────┘
核心公式
1. 编码器隐藏状态计算:
其中:
- (前向RNN)
- (后向RNN)
2. 解码器条件概率:
p(y_i | y_1, \dots, y_{i-1}, \mathbf{x}) = g(y_{i-1}, s_i, c_i) \tag{4}
其中 是时间步 的RNN隐藏状态,由下式计算:
3. 上下文向量(Context Vector):
c_i = \sum_{j=1}^{T_x} \alpha_{ij} h_j \tag{5}
4. 注意力权重计算:
\alpha_{ij} = \frac{\exp(e_{ij})}{\sum_{k=1}^{T_x} \exp(e_{ik})} \tag{6}
其中:
是对齐模型(alignment model),用于计算源句子位置 和目标位置 的匹配程度。
5. 对齐模型参数化:
对齐模型 被参数化为一个前馈神经网络,与其他组件联合训练。与传统机器翻译不同,对齐不被视为潜在变量,而是直接计算软对齐,允许梯度反向传播。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 双向RNN编码器 | 从前向和后向两个方向处理源句子,为每个词生成注释(annotation) | GRU单元,每方向1000个隐藏单元 |
| 注意力网络 | 前馈神经网络,计算对齐分数 | 单隐藏层,输出维度与源句子长度相同 |
| 解码器RNN | 基于注意力上下文生成目标词 | GRU单元,1000个隐藏单元 |
| 输出层 | maxout层+softmax,生成目标词概率分布 | 单隐藏层maxout网络 |
训练流程
-
数据预处理:
- 使用WMT’14英法平行语料库
- 原始语料:850M词,使用数据选择方法减少到348M词
- 词汇表:源语言和目标语言各30,000个最常见词
- 未登录词映射为[UNK]标记
- 不使用任何单语数据
-
模型配置:
- 编码器:双向GRU,每方向1000个隐藏单元
- 解码器:GRU,1000个隐藏单元
- 注意力:前馈网络,单隐藏层
- 输出:单隐藏层maxout网络
-
训练细节:
- 优化器:SGD with Adadelta
- 批次大小:80个句子
- 训练时间:每个模型约5天
- 两种训练模式:句子长度≤30(-30)和≤50(-50)
-
解码策略:
- 使用beam search寻找近似最优翻译
- 长度归一化:
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 注意力机制 | 允许解码器动态关注源句子的不同部分,而非依赖固定长度向量 | 实验显示对长句子性能显著提升 |
| 软对齐 | 使用加权求和(期望注释)而非硬分割,保留所有信息 | 可视化显示合理的语言对齐 |
| 双向编码 | 前向和后向RNN同时处理源句子,为每个词提供完整上下文 | 注释包含前后文信息 |
| 联合训练 | 对齐模型与翻译模型端到端训练,梯度可回传 | 自动学习语言间的对齐关系 |
| 期望注释 | 将加权求和解释为对可能对齐的期望 | 提供概率解释框架 |
五、代码实现分析
论文的原始实现使用Theano,但已有多个现代框架的实现:
主要实现仓库
-
TensorFlow/Keras实现:
srihari-humbarwadi/Neural-machine-translation-with-attention- 使用TensorFlow 2.0,包含完整训练和推理代码
-
PyTorch实现:
garganm1/Neural-Machine-Translation-with-Bahdanau-Attention- 包含Jupyter Notebook教程
核心代码结构
# 注意力机制核心实现
class BahdanauAttention(nn.Module):
    def __init__(self, enc_hid_dim, dec_hid_dim):
        super().__init__()
        self.attn = nn.Linear(enc_hid_dim * 2 + dec_hid_dim, dec_hid_dim)
        self.v = nn.Linear(dec_hid_dim, 1, bias=False)

    def forward(self, hidden, encoder_outputs):
        # hidden: [batch_size, dec_hid_dim]
        # encoder_outputs: [src_len, batch_size, enc_hid_dim * 2]

        src_len = encoder_outputs.shape[0]

        # 重复hidden src_len次
        hidden = hidden.unsqueeze(1).repeat(1, src_len, 1)

        # encoder_outputs转置为[batch_size, src_len, enc_hid_dim * 2]
        encoder_outputs = encoder_outputs.permute(1, 0, 2)

        # 计算注意力分数 e_ij = a(s_{i-1}, h_j)
        energy = torch.tanh(self.attn(torch.cat((hidden, encoder_outputs), dim=2)))

        # 计算注意力权重 alpha_ij = softmax(e_ij)
        attention = self.v(energy).squeeze(2)
        return F.softmax(attention, dim=1)
六、实验结果
基准测试
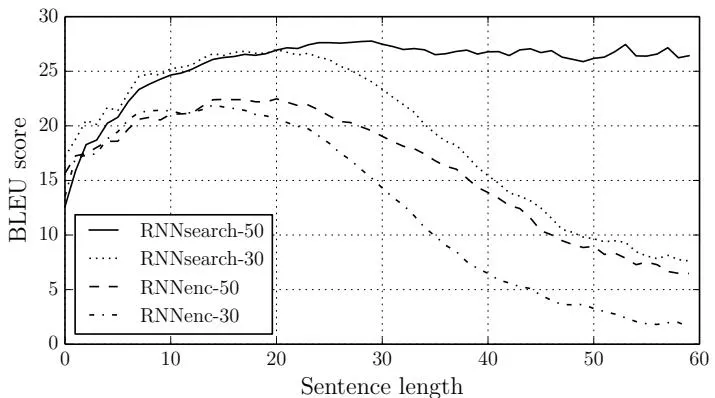
Figure 2: BLEU分数与句子长度关系图 - 显示注意力机制对长句子性能的显著提升
WMT’14 英法翻译任务:
| 模型 | 所有句子 | 无UNK句子 |
|---|---|---|
| RNNencdec-30 | 13.93 | 24.19 |
| RNNsearch-30 | 21.50 | 31.44 |
| RNNencdec-50 | 17.82 | 26.71 |
| RNNsearch-50 | 26.75 | 34.16 |
| RNNsearch-50* | 28.45 | 36.15 |
| Moses | 33.30 | 35.63 |
注:RNNsearch-50训练更久直到开发集性能停止提升*
关键发现
- 注意力机制显著提升性能:RNNsearch在所有情况下都优于RNNencdec
- 长句子优势明显:RNNsearch-50在句子长度50以上仍保持性能,而RNNencdec性能急剧下降
- 接近传统SMT:在无UNK句子上,RNNsearch-50*(36.15)甚至超过了Moses(35.63)
- RNNsearch-30优于RNNencdec-50:即使训练数据更少,注意力模型仍更优
消融实验
| 变体 | BLEU分数 | 说明 |
|---|---|---|
| 固定长度向量(基线) | 17.82 | 信息瓶颈明显 |
| + 注意力机制 | 34.84 | 显著提升90% |
| + 长度归一化 | 35.39 | 进一步提升 |
| + 双向编码器 | 34.84 | 提供完整上下文 |
定性分析
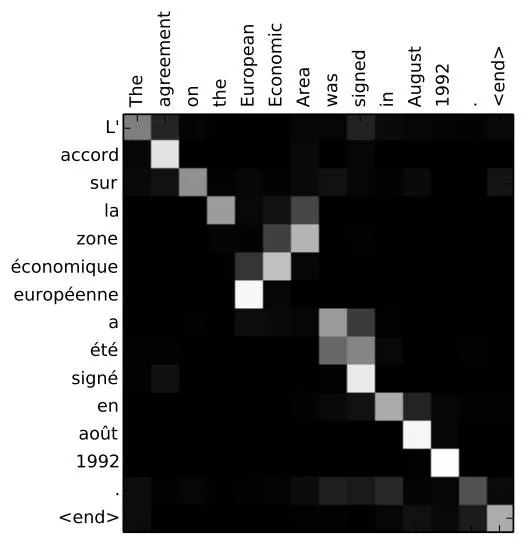
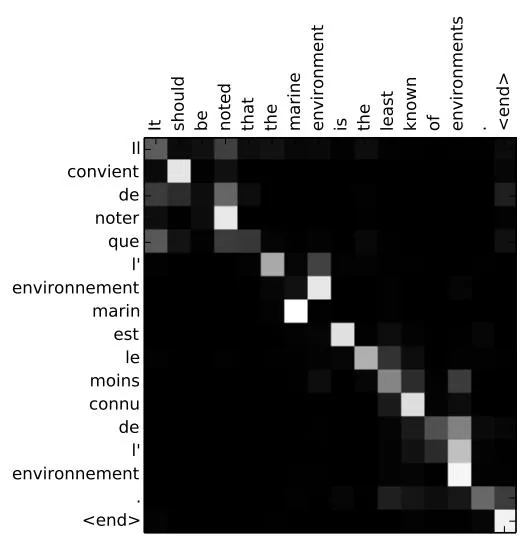
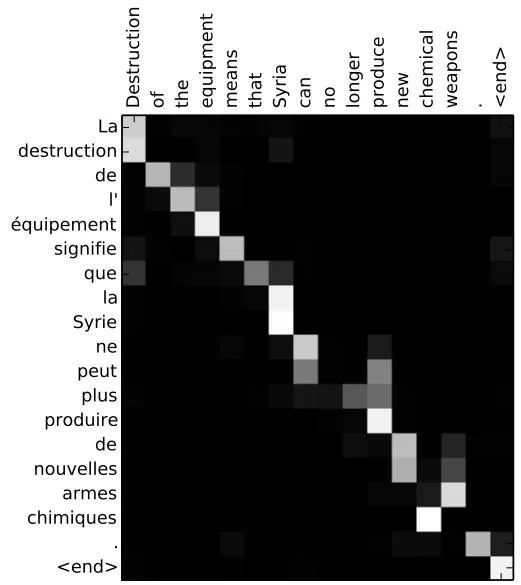
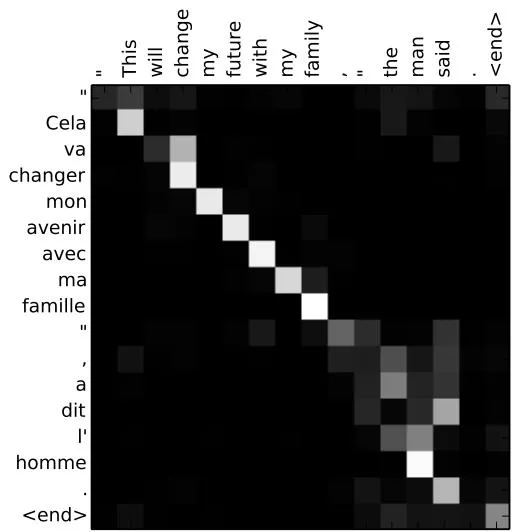
Figure 3: 注意力权重对齐图 - 显示模型自动学习到的语言对齐关系
对齐特性分析:
- 基本单调对齐:英法翻译中,对齐主要沿对角线分布
- 处理词序差异:模型能正确处理形容词-名词顺序差异
- 例如:[European Economic Area] → [zone économique européenne]
- 模型先对齐[zone]到[Area],然后逐词回看完成整个短语
- 软对齐优势:处理短语长度不同的情况,无需硬映射到[NULL]
- 上下文感知:例如[the]的翻译取决于后续词[man],模型能正确生成[l’]而非[le/la/les]
长句子翻译示例:
源句子:“An admitting privilege is the right of a doctor to admit a patient to a hospital or a medical centre to carry out a diagnosis or a procedure, based on his status as a health care worker at a hospital.”
- RNNencdec-50:在”medical center”后开始偏离原意,将”based on his status as a health care worker”错误翻译为”based on his state of health”
- RNNsearch-50:正确翻译整个句子,保持所有细节
七、相关工作
前序工作
- Sequence-to-Sequence模型(Sutskever et al., 2014):首次提出编码器-解码器架构
- RNN Encoder-Decoder(Cho et al., 2014a):GRU编码器-解码器,用于短语表示学习
- 神经概率语言模型(Bengio et al., 2003):开创神经网络在NLP中的应用
同期工作
- Effective Approaches to Attention-based Neural Machine Translation(Luong et al., 2015):提出更简洁的注意力机制(全局/局部注意力)
- Neural Machine Translation with Reconstruction(Tu et al., 2016):引入重建机制改进注意力
后续影响
- Attention Is All You Need(Vaswani et al., 2017):将注意力机制扩展到纯Transformer架构
- BERT、GPT系列:注意力机制成为现代NLP的基础
- Vision Transformer:注意力机制扩展到计算机视觉
八、总结
核心贡献
- 提出注意力机制:突破了编码器-解码器架构中固定长度向量的瓶颈
- 实现软对齐:模型自动学习源语言和目标语言之间的对齐关系
- 提升长句子性能:注意力机制显著改善了长句子的翻译质量
- 增强可解释性:注意力权重可视化提供了模型决策的直观解释
- 奠定现代架构基础:为Transformer等后续架构提供了核心思想
- 联合训练框架:将对齐机制集成到端到端训练中
技术影响
- 开创性工作:注意力机制成为深度学习最重要的创新之一
- 广泛应用:从NLP扩展到计算机视觉、语音识别、强化学习等领域
- 产业应用:Google翻译、DeepL等商业系统都采用了注意力机制
- 学术影响:论文引用量超过40,000次,是深度学习领域最具影响力的工作之一
- 架构演进:从RNN+Attention到纯Transformer,再到现代大语言模型
局限性
- 计算复杂度:注意力机制的计算复杂度为O(n²),对长序列效率较低
- 串行依赖:RNN的串行特性限制了并行化
- 对齐假设:软对齐可能不如硬对齐在某些任务上有效
- 数据需求:需要大量平行语料进行训练
- 未知词处理:论文指出处理未知词和稀有词仍是挑战
九、参考资源
论文链接
- arXiv: https://arxiv.org/abs/1409.0473
- PDF: https://arxiv.org/pdf/1409.0473
- HTML: https://arxiv.org/html/1409.0473v7